
探秘AI大脑:一个语言模型的文件包里到底有什么?
前言
为什么你要知道这些?
如果你想下载并使用一个开源模型(比如Llama、Qwen、DeepSeek),看到这一堆文件别慌——只要保留
.safetensors、.json 配置、tokenizer、vocab.json、merges.txt和LICENSE,其他可以删。如果你想自己微调模型,就主要动那几个分片(但需要强大的显卡)。
如果你只是想聊个天,根本不用打开这个文件夹,用现成的API或者界面就好。
最后记住:这些文件加在一起,就是一个会思考、能对话的数字大脑。虽然它只是一堆二进制数字,但通过巧妙的数学运算,它就能像模像样地和你聊天、写诗、解数学题。
大模型下载地址:https://www.modelscope.cn/models
当你和ChatGPT、Claude这样的AI聊天时,它的大脑——也就是那个巨大的“模型文件”。—> 在电脑里长什么样?我们就用一个真实的模型文件夹为例,像拆开一个神奇的锦囊一样,看看里面那些文件都藏着什么秘密。
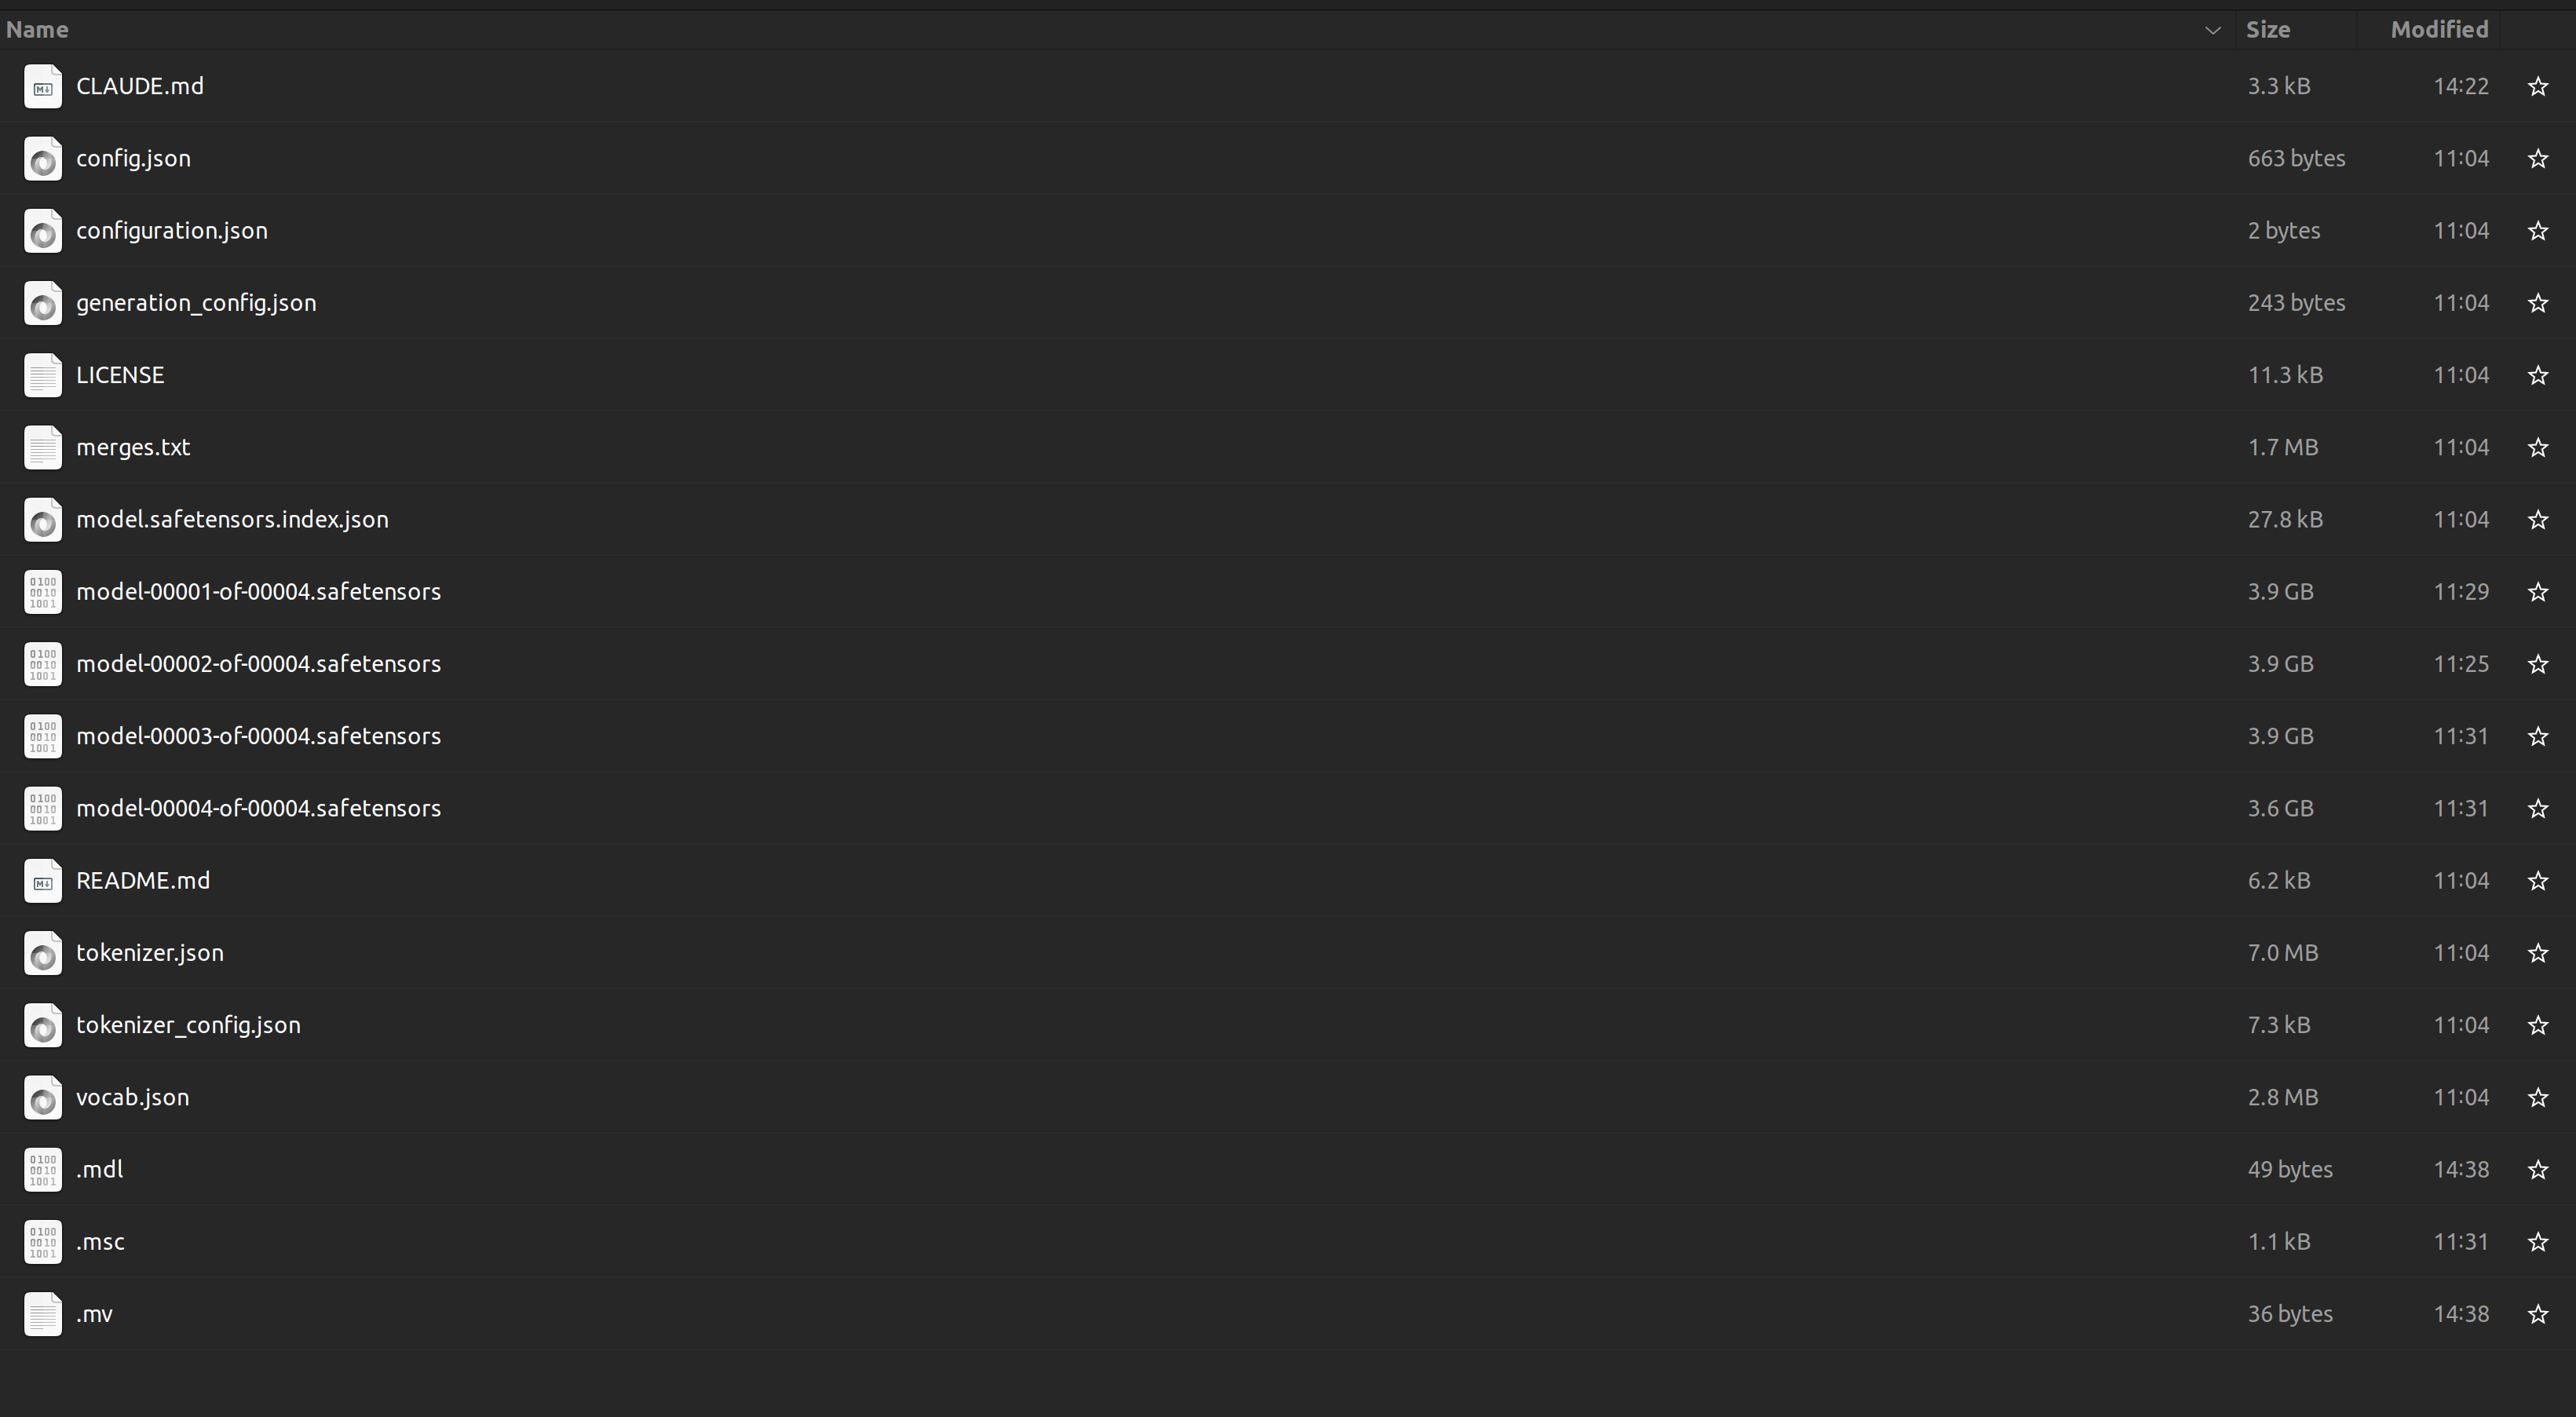
Qwen 2.5B 大模型文件结构参考图
1.模型介绍
1.1 先看“身份证”和“说明书”
大模型文件具体简单介绍,一般模型都有说明书。在下载前应当先浏览查阅该说明书
https://www.modelscope.cn/models/Qwen/Qwen2.5-1.5B-Instruct
- 下载后的文件内容
- 文件说明
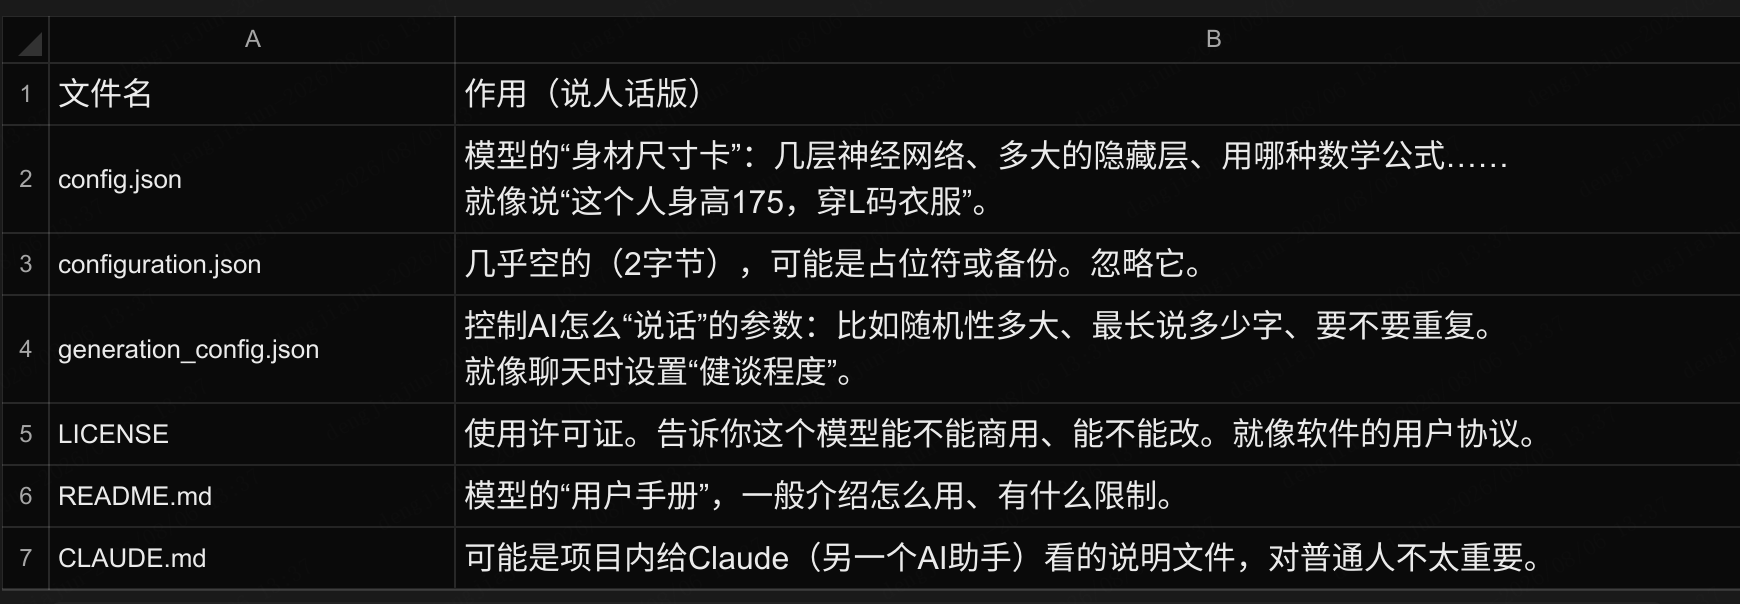
1.2 config.json
{
  "architectures": [
    "Qwen2ForCausalLM"
  ],
  "attention_dropout": 0.0,
  "bos_token_id": 151643,
  "eos_token_id": 151645,
  "hidden_act": "silu",
  "hidden_size": 1536,
  "initializer_range": 0.02,
  "intermediate_size": 8960,
  "max_position_embeddings": 32768,
  "max_window_layers": 21,
  "model_type": "qwen2",
  "num_attention_heads": 12,
  "num_hidden_layers": 28,
  "num_key_value_heads": 2,
  "rms_norm_eps": 1e-06,
  "rope_theta": 1000000.0,
  "sliding_window": 32768,
  "tie_word_embeddings": true,
  "torch_dtype": "bfloat16",
  "transformers_version": "4.43.1",
  "use_cache": true,
  "use_sliding_window": false,
  "vocab_size": 151936
}
架构标识
- architectures: HuggingFace 加载时匹配的模型类 。【
人工智能架构通常由数据层、机器学习框架和算法层、模型层和应用层等多个层次组成】 - model-type: 模型系列标识 qwen2
- transformers_version: 导出时的transformers版本,基于多头注意力机制的人工神经网络架构。
- architectures: HuggingFace 加载时匹配的模型类 。【
模型规模参数
- hidden_size: 1536 — 隐藏层维度,决定每个 token 的向量宽度
- num_hidden_layers: 28 — Transformer 层数(深度)
- num_attention_heads: 12 — 每层的注意力头数(Query 多头)
- num_key_value_heads: 2 — KV 头数,12:2 = 6:1,这是 GQA (Grouped Query Attention),6 个 Q 头共享 1 组 KV,大幅减少 KV cache 显存
- intermediate_size: 8960 — FFN 中间层维度(通常是 hidden_size 的 ~5.8 倍)
- vocab_size: 151936 — 词表大小
激活与归一化
- hidden_act: "silu" — SiLU (Swish) 激活函数
- rms_norm_eps: 1e-06 — RMS LayerNorm 的 epsilon 防除零
位置编码 (RoPE)
- rope_theta: 1000000.0 — RoPE 基频,比 Llama 默认 10000 大 100 倍,适合更长上下文
- max_position_embeddings: 32768 — 最大位置编码长度(32K)
滑动窗口注意力
- sliding_window: 32768 — 滑动窗口大小
- max_window_layers: 21 — 前 21 层使用滑动窗口注意力(局部),后 7 层使用全局注意力
- use_sliding_window: false — 推理时默认关闭,可按需开启
其他 - tie_word_embeddings: true — 输入嵌入层和输出 LM Head 共享权重,节省参数
- torch_dtype: "bfloat16" — 默认推理精度
- attention_dropout: 0.0 — 注意力 dropout(推理时为 0)
- initializer_range: 0.02 — 参数初始化标准差
- bos_token_id / eos_token_id: 151643 / 151645 — 起止 token ID
- use_cache: true — 启用 KV cache 加速自回归生成
2 真正的大脑——“权重weights文件” safetensors
Safetensors is a modern, open-source file format developed by Hugging Face specifically for storing machine learning model weights (tensors)
这几个是最大的文件,好家伙,每个接近4GB!
model-00001-of-00004.safetensorsmodel-00002-of-00004.safetensorsmodel-00003-of-00004.safetensorsmodel-00004-of-00004.safetensorsmodel.safetensors.index.json(模型分片索引,告诉你哪个params在哪个分片partitioning里)
通俗解释:
AI的大脑由几十亿个“数字小旋钮”组成(专业叫“参数” params或“权重” weights)。这些小旋钮的数值决定了AI会怎么回答你。因为旋钮太多(比如70亿个),存下来要十几GB,一个文件装不下,所以切成4块,像分卷压缩包一样。.safetensors是一种安全高效的格式,不会混入恶意代码。
tokenizer.json
作用:以结构化 JSON 形式完整保存分词器的“词汇表”与“合并规则”(适用于 Byte-Pair Encoding、WordPiece、Unigram 等算法)。
包含内容:
词表(vocab):每个 token 及其对应的唯一 ID(例如
"hello": 1234)。合并规则(merges):BPE 等算法如何从字符逐步合并成子词的顺序。
类型和配置:如分词器类型(
"BPE"、"Unigram")、是否添加特殊 token(<unk>、<s>、</s>等)、预分词规则(如按字母、数字、空格分割)。添加的特殊 token 列表及其 ID。
为什么独立为 json 文件:
相比传统的 vocab.json + merges.txt 组合,tokenizer.json 将全部信息聚合在一起,加载更快,且支持更丰富的分词策略(例如 tokenizers 库的原生格式)。模型推理或微调时,直接加载此文件即可重建完整的分词器对象。
2.1 tokenizer_config.json
作用:存储分词器的运行时配置参数,控制其行为(如填充、截断、特殊 token 的对应字符串)。
常见字段:
"add_prefix_space":是否自动在句子开头添加空格(对某些模型如 GPT-2 很重要)。"padding_side"/"truncation_side":默认填充/截断方向(左或右)。"model_max_length":模型支持的最大输入长度。"eos_token"、"bos_token"、"unk_token"、"pad_token":特殊 token 的字符串表示(例如"<|endoftext|>")。"tokenizer_class":指定分词器的类名(如"PreTrainedTokenizerFast"、"LlamaTokenizer"),用于自动加载正确的实现类。"chat_template":对话模板(如适用于apply_chat_template方法的 Jinja 模板)。
与 tokenizer.json 的区别:tokenizer.json 定义“如何切词+映射 ID”,而 tokenizer_config.json 定义“切词后如何处理序列(填充、截断、特殊 token 替换)以及加载哪个类”。两者配合使用才能完整复现训练时的分词行为。
2.2 模型加载使用示例(HuggingFace Transformers)
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen2.5-3B-Instruct"

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

prompt = "Give me a short introduction to large language model."
messages = [
    {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant."},
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
2.3 总结
tokenizer.json:分词器的“硬数据”(词表、合并规则),决定文本如何被切分为 token。tokenizer_config.json:分词器的“软配置”(填充、截断、特殊 token 的字符串形式、聊天模板),用于控制分词器在预处理时的行为。
两个文件缺一不可,共同保证模型在推理或微调时与训练时的分词逻辑完全一致。
3. 几个奇怪的小文件(可能是个人习惯或缓存)
mdl:只有49字节,可能是某个脚本的链接或标记。.msc:1.1KB,也许是一种模型缓存或Meta的某种格式。.mv:36字节,大概率是临时文件或移动命令的记录。
不用管它们——不是模型运行必需的,可能是模型下载或转换过程中留下的“小纸屑”。
4. 模型类型分析实战:以 Qwen2.5-1.5B-Instruct 为例
基于机器基本理论判断框架,我们对 Qwen2.5-1.5B-Instruct 进行全面分析。
4.1 模型基本信息
| 属性 | 值 |
|---|---|
| 模型名称 | Qwen2.5-1.5B-Instruct(千问2.5-1.5B-Instruct) |
| 所属组织 | 千问(Qwen)/ 阿里云 |
| 模型架构 | Qwen2ForCausalLM(decoder-only Transformer) |
| 模型类型标识 | qwen2 |
| 参数量 | 1.54B(非嵌入参数 1.31B) |
| 层数 | 28 层 Transformer |
| 注意力头 | 12 个 Q 头 + 2 个 KV 头(GQA = 6:1) |
| 上下文长度 | 32,768 tokens(生成最长 8,192 tokens) |
| 词表大小 | 151,936 |
| 隐藏层维度 | 1,536 |
| 精度 | bfloat16 |
| 训练阶段 | 预训练(Pretraining)+ 后训练(Post-training / SFT) |
| 基础模型 | Qwen2.5-1.5B(在其之上指令微调) |
| 许可证 | Apache 2.0 |
| 任务标签 | text-generation(文本生成)、chat |
4.2 四维判断
4.2.1 看输出 → 递归模型
Qwen2.5-1.5B-Instruct 的输出是自然语言文本序列——给定一个对话提示,模型逐 token 自回归生成回复文本。
对照第 3.1 节表格:
| 输出类型 | 对应模型类型 | Qwen 的匹配 |
|---|---|---|
| 离散类别/标签 | 分类模型 | ❌ |
| 连续数值 | 拟合模型(回归) | ❌ |
| 分组/簇 | 聚类模型 | ❌ |
| 序列(文本/时间序列) | 递归模型 | ✅ |
结论:输出是文本序列 → 递归模型
4.2.2 看训练数据 → 监督学习
Qwen2.5-1.5B-Instruct 的训练分为两个阶段:
- 预训练(Pretraining):在海量无标注文本上做自监督学习(next-token prediction),此时输入是前文,标签是下一个 token。
- 指令微调(Instruction Tuning / SFT):在有标签的 instruction-response 数据对上做监督微调,输入 X = 用户指令,输出 y = 期望回复。
对照第 3.2 节表格:
| 数据特征 | 对应类型 | 匹配 |
|---|---|---|
| 有标签 y | 监督学习 | ✅(SFT 阶段) |
| 无标签 | 无监督学习 | ✅(预训练阶段) |
| 有奖励信号 | 强化学习 | ❌(Instruct 版未使用 RLHF) |
结论:训练数据混合了自监督预训练 + 监督微调 → 监督学习
4.2.3 看核心算法 → Transformer(递归模型)
从 config.json 和 README 中提取的架构信息:
{
  "architectures": ["Qwen2ForCausalLM"],
  "model_type": "qwen2",
  "hidden_size": 1536,
  "num_hidden_layers": 28,
  "num_attention_heads": 12,
  "num_key_value_heads": 2,
  "intermediate_size": 8960,
  "hidden_act": "silu",
  "vocab_size": 151936,
  "max_position_embeddings": 32768
}
核心技术栈解读:
| 技术组件 | 作用 | 所属范式 |
|---|---|---|
| Transformer Decoder | 自回归生成架构,每个 token 只能看到前面的 token(causal mask) | 递归模型 |
| RoPE(旋转位置编码) | 将位置信息注入 attention 计算,rope_theta=1000000,支持 32K 长上下文 | 序列建模 |
| GQA(分组查询注意力) | 12 个 Q 头共享 2 个 KV 头(6:1),大幅减少 KV cache 显存 | 注意力优化 |
| SwiGLU 激活 | FFN 中间层使用 SiLU 门控 + 线性投影,提升非线性表达能力 | FFN 层 |
| RMSNorm | 前置 LayerNorm,比传统 LayerNorm 更快 | 归一化 |
| Tied Word Embeddings | 输入嵌入层和输出 LM Head 共享权重,节省 ~200M 参数 | 参数复用 |
对照第 3.3 节表格:
| 算法名 | 模型类型 | 一句话识别 |
|---|---|---|
| RNN、LSTM、GRU、Transformer | 递归模型 | 处理序列数据,有「记忆」结构 |
结论:核心算法是 Transformer Decoder → 递归模型
4.2.4 看评估指标 → 递归模型(NLP 方向)
Qwen2.5 官方评估采用的指标包括:
- 困惑度(Perplexity, PPL):衡量语言模型对测试集的预测能力,值越低越好。
- 基准测试分数:MMLU、HumanEval、GSM8K、C-Eval 等下游任务准确率。
- 指令遵循能力:IFEVAL、MT-Bench 等对话质量评估。
对照第 3.4 节表格:
| 看到这些指标 | 模型类型 |
|---|---|
| Accuracy、Precision、Recall、F1、AUC | 分类模型 |
| MSE、MAE、R² | 拟合/递归模型 |
| 轮廓系数、CH Index、ARI | 聚类模型 |
| BLEU、ROUGE、困惑度(Perplexity) | 递归模型(NLP 方向) ✅ |
| 基准测试准确率 | 下游任务评估(跨类别) |
结论:核心评估指标为 Perplexity + NLP 基准测试 → 递归模型(NLP 方向)
4.3 综合判定
按照第 3.5 节的快速判断流程图:
模型的输出是?
  ├─ 类别/标签 ──→ 分类模型
  ├─ 连续数值 ──→ 是序列数据吗?
  │                 ├─ 是 ──→ 递归模型  ← Qwen 在这!
  │                 └─ 否 ──→ 拟合模型(回归)
  └─ 分组/簇   ──→ 聚类模型
最终结论:Qwen2.5-1.5B-Instruct 属于「递归模型」
四个维度交叉验证:
| 维度 | 判定结果 | 置信度 |
|---|---|---|
| 看输出 | 文本序列 → 递归模型 | ★★★★★ |
| 看训练数据 | 有标签 → 监督学习 | ★★★★★ |
| 看核心算法 | Transformer Decoder → 递归模型 | ★★★★★ |
| 看评估指标 | Perplexity、BLEU → 递归模型(NLP) | ★★★★☆ |
一句话总结:Qwen2.5-1.5B-Instruct 是一个基于 Transformer Decoder 架构的自回归语言模型,在机器学习分类体系中归属于递归模型(Recursive Model),采用监督学习方式训练,输出自然语言文本序列,主要评估指标为困惑度(Perplexity)和下游 NLP 基准测试准确率。
4.4 与博客分析框架的对应关系
对照博客《探秘AI大脑》中 config.json 的分析框架:
| 博客分析维度 | config.json 字段 | Qwen2.5-1.5B-Instruct |
|---|---|---|
| 架构标识 | architectures | Qwen2ForCausalLM |
| 模型系列 | model_type | qwen2 |
| 隐藏层维度 | hidden_size | 1,536 |
| 层数 | num_hidden_layers | 28 |
| 注意力头数 | num_attention_heads | 12(Q)/ 2(KV)= GQA |
| 词表大小 | vocab_size | 151,936 |
| 激活函数 | hidden_act | silu(SiLU/Swish) |
| 位置编码 | rope_theta | 1,000,000(RoPE,支持长上下文) |
| 最大位置 | max_position_embeddings | 32,768(32K) |
| 滑动窗口 | sliding_window | 32,768 |
| 权重共享 | tie_word_embeddings | true |
| 推理精度 | torch_dtype | bfloat16 |
从 config.json 可以直接读出模型架构本质:它是一个 decoder-only 的 Transformer 模型,属于语言模型家族中的 Causal LM(因果语言模型),在 ML 分类中属于递归模型。