
Locust Agent 开发 (todo list)
2026/9/19大约 8 分钟
Locust Agent 开发 (todo list)
前言
从零搭建一个基于 Locust 的智能性能诊断 Agent,旨在解决传统性能测试中“指标孤立、排查链路长、依赖专家经验”的痛点。
该 Agent 的核心目标是:自动联动 Locust 发压端与被测服务器监控端,利用 LLM(大语言模型)的推理与工具调用(Function Calling)能力,实现“发压-监控-诊断-根因分析”的全链路自动化。
以下是该工具的技术选型方案与系统详细实现方案:
一、技术选型方案
为了保证与 Locust(基于 Python)的无缝集成,并利用成熟的 AI Agent 框架,整体技术栈深度绑定 Python 生态。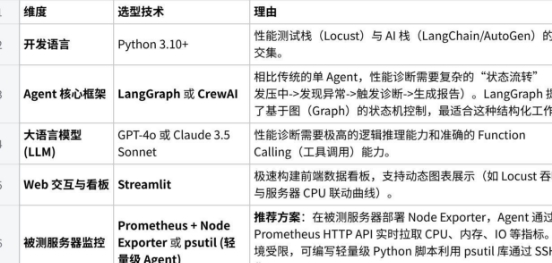
点击图片可查看完整电子表格
1. 数据库表设计(核心表)
-- 1. 测试任务表
CREATE TABLE test_tasks (
    task_id VARCHAR(36) PRIMARY KEY,
    scene_name VARCHAR(100),          -- 压测场景名称
    locust_script_path VARCHAR(255),   -- Locust 脚本路径
    target_host VARCHAR(255),          -- 被测服务基地址
    status VARCHAR(20),                -- PENDING, RUNNING, SUCCESS, FAILED
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

-- 2. 服务器节点配置表 (用于动态监控)
CREATE TABLE target_servers (
    server_id VARCHAR(36) PRIMARY KEY,
    task_id VARCHAR(36),
    ip_address VARCHAR(50),
    prometheus_job_name VARCHAR(50),   -- 对应 Prometheus 的 job
    ssh_user VARCHAR(50),              -- 备用:SSH直接诊断时使用
    ssh_key_path VARCHAR(255)
);

-- 3. 性能拐点及异常事件表 (Agent 触发诊断的输入)
CREATE TABLE performance_events (
    event_id VARCHAR(36) PRIMARY KEY,
    task_id VARCHAR(36),
    timestamp TIMESTAMP,
    event_type VARCHAR(50),            -- HIGH_ERROR_RATE, CPU_SPIKE, RESP_TIME_WARN
    metric_value FLOAT,                -- 触发时的具体数值
    description TEXT
);

-- 4. AI 诊断报告表
CREATE TABLE diagnosis_reports (
    report_id VARCHAR(36) PRIMARY KEY,
    task_id VARCHAR(36),
    summary TEXT,                      -- AI 总结
    root_cause TEXT,                   -- 根因分析
    suggestions TEXT,                  -- 优化建议
    raw_llm_output TEXT,               -- LLM 原始输出
    updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
2. 部署架构设计
- 控制台 (Streamlit APP):用户下发压测任务、查看实时大屏、阅读 AI 诊断报告。
- Agent 核心引擎 (Celery Worker):运行 Agent 工作流,负责启动 Locust 进程、监听指标、调用 LLM。
- 发压集群 (Locust Master/Worker):负责向被测服务发起高并发请求。
- 监控层 (Prometheus):通过 Node Exporter 抓取被测服务器的系统物理指标,通过 cAdvisor 或 APM 抓取应用指标(如 JVM/GC,若有)。
二、系统详细实现方案
1. 功能模块划分
系统主要分为以下四个核心模块:
- 任务执行模块 (Locust Controller):通过 Python subprocess 或 Locust 提供的 Web API 动态启动、停止压测,设定并发用户数和爬坡率(Spawn Rate)。
- 指标采集模块 (Metrics Collector):
- Locust 指标:通过请求 http://localhost:8089/stats/requests 获取实时的 RPS、响应时间(P95/P99)、错误率。
- 服务器资源指标:通过 Prometheus API 查询特定时间段内被测服务器的 CPU 利用率、内存占用、磁盘I/O、网络带宽。
- AI 诊断引擎 (LangGraph Agent):包含多个具身 Agent(Tools),能够根据指标异常自动调用 SSH 执行 top, jstat, dmesg 等命令。
- 前端展示模块 (Streamlit UI):将 Locust 压测曲线与服务器 CPU 曲线在同一时间轴(Dual-Y Axis)上对齐展示,并异步刷新 AI 诊断节点的思考过程。
2. 数据流程设计(Data Flow)
整个智能体诊断的完整生命周期数据流如下:
[用户配置任务] -> (Streamlit) -> 写入 DB -> 触发 Celery 异步任务
                                             |
                                             v
[压测启动] <------- (启动 Locust 进程) <--- [Agent 引擎] ---> (启动 Prometheus 监听)
   |                                         |
   v                                         v
产生流量 ---> [被测服务器] (Node Exporter) -> 产生系统指标
   |                 |
   v                 v
[Locust Stats]     [Prometheus]
   |                 |
   +--------+--------+
            | (每 5 秒轮询聚合)
            v
     [异常检测器 (Threshold Detector)]
            |
            |-- 发现异常 (例如: RPS 下降且 CPU > 90%, 或错误率 > 5%)
            v
     [触发 AI Agent 诊断工作流]
            |
            |--> 1. 工具调用:拉取过去 3 分钟的 CPU/内存/RPS 趋势
            |--> 2. 工具调用:SSH 登录服务器执行进程分析 (如 pidstat)
            |--> 3. LLM 推理:结合 Locust 报错信息与系统性能指标进行根因分析
            v
     [生成 Markdown 报告] -> 存入 DB -> Streamlit 页面实时推送展示
3. 关键技术难点及解决方案
难点一:如何有效、安全地获取服务器的 CPU 等资源性能指标?
- 挑战:直接让 AI 执行 SSH 具有高风险,且高频执行命令会消耗服务器自身资源。
- 解决方案:采用“非侵入式常规监控 + 侵入式深度诊断”相结合的方式。
- 常规监控(Prometheus 方案):在被测服务器安装 Node Exporter。Agent 内部封装一个 query_prometheus_metric 的工具(Tool)。
- 代码实现示例 (Agent 获取 CPU 工具):
- Python
import requests
import time

def get_server_cpu_utilization(prometheus_url, query_range_minutes=5):
    """工具:获取被测服务器过去 N 分钟内的 CPU 平均使用率趋势"""
    end_time = int(time.time())
    start_time = end_time - (query_range_minutes * 60)

    # Prometheus PromQL: 计算非空闲 CPU 的占比
    prom_ql = '100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[1m])) * 100)'

    url = f"{prometheus_url}/api/v1/query_range"
    params = {
        'query': prom_ql,
        'start': start_time,
        'end': end_time,
        'step': '15s' # 每15秒一个点
    }
    response = requests.get(url, params=params).json()
    return response['data']['result']
难点二:AI 如何精准捕捉“性能拐点”并触发诊断?
- 挑战:如果单纯依靠大模型盯着海量数据,Token 消耗巨大且响应慢。
- 解决方案:引入传统规则/异常检测算法作为“哨兵”,由哨兵激活 Agent。
- 哨兵规则:当满足以下任一条件时,向 Agent 发送中断信号(Interrupt):
- RPS(每秒请求数)达到瓶颈开始下滑,而并发用户数仍在上升(经典的性能拐点)。
- 错误率(Error Rate)连续 30 秒大于 2%。
- 被测服务器 CPU 利用率持续 1 分钟超过 85%。
- 此时,Agent 被唤醒,并自动获取拐点前后 2 分钟的上下文快照提供给 LLM。
难点三:如何让 Agent 具备像高级测试开发工程师一样的诊断逻辑?
- 挑战:LLM 容易泛泛而谈(如“请检查您的网络或代码”),无法给出具体根因。
- 解决方案:利用 LangGraph 构建结构化的诊断状态机 (Reasoning Graph),强制 Agent 遵循排查 SOP(标准作业程序)。
- 节点 1:指标对齐 (Align Metrics):AI 必须先对比 Locust 响应时间暴涨的时刻,服务器 CPU、内存、网络 IO 是否也同步暴涨。
- 节点 2:分流判断 (Branching):
- 若 CPU 高,内存正常 -> 进入代码/线程型诊断(工具调用:执行 SSH top -Hp 寻找忙碌线程,或分析 GC 日志)。
- 若内存持续上升不回落 -> 进入内存泄漏诊断(工具调用:检查 JVM 堆内存或 Python 内存占用)。
- 若服务器各项指标都很低,但 Locust 端报错 504 -> 进入网关/连接池诊断(工具调用:检查 Nginx 报错日志或数据库连接池状态)。
- 节点 3:总结报告 (Report Generation):汇总上述诊断工具的输出,给出结论。
三、核心代码结构参考(Agent 节点设计)
以下是使用 Python 伪代码及 LangChain 工具箱定义一个能够自主诊断服务器性能的 Agent 核心实现:
Python
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent

# 1. 定义 Agent 可以使用的工具
@tool
def fetch_locust_status() -> dict:
    """获取当前 Locust 的压测统计数据,包含当前 RPS、错误率和响应时间。"""
    # 实际项目中请求 locust web api
    return {"rps": 450, "p95_response_time_ms": 2500, "error_rate": 0.04}

@tool
def fetch_server_metrics() -> dict:
    """获取目标服务器的 CPU、内存、IO 状态。"""
    # 实际项目中请求 Prometheus
    return {"cpu_utilization_pct": 94.5, "memory_utilization_pct": 62.0, "disk_io_wait_pct": 1.2}

@tool
def execute_ssh_diagnostic_cmd(cmd: str) -> str:
    """当服务器 CPU 或内存异常时,通过 SSH 在被测服务器执行深度诊断命令(如 top, pidstat, jstat)"""
    # 限制高风险命令,仅允许特定的诊断指令
    allowed_cmds = ["top -b -n 1 | head -n 20", "pidstat -u 1 3", "jstat -gcutil 1 1"]
    if cmd not in allowed_cmds:
        return "Error: Unauthorized command."
    # 执行 SSH 逻辑并返回控制台文本
    return "[Mock Output] PID 1234 (java) is consuming 88% CPU. GC Time is high."

# 2. 初始化大模型与工具绑定
llm = ChatOpenAI(model="gpt-4o", temperature=0)
tools = [fetch_locust_status, fetch_server_metrics, execute_ssh_diagnostic_cmd]

# 3. 创建带有系统提示词(System Prompt)的诊断 Agent
system_prompt = """
你是一个资深的性能测试诊断专家 Agent。你的任务是分析性能测试中的瓶颈。
当被分配一个任务时,你应该:
1. 调用 fetch_locust_status 和 fetch_server_metrics 收集当前表现。
2. 关联两端数据。如果发现 Locust 响应时间长且服务器 CPU 高,深入使用 execute_ssh_diagnostic_cmd 查看具体进程。
3. 给出包含【现象】、【可能根因】、【排查证据】、【修复建议】的 Markdown 格式报告。
"""

diagnostic_agent = create_react_agent(llm, tools, state_modifier=system_prompt)

# 4. 触发诊断示例
# inputs = {"messages": [("user", "当前压测发现响应时间突然飙升,请帮我诊断服务器发生了什么。")]}
# for output in diagnostic_agent.stream(inputs):
#     print(output)
四、总结与演进方向
通过上述方案搭建的 Agent 工具,将原先需要测试人员“看压测看板 -> 登录服务器 -> 敲命令 -> 看日志”长达半小时的链路,压缩到由 Agent 在触发拐点后 30 秒内自动完成。
后续演进:可以进一步将研发侧的代码托管仓库(如 GitLab)作为工具接入 Agent。当 AI 定位到某个特定接口的 CPU 暴涨且属于计算密集时,可以直接读取该接口对应的后端源码,实现直接在报告中指出“第 X 行代码存在死循环/大对象创建”的终极智能诊断。