
Easy Dataset × LLaMA Factory 让大模型高效学习领域知识
前言准备
Easy Dataset 是一个专为创建大型语言模型(LLM)微调数据集而设计的应用程序。它提供了直观的界面,用于上传特定领域的文件,智能分割内容,生成问题,并为模型微调生成高质量的训练数据。支持使用 OpenAI、DeepSeek、火山引擎等大模型 API 和 Ollama 本地模型调用。
LLaMA Factory 是一款开源低代码大模型微调框架,集成了业界最广泛使用的微调技术,支持通过 Web UI 界面零代码微调大模型,目前已经成为开源社区最热门的微调框架之一,GitHub 星标超过 4.6 万。支持全量微调、LoRA 微调、以及 SFT 和 DPO 等微调算法。
本教程使用 Easy Dataset 从五家互联网公司的公开财报构建 SFT 微调数据,并使用 LLaMA Factory 微调 Qwen2.5-3B-Instruct 模型,使微调后的模型能学习到财报数据集中的知识。
运行环境要求
- GPU 显存:大于等于 12 GB(可使用 autodl.com 租用云 GPU)
- CUDA 版本:高于 11.6
- Python 版本:3.10
1.使用 Easy Dataset 生成微调数据
1.1 安装 Easy Dataset
1.1.1 方法一:使用安装包
如果操作系统为 Windows、Mac 或 ARM 架构的 Unix 系统,可以直接前往 Easy Dataset 仓库下载安装包:https://github.com/ConardLi/easy-dataset/releases/latest
1.1.2 方法二:使用 Dockerfile
- 从 GitHub 拉取 Easy Dataset 仓库
git clone https://github.com/ConardLi/easy-dataset.git
cd easy-dataset- 构建 Docker 镜像
docker build -t easy-dataset .- 运行容器
docker run -d \
    -p 1717:1717 \
    -v {YOUR_LOCAL_DB_PATH}:/app/local-db \
    --name easy-dataset \
    easy-dataset
1.1.3 方法三:使用 NPM 安装
- 下载 Node.js 和 pnpm
前往 Node.js 和 pnpm 官网安装环境:https://nodejs.org/en/download | https://pnpm.io/
使用以下代码检查 Node.js 版本是否高于 18.0
node -v # v22.14.0- 从 GitHub 拉取 Easy Dataset 仓库
git clone https://github.com/ConardLi/easy-dataset.git
cd easy-dataset- 安装软件依赖
pnpm install- 启动 Easy Dataset 应用
pnpm build
pnpm start控制台如果出现以下输出,则说明启动成功。打开浏览器访问对应网址,即可看到 Easy Dataset 的界面。
> easy-dataset@1.2.3 start
> next start -p 1717

  ▲ Next.js 14.2.25
  - Local:        http://localhost:1717

 ✓ Ready in 287ms
1.2 示例数据下载
本教程准备了一批互联网公司财报作为示例数据,包含五篇国内互联网公司 2024 年二季度的财报,格式包括 txt 和 markdown。可以使用 git 命令或者直接访问仓库链接下载。
git clone https://github.com/llm-factory/FinancialData-SecondQuarter-2024.git数据均为纯文本数据,如下为节选内容示例。
快手二季度净利润增超七成,CEO程一笑强调可灵AI商业化

8月20日,快手科技发布2024年第二季度业绩,总营收同比增长11\.6%至约310亿元,经调整净利润同比增长73\.7%达46\.8亿元左右。该季度,快手的毛利率和经调整净利润率均达到单季新高,分别为55\.3%和15\.1%。值得一提的是,针对今年加码的AI相关业务,快手联合创始人、董事长兼CEO程一笑在财报后的电话会议上表示,可灵AI将寻求更多与B端合作变现的可能性,也会探索将大模型进一步运用到商业化推荐中,提升算法推荐效率。

线上营销服务贡献近六成收入,短剧日活用户破3亿

财报显示,线上营销服务、直播和其他服务(含电商)收入依然是拉动快手营收的“三驾马车”,分别占总营收的56\.5%、30\.0%和13\.5%。线上营销服务收入由2023年同期的143亿元增加22\.1%至2024年第二季度的175亿元,财报解释主要是由于优化智能营销解决方案及先进的算法,推动营销客户投放消耗增加。
1.3 微调数据生成
1.3.1 创建项目并配置参数
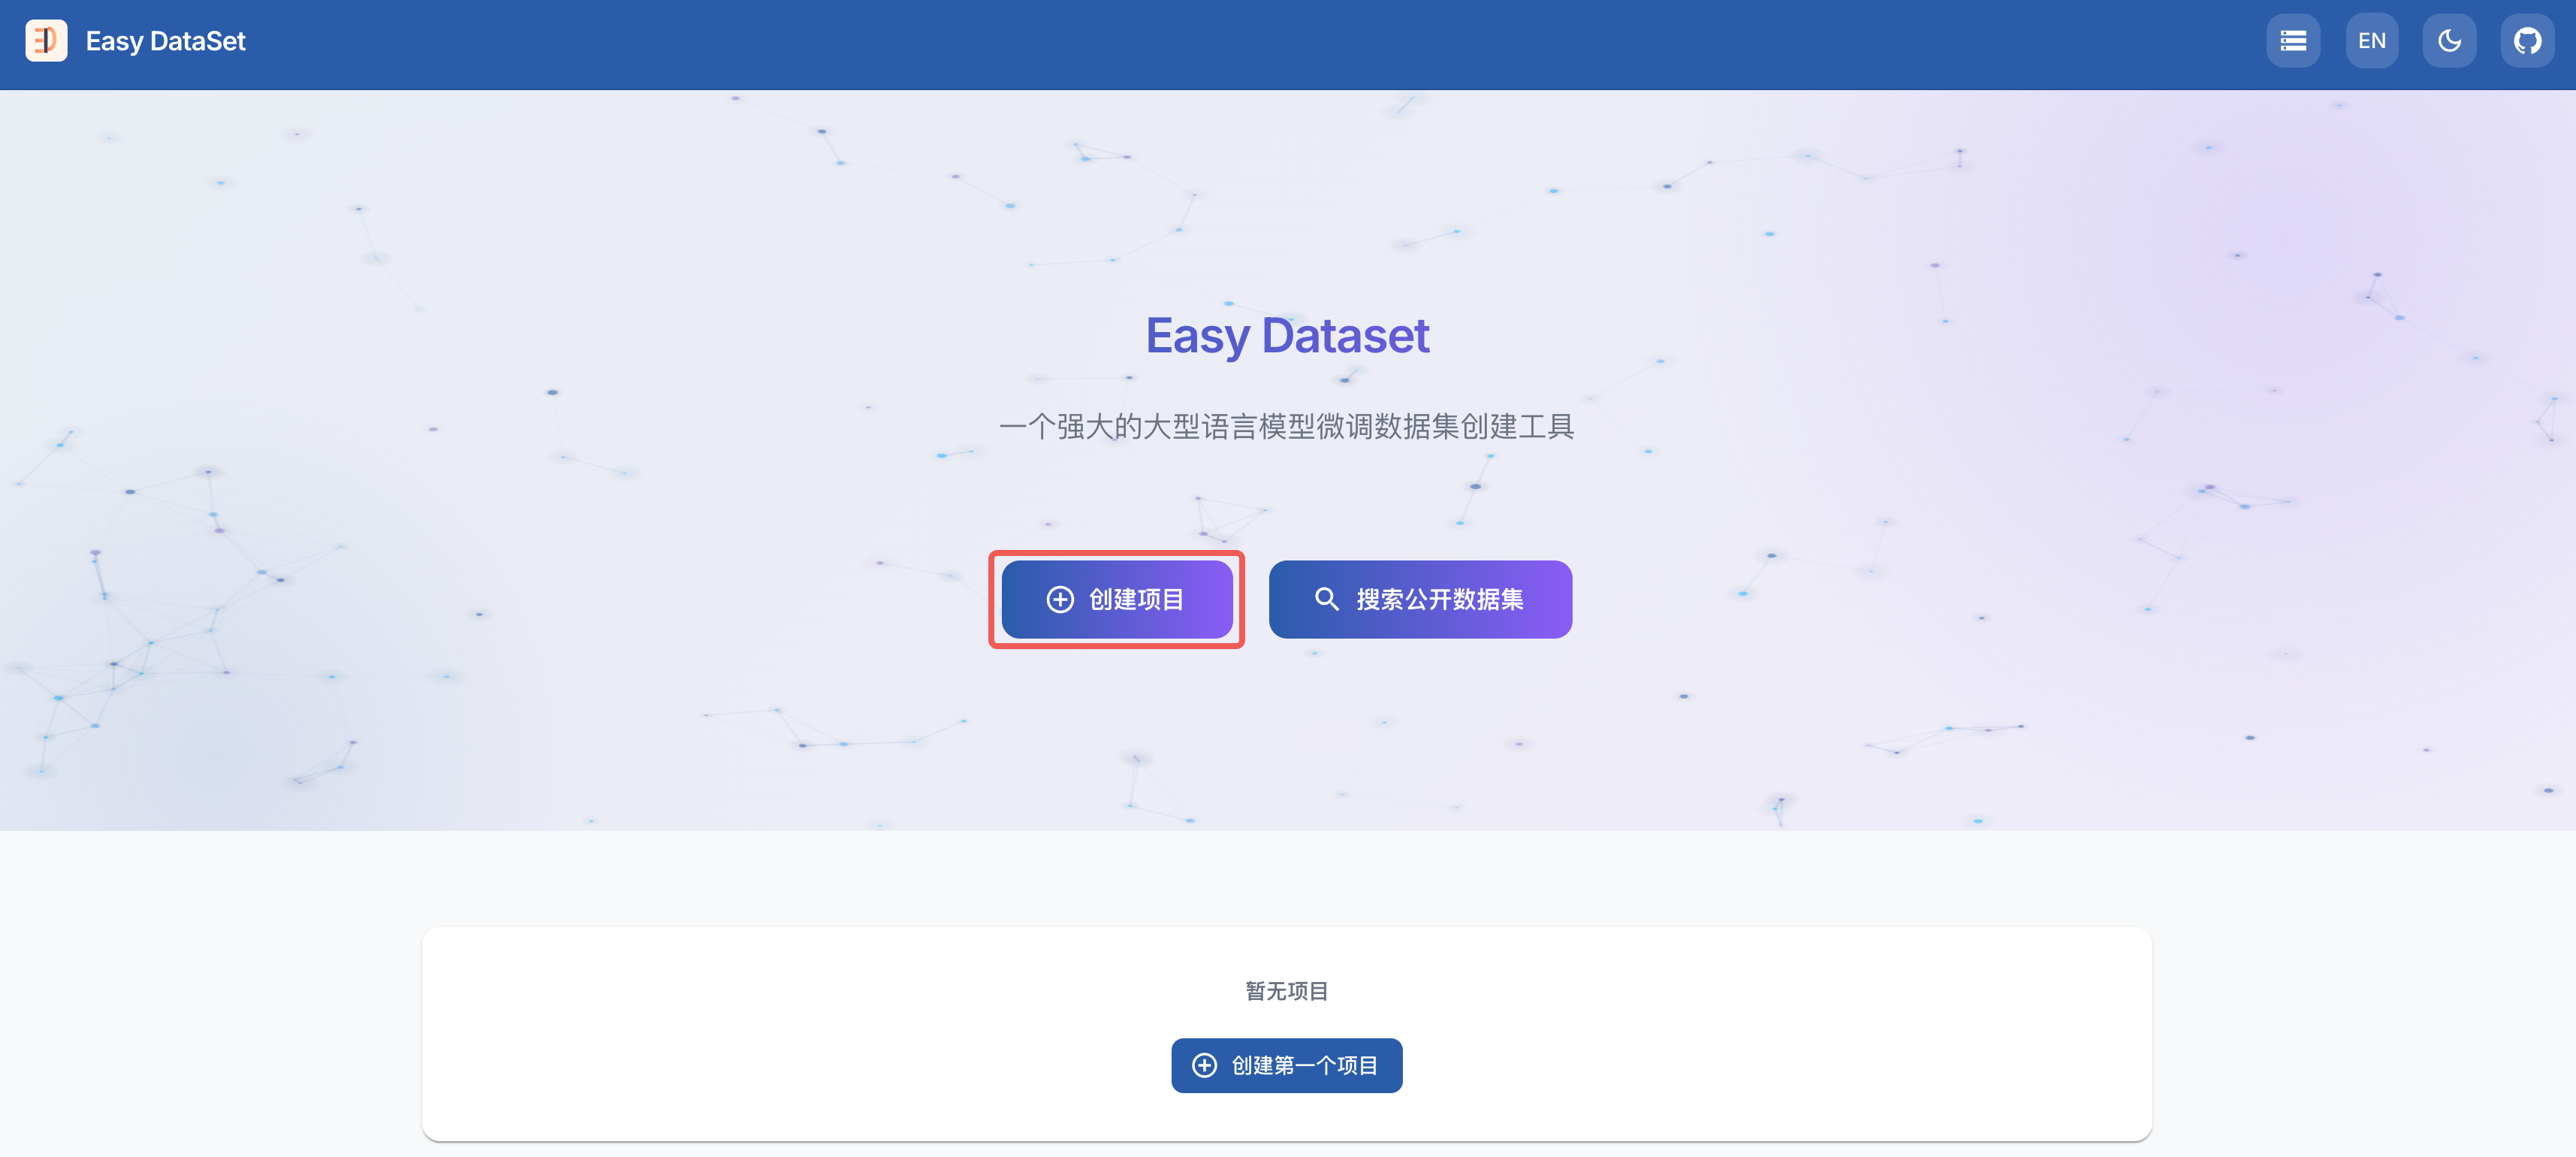
- 在浏览器进入 Easy Dataset 主页后,点击创建项目
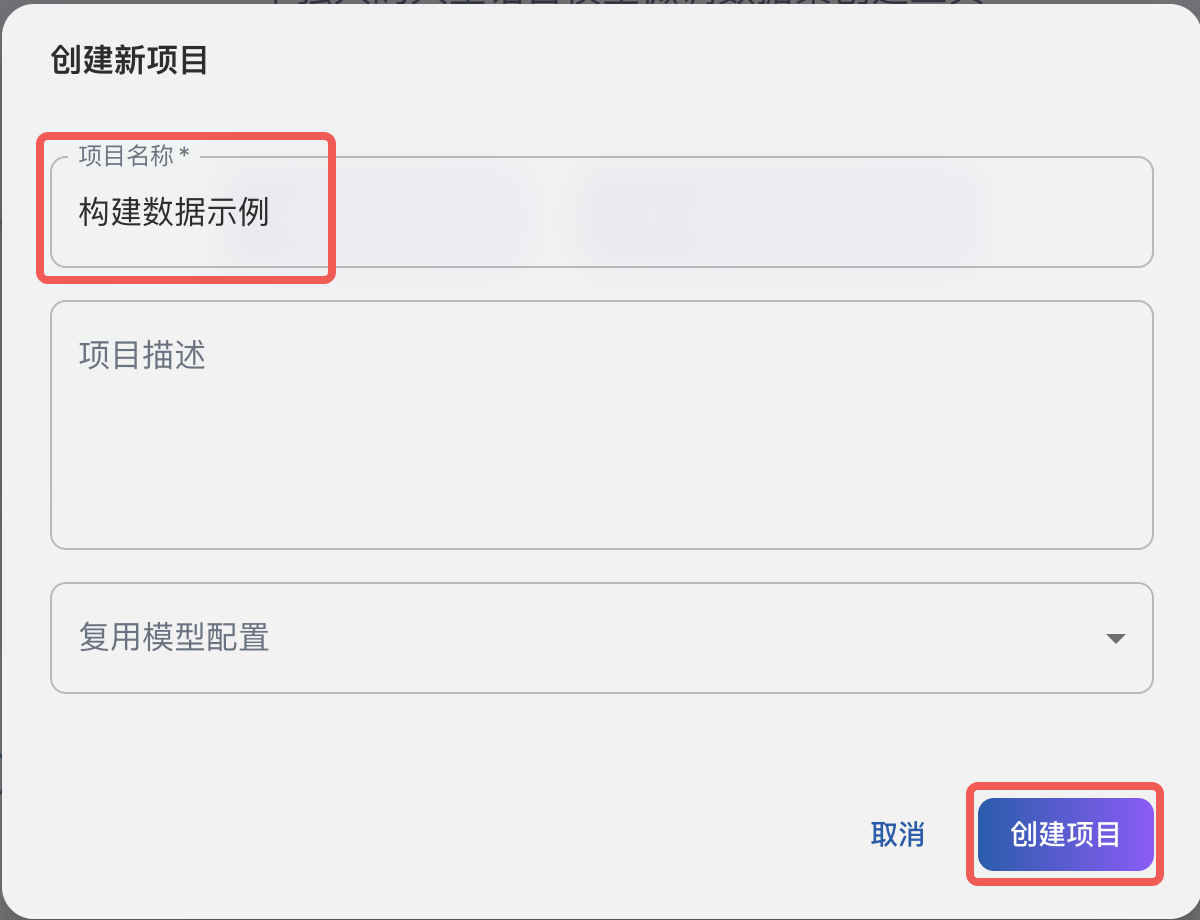
- 首先填写项目名称(必填),其他两项可留空,点击确认创建项目
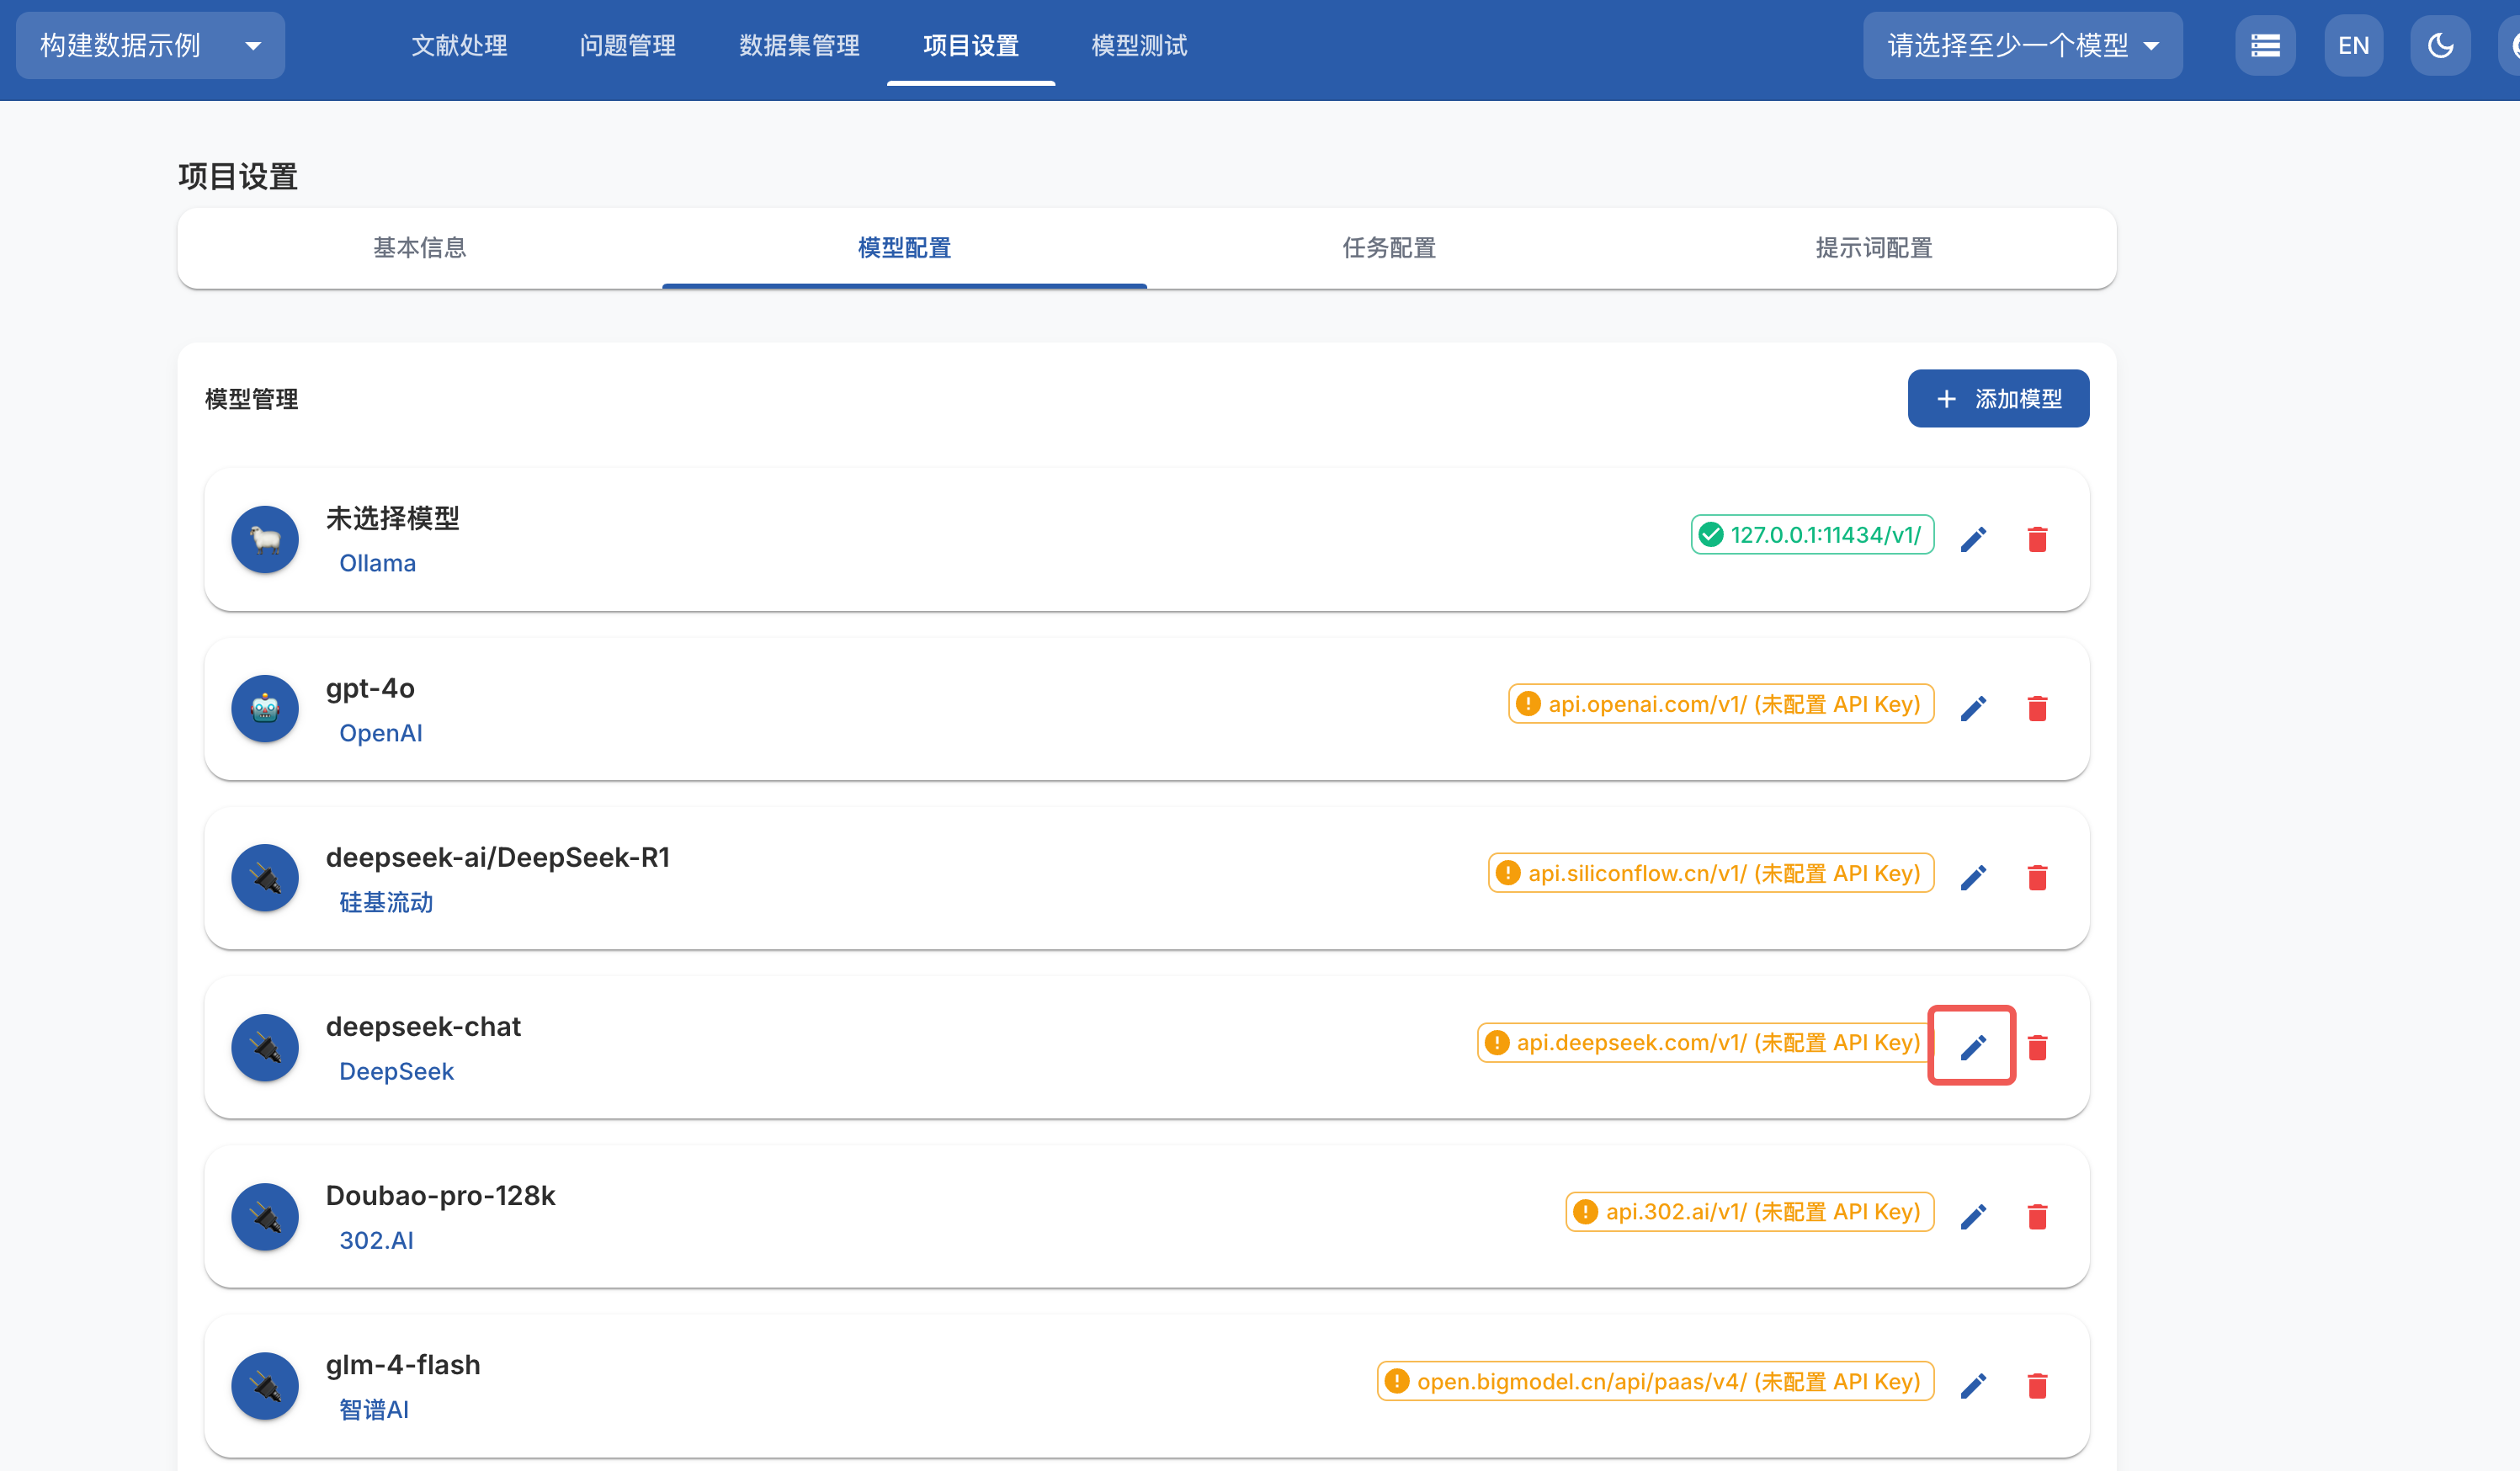
- 项目创建后会跳转到项目设置页面,打开模型配置,选择数据生成时需要调用的大模型 API 接口
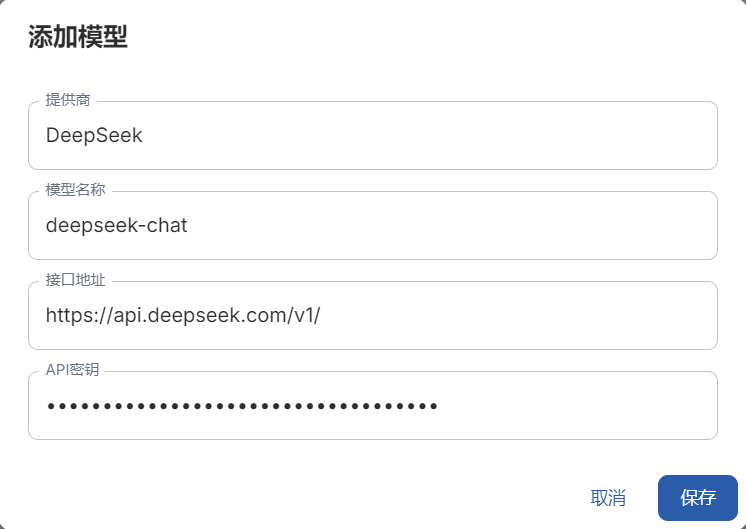
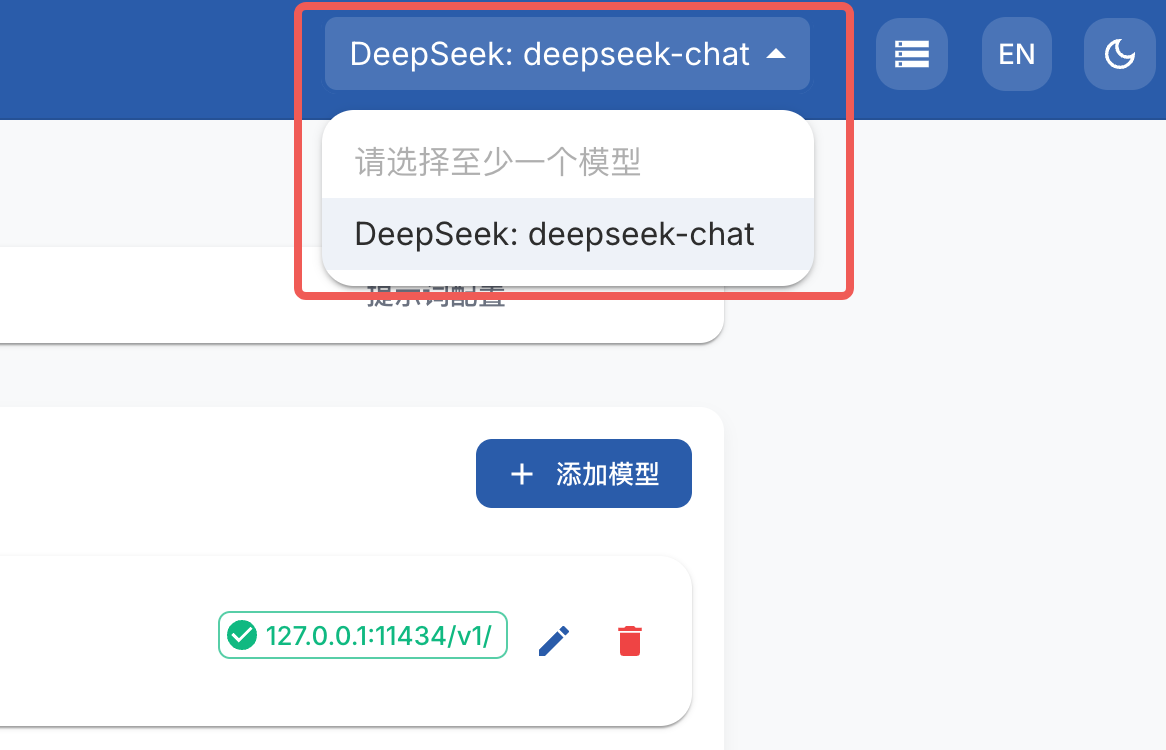
- 这里以 DeepSeek 模型为例,修改模型提供商和模型名称,填写 API 密钥,点击保存后将数据保存到本地,在右上角选择配置好的模型
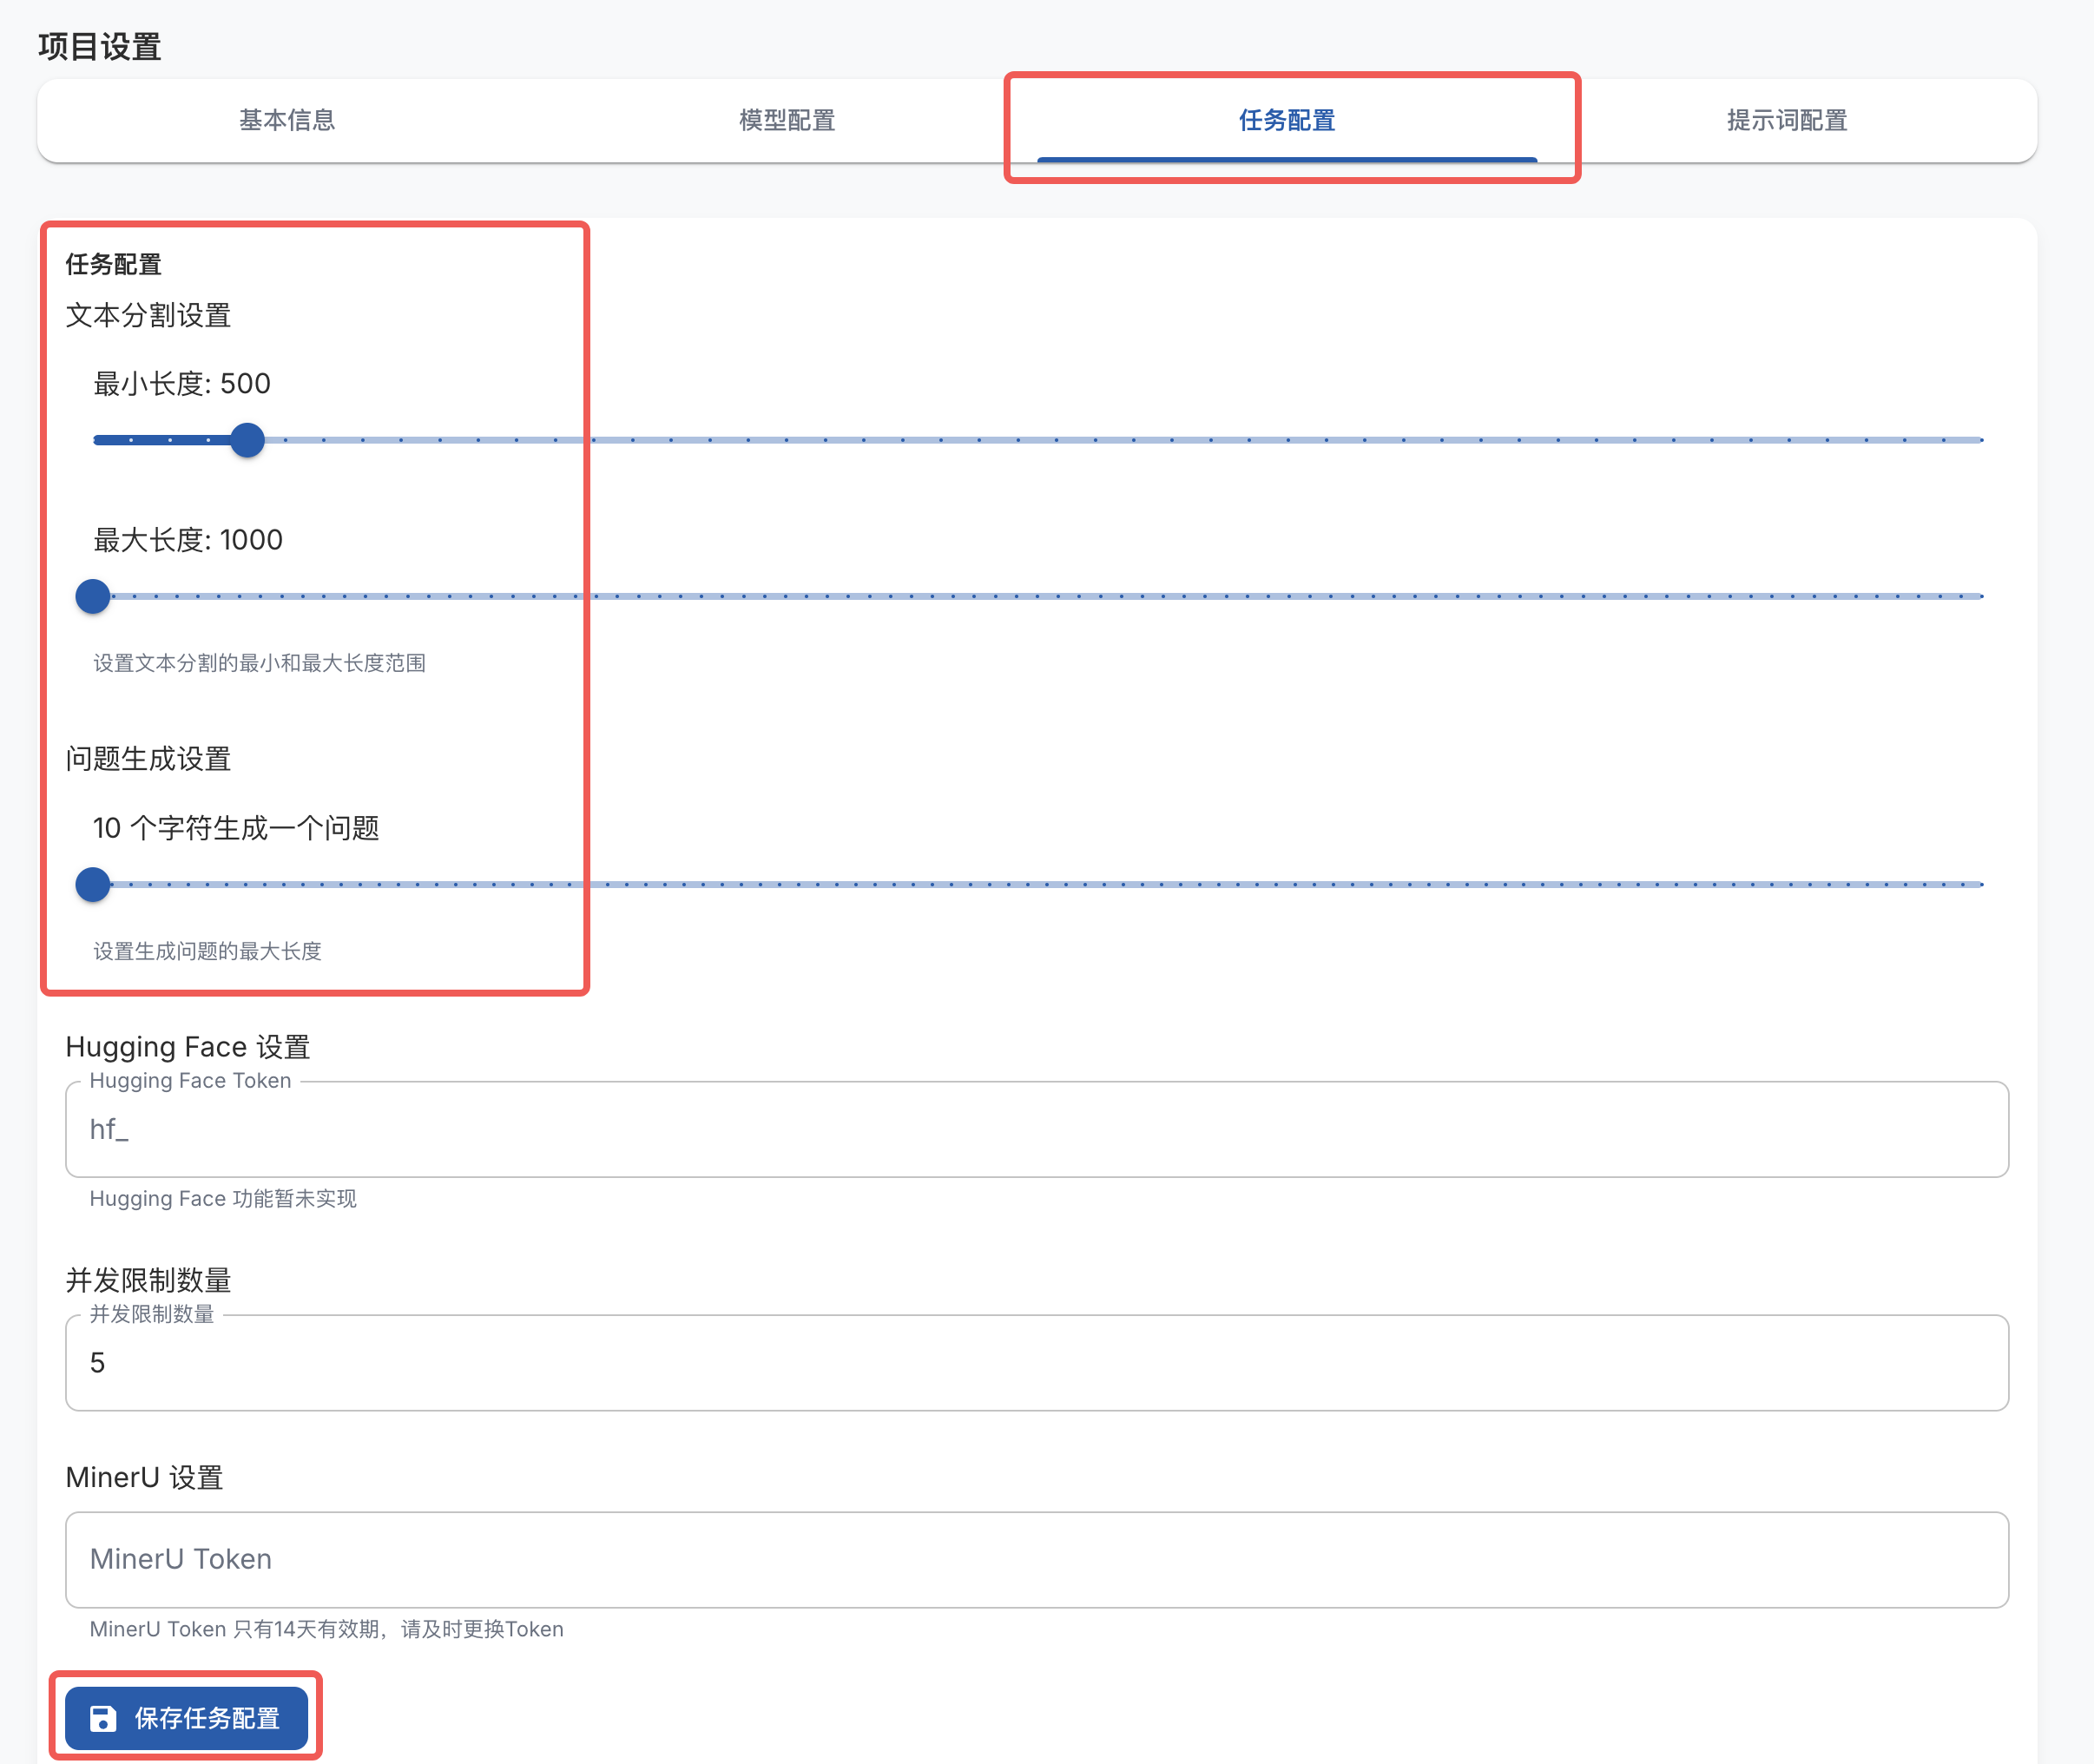
- 打开任务配置页面,设置文本分割长度为最小 500 字符,最大 1000 字符。在问题生成设置中,修改为每 10 个字符生成一个问题,修改后在页面最下方保存任务配置
1.3.2 处理数据文件
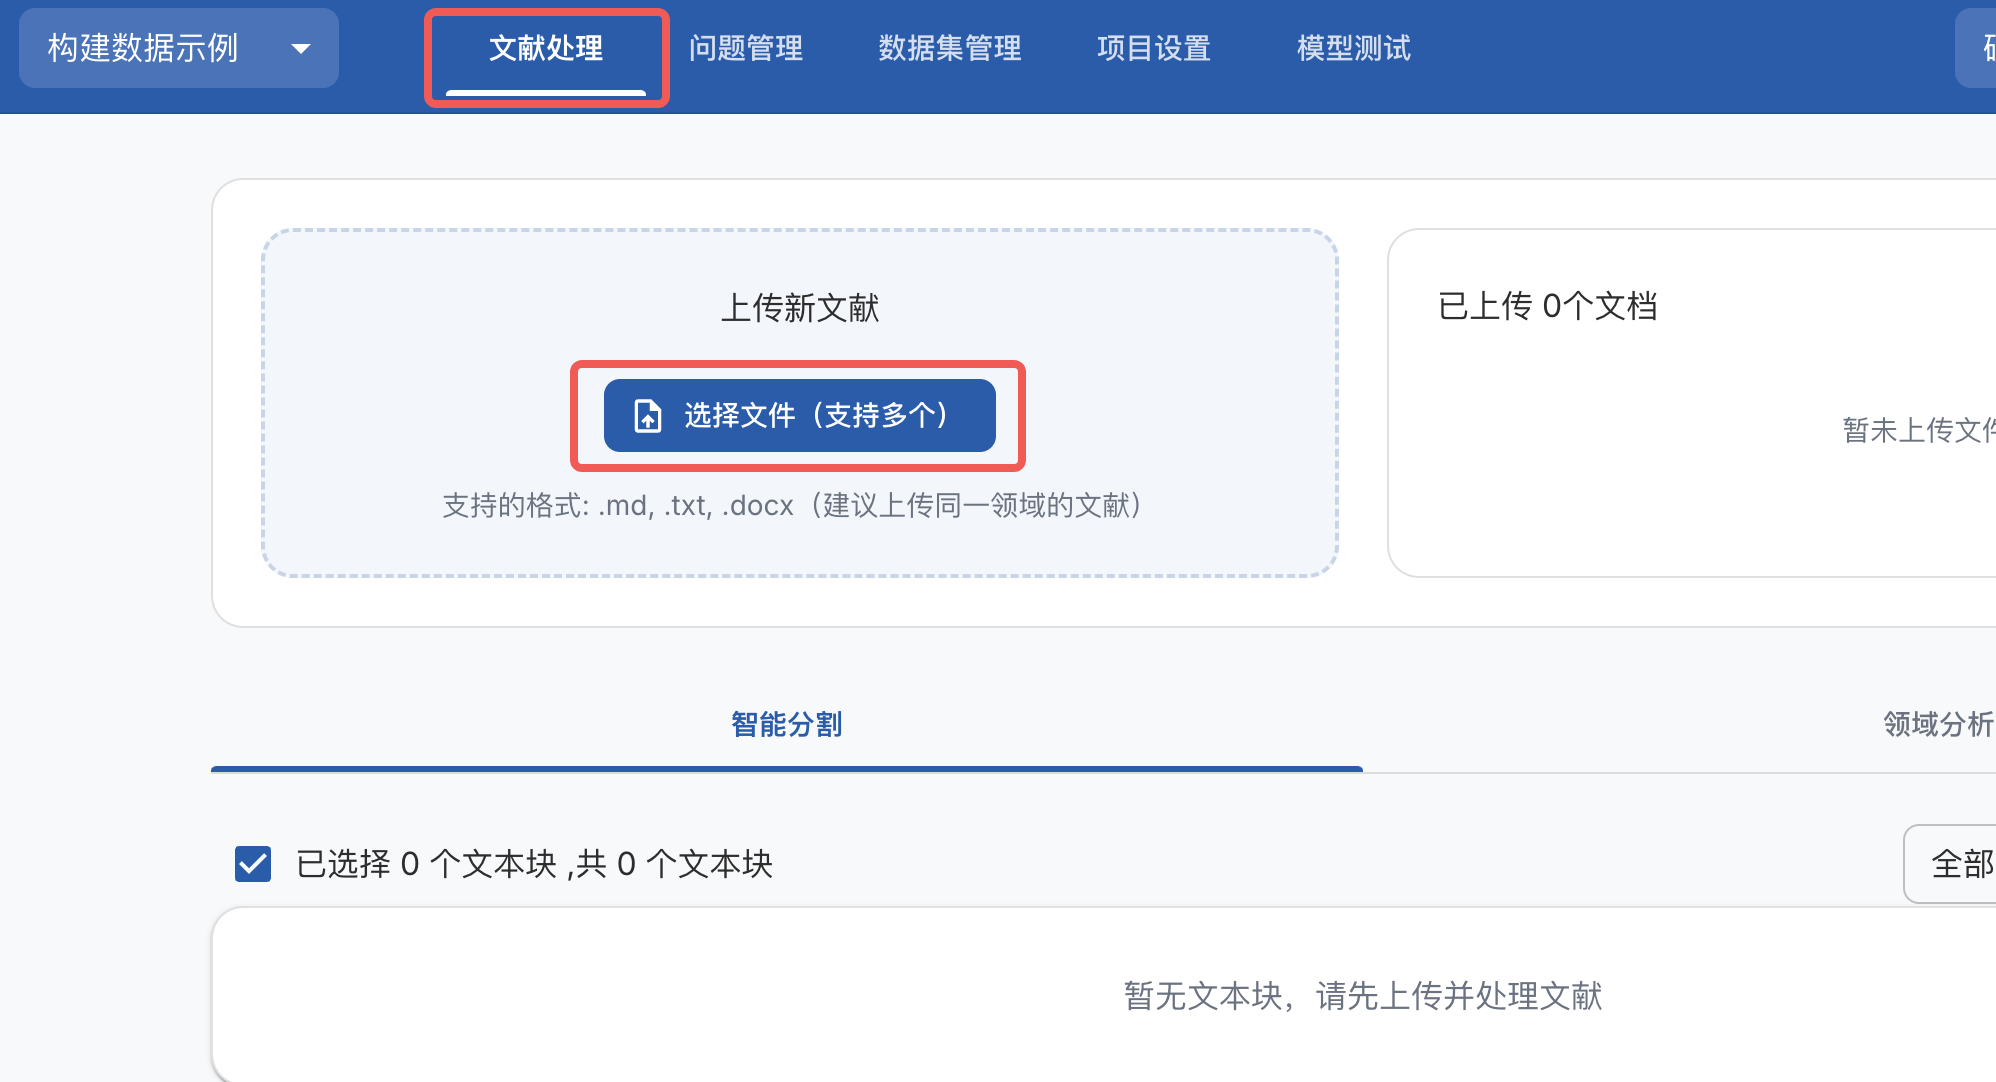
- 打开文献处理页面,选择并上传示例数据文件,选择文件后点击上传并处理文件
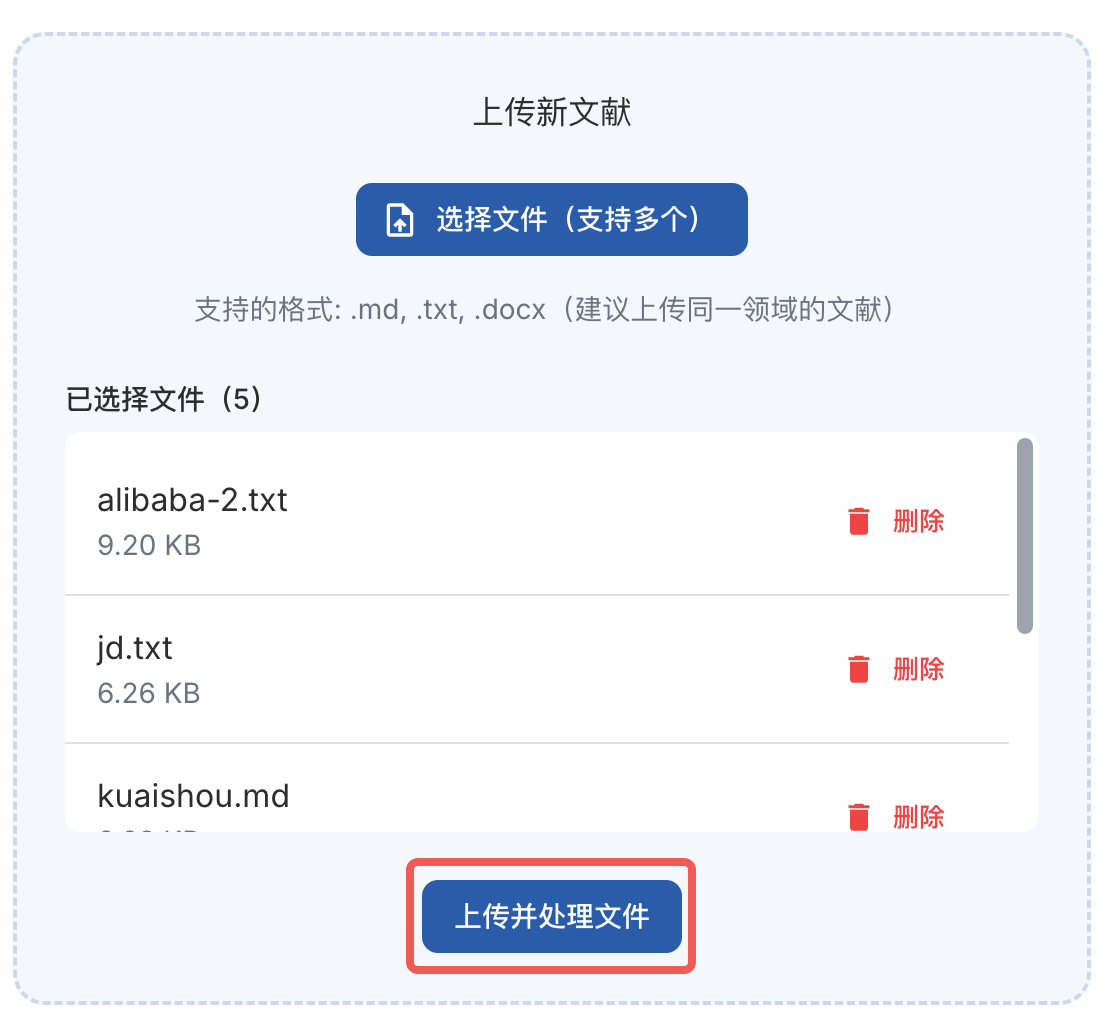
- 上传后会调用大模型解析文件内容并分块,耐心等待文件处理完成,示例数据通常需要 2 分钟左右
1.3.3 生成微调数据
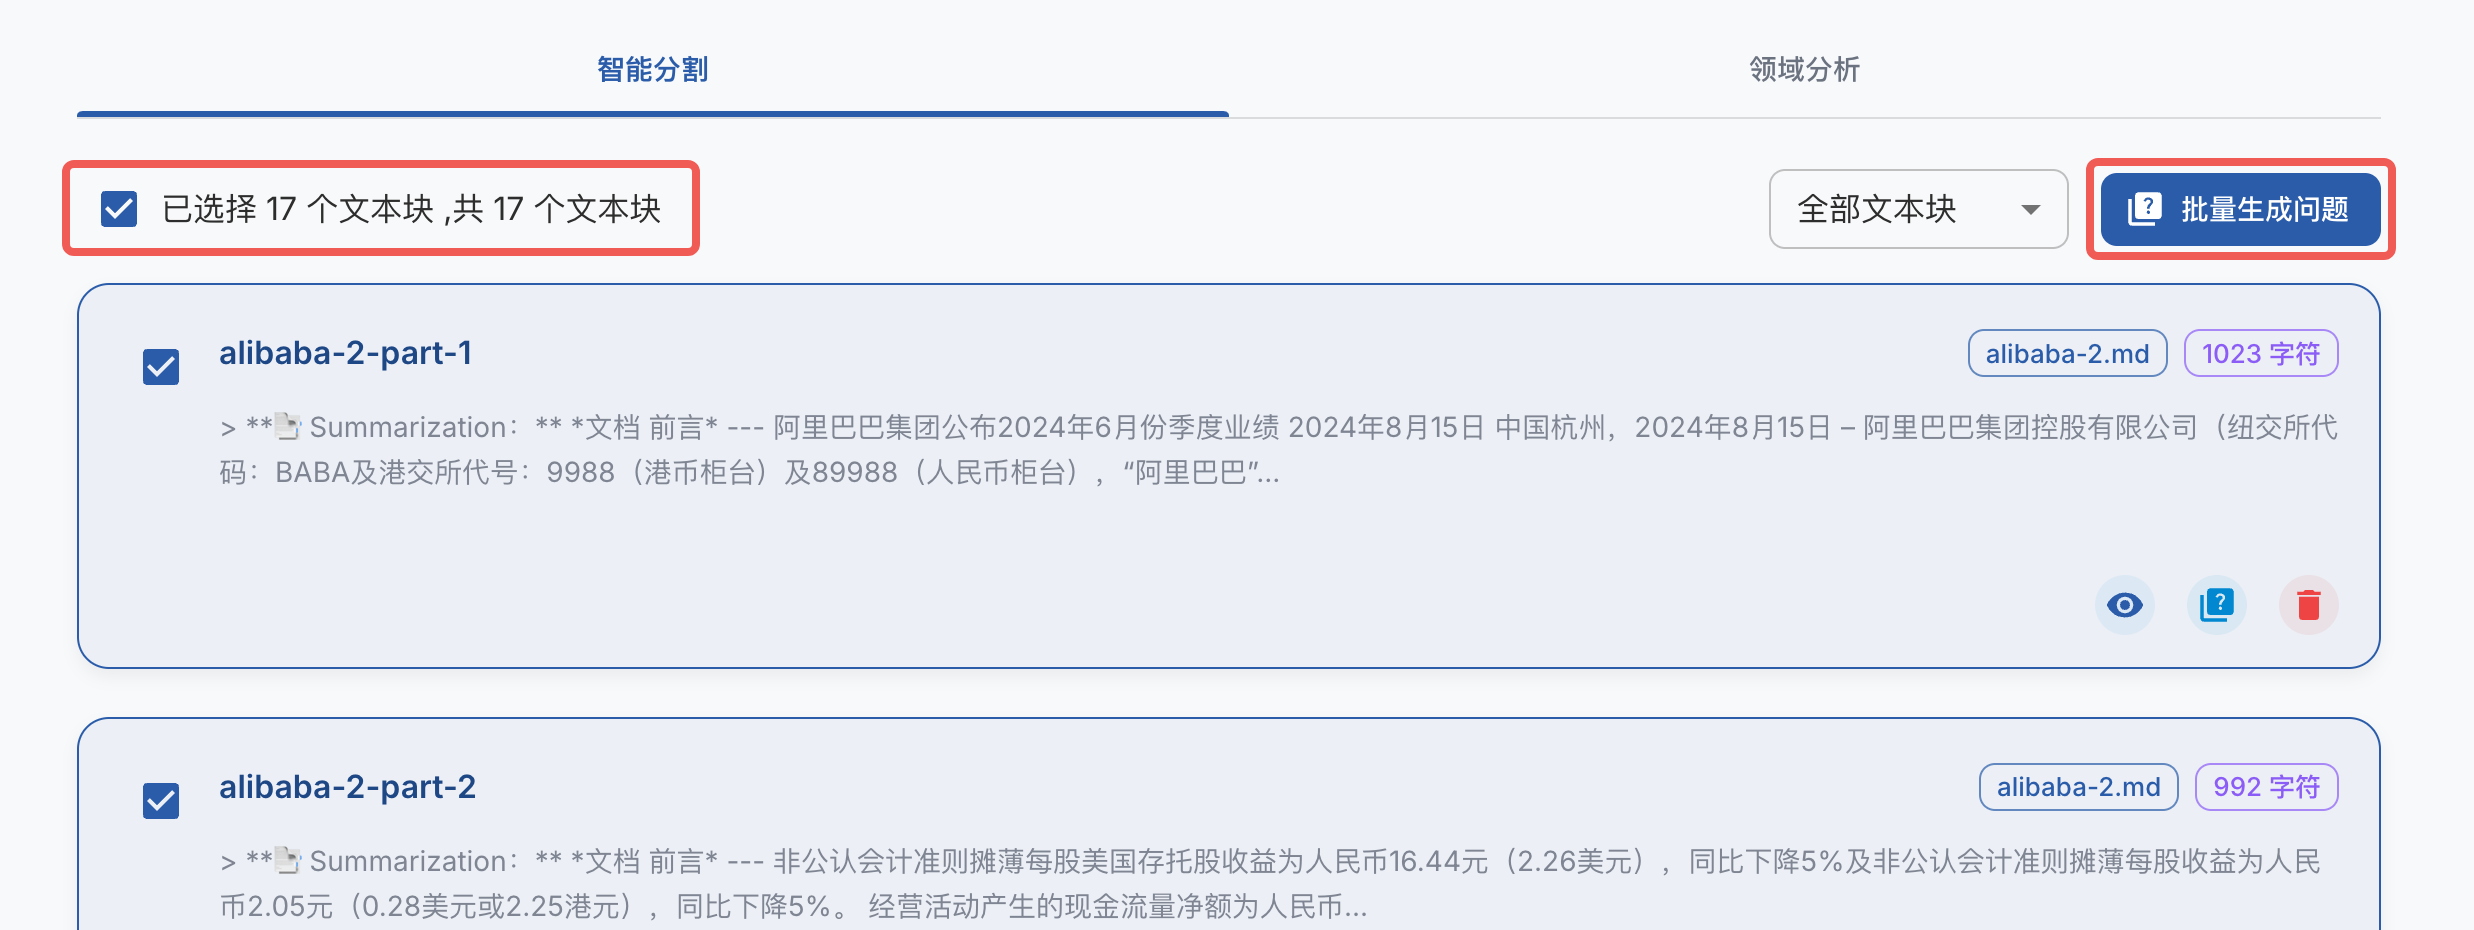
- 待文件处理结束后,可以看到文本分割后的文本段,选择全部文本段,点击批量生成问题
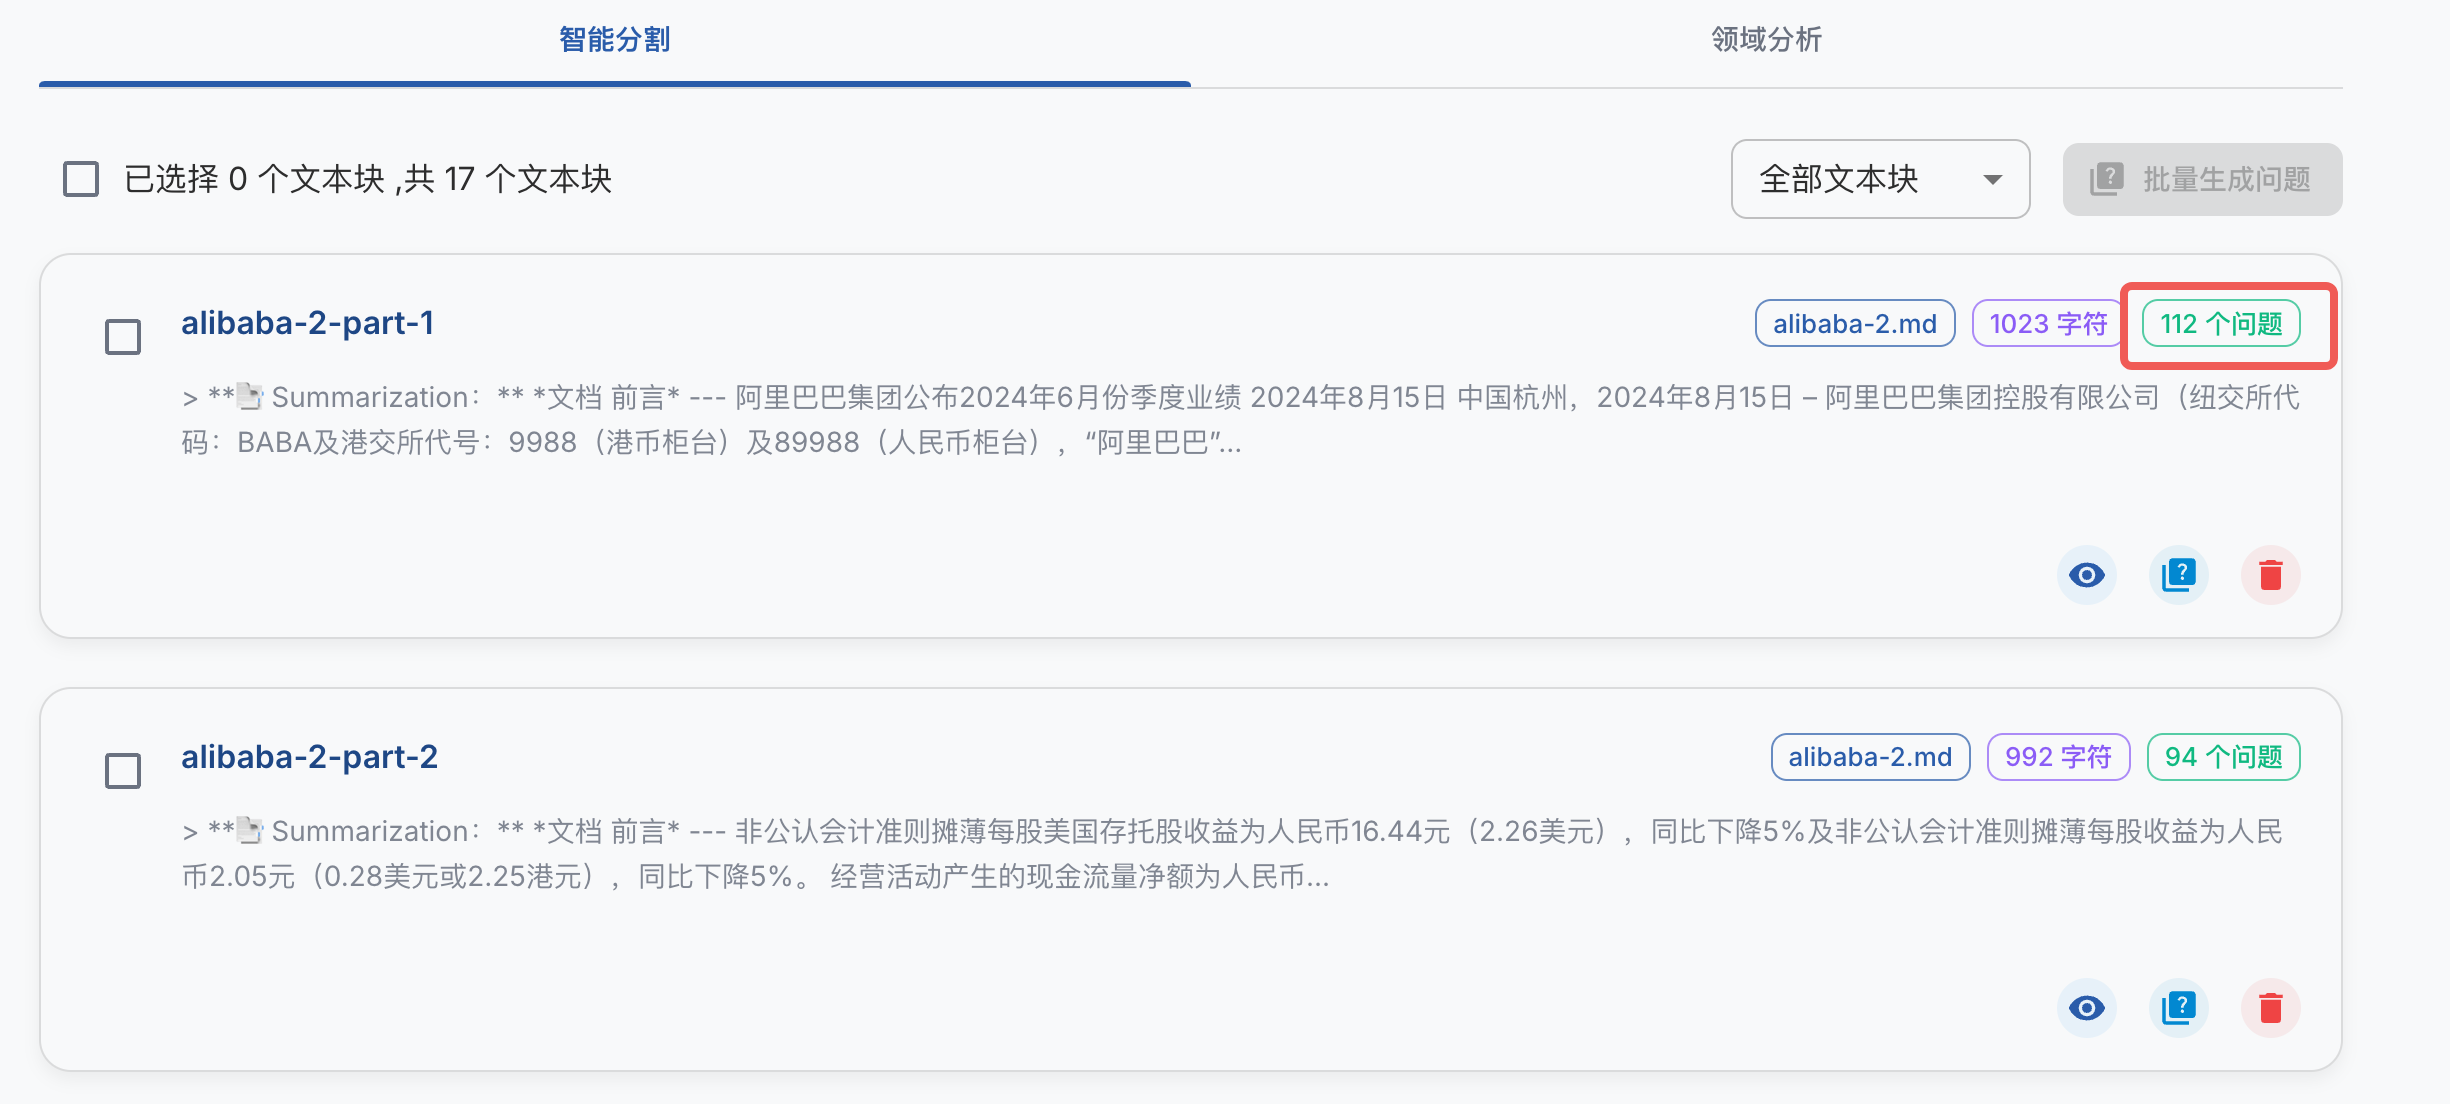
- 点击后会调用大模型根据文本块来构建问题,耐心等待处理完成。视 API 速度,处理时间可能在 20-40 分钟不等
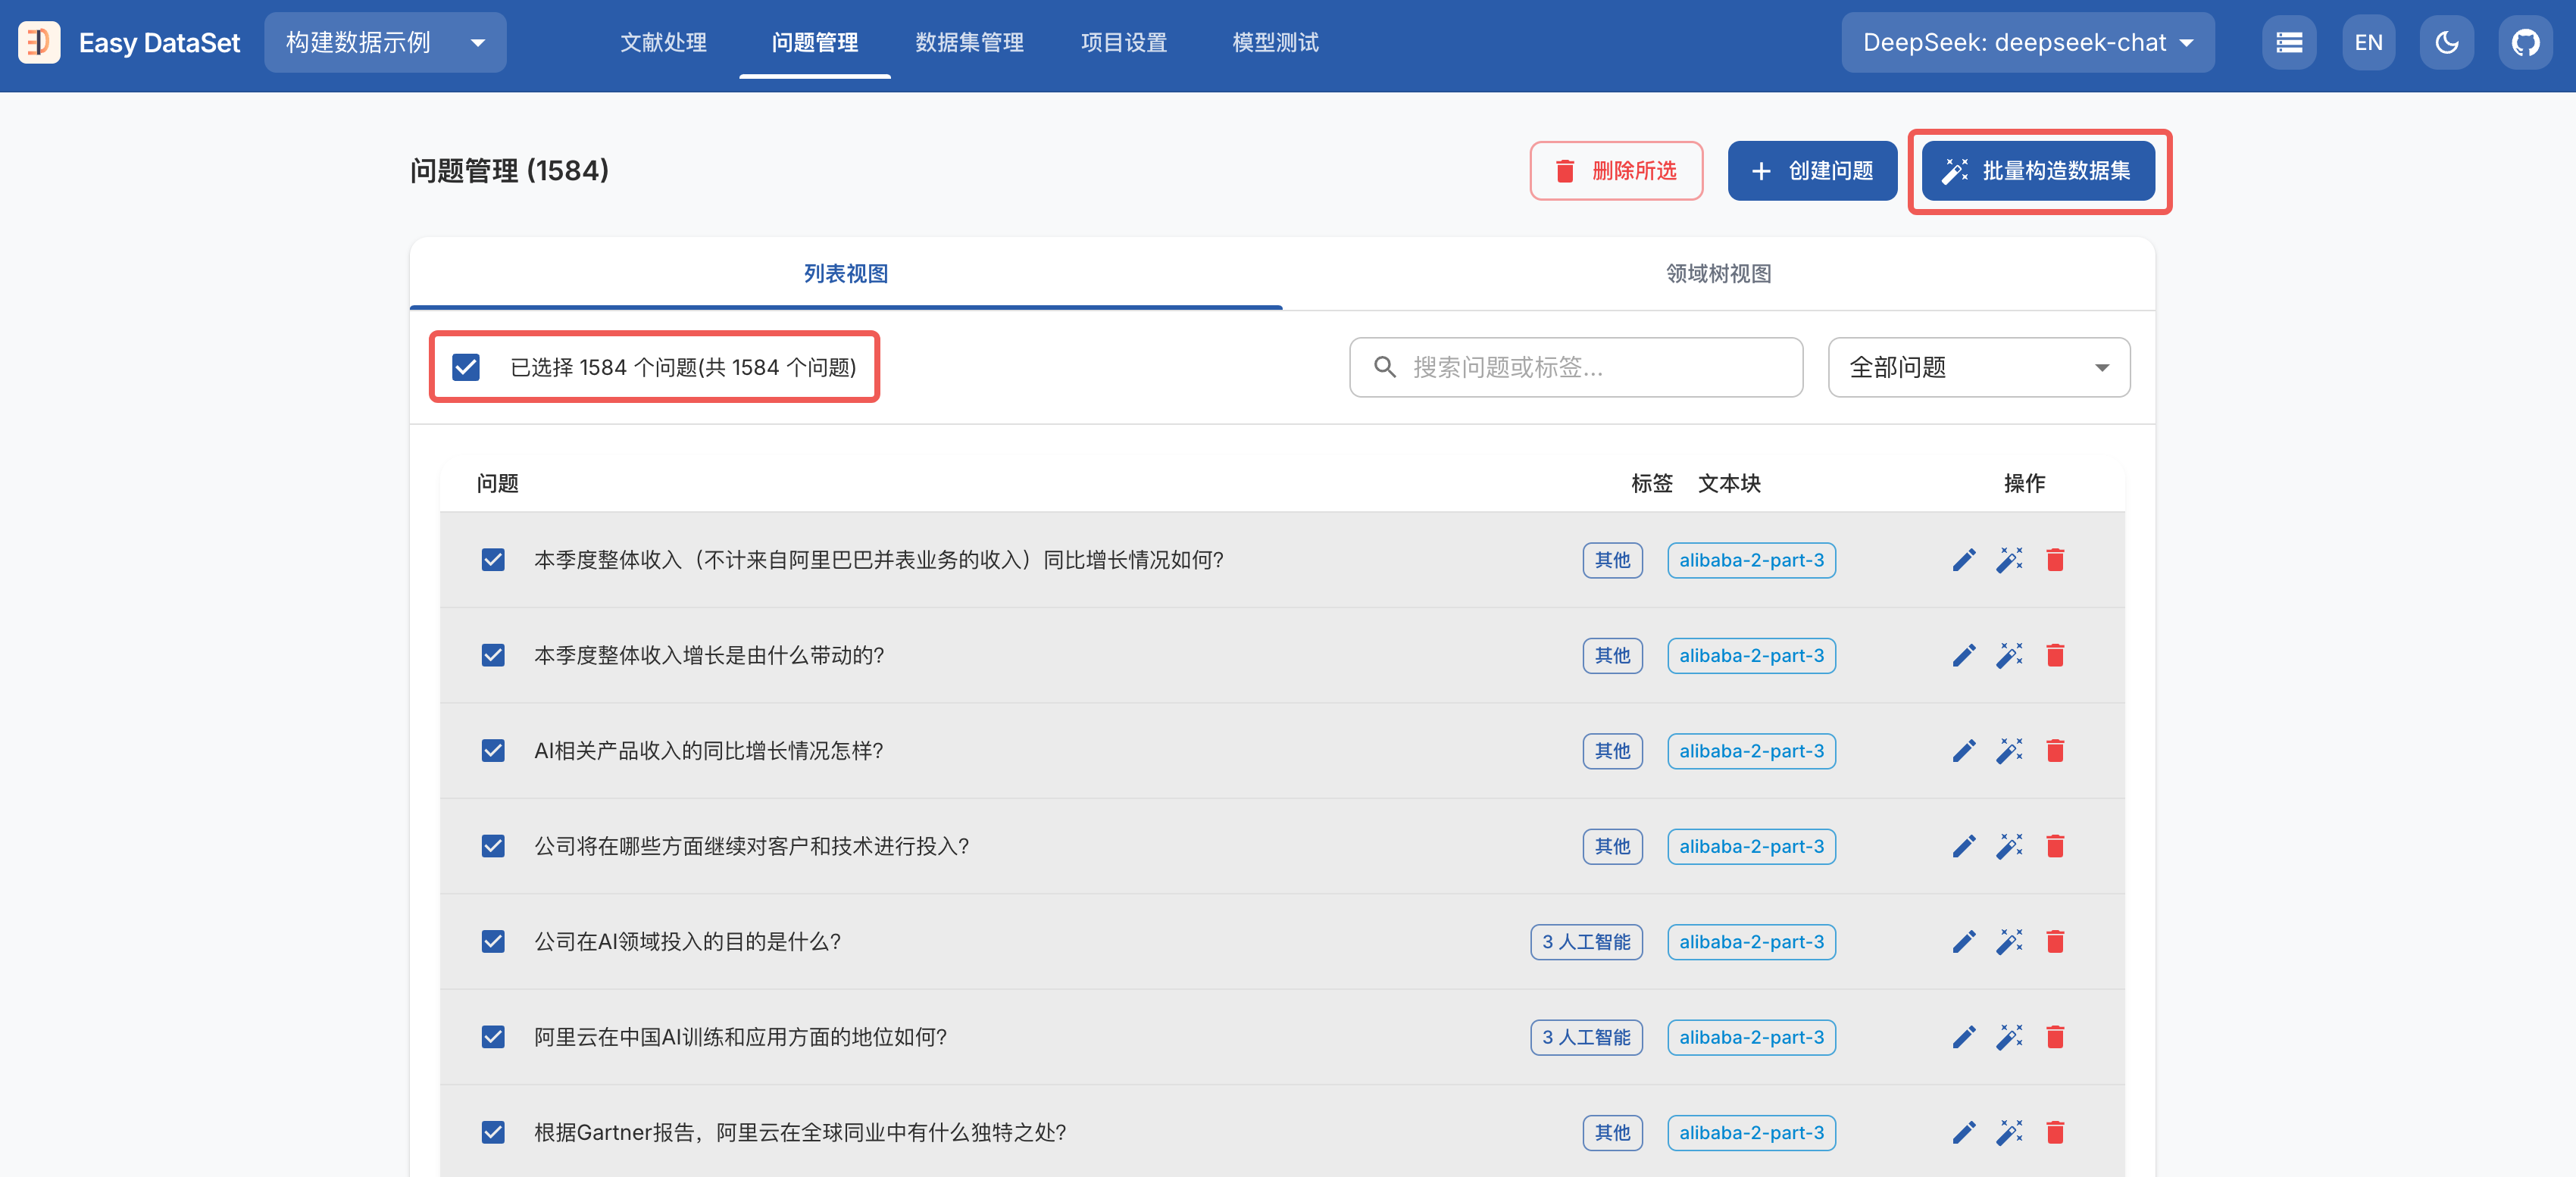
- 处理完成后,打开问题管理页面,选择全部问题,点击批量构造数据集,耐心等待数据生成。视 API 速度,处理时间可能在 20-40 分钟不等
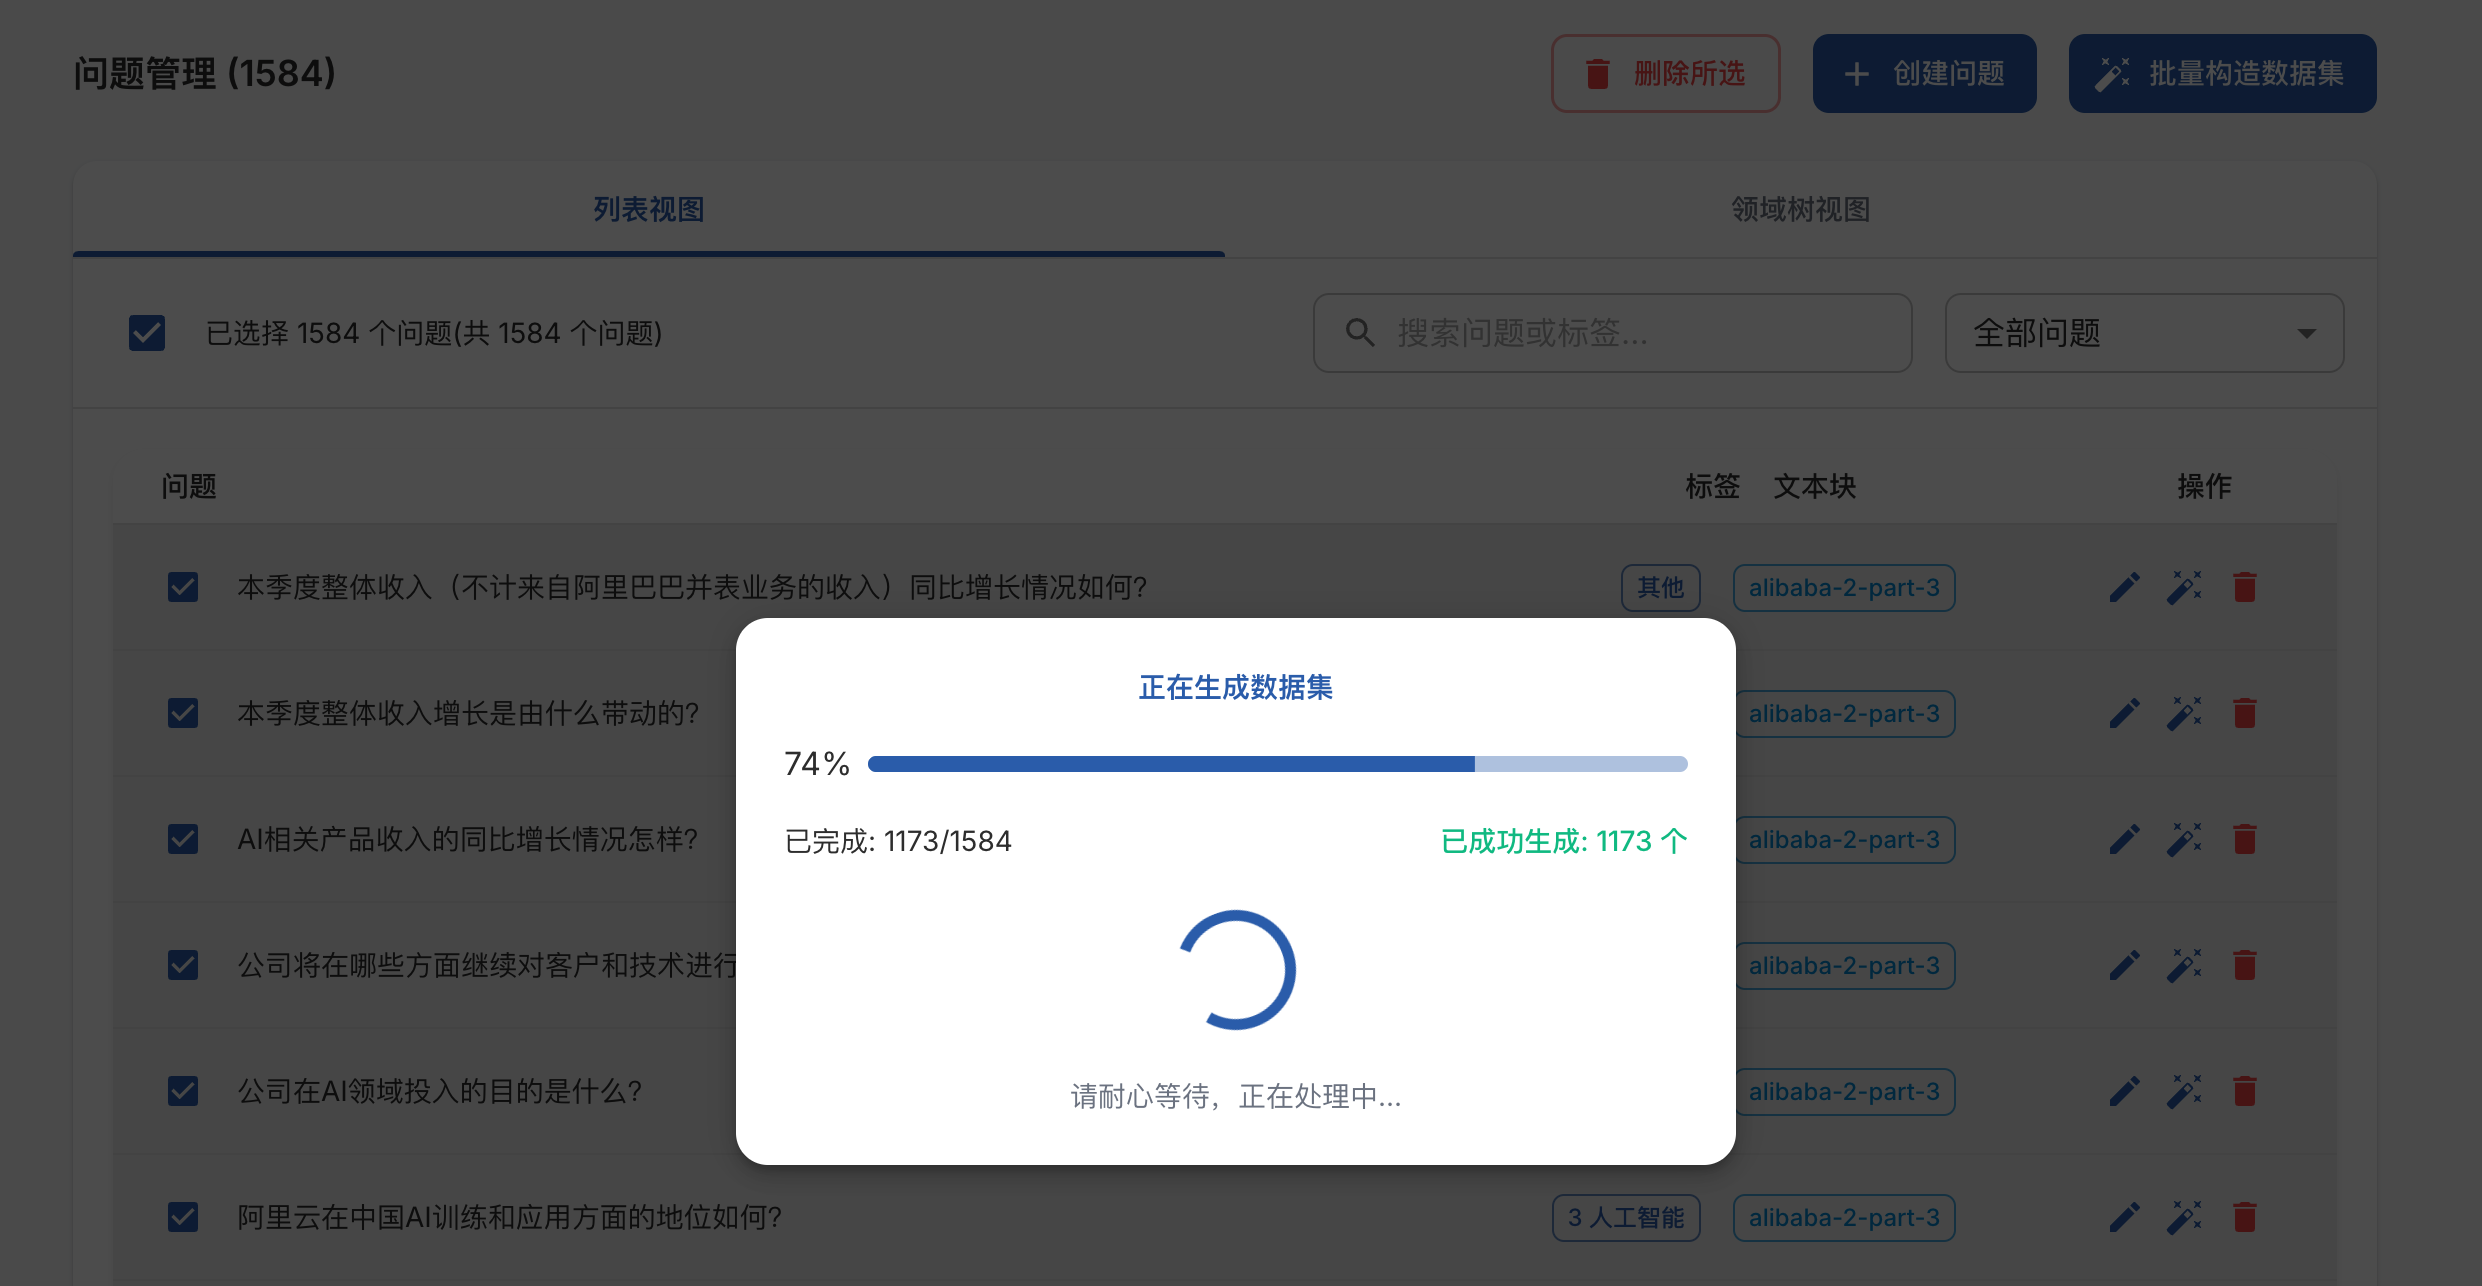
如果部分问题的答案生成失败,可以重复以上操作再次生成。
1.3.4 导出数据集到 LLaMA Factory
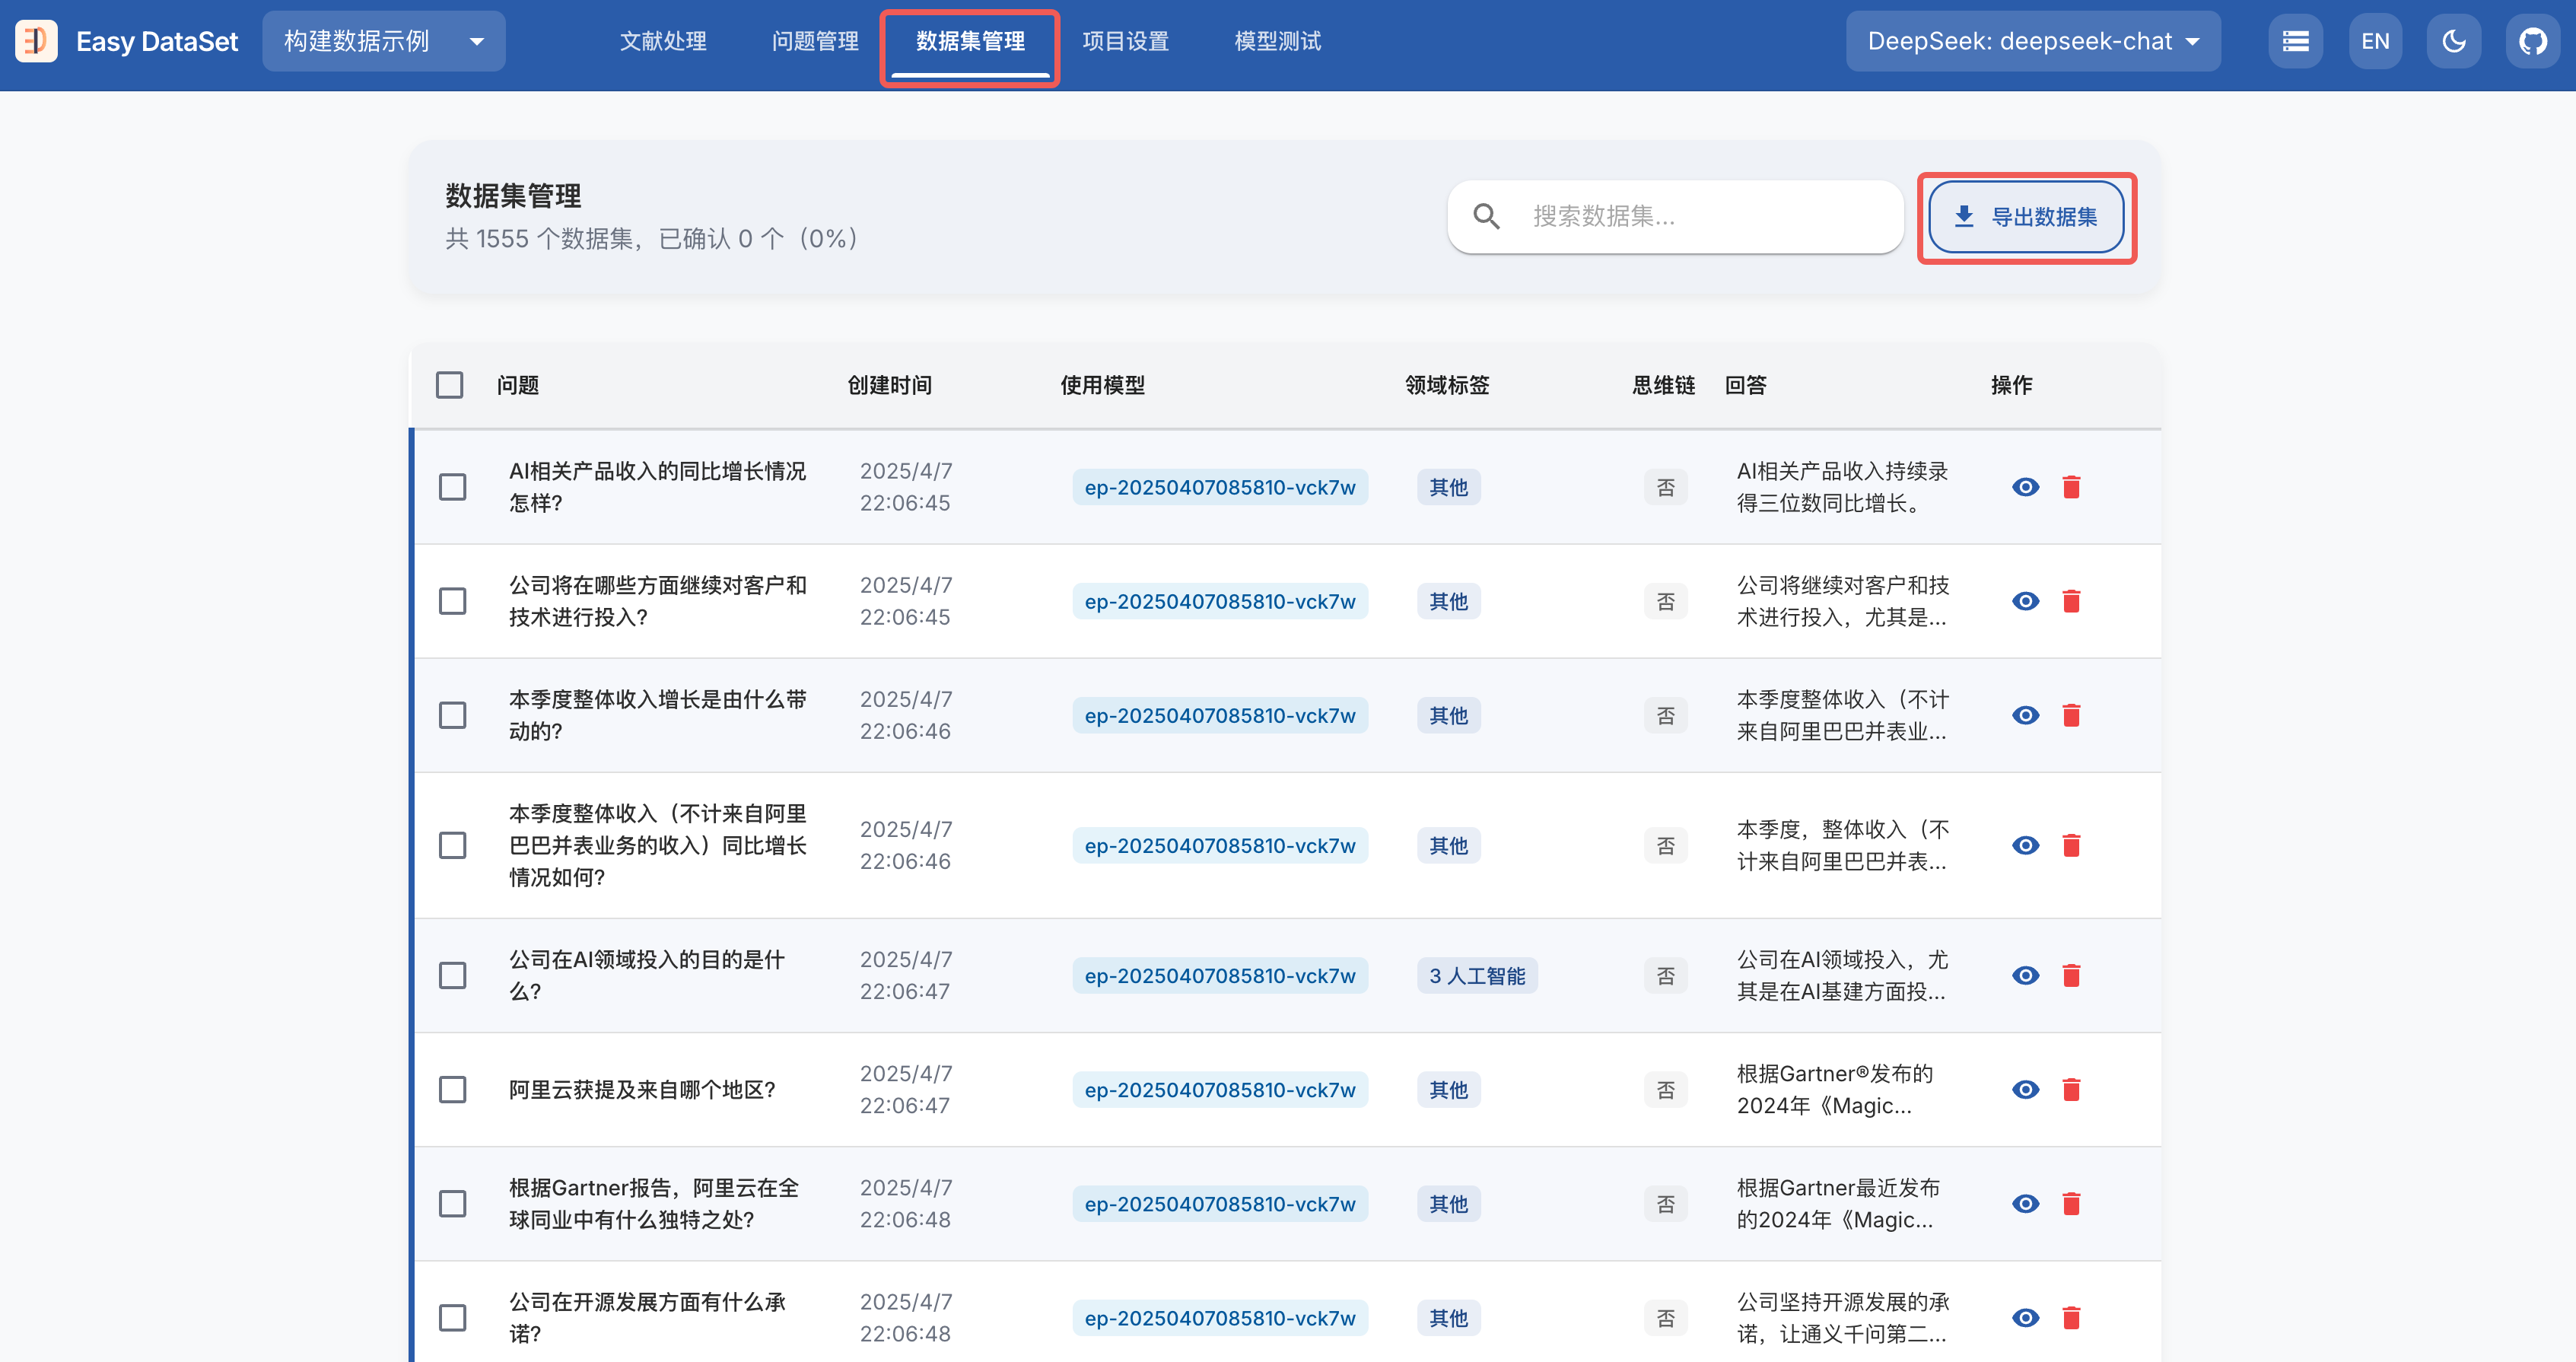
- 答案全部生成结束后,打开数据集管理页面,点击导出数据集
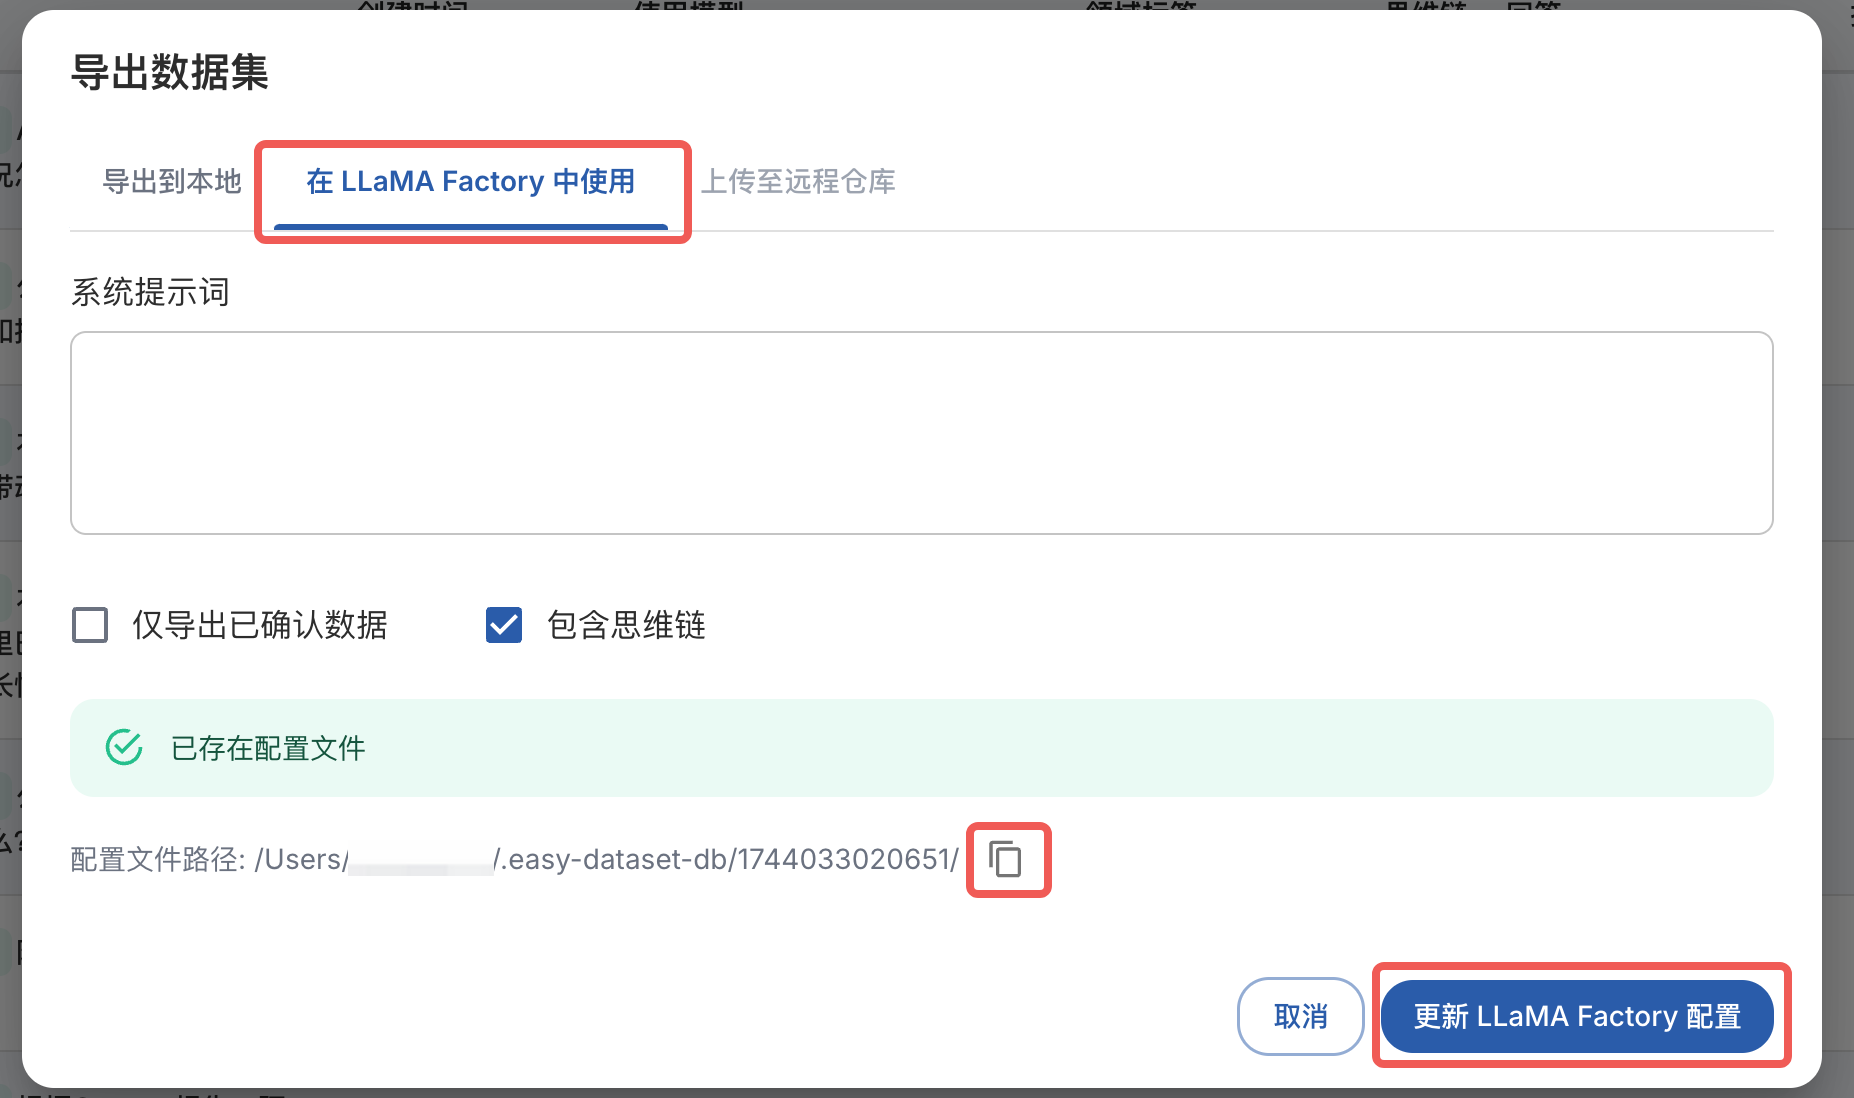
- 在导出配置中选择在**** LLaMA Factory ****中使用,点击更新**** LLaMA Factory ****配置,即可在对应文件夹下生成配置文件,点击复制按钮可以将配置路径复制到粘贴板。
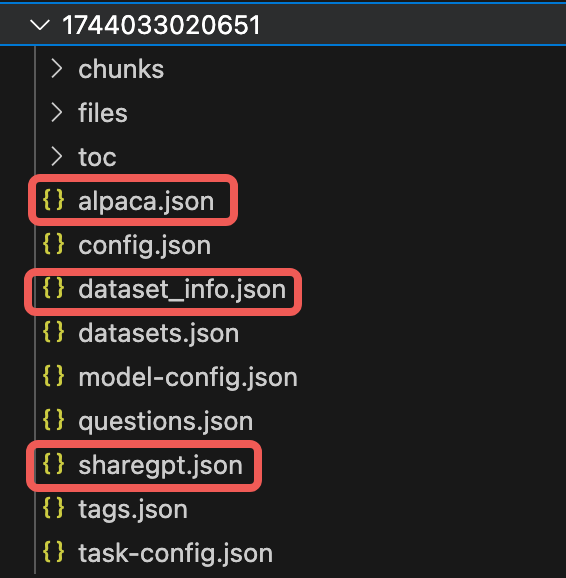
在配置文件路径对应的文件夹中可以看到生成的数据文件,其中主要关注以下三个文件
dataset_info.json:LLaMA Factory 所需的数据集配置文件
alpaca.json:以 Alpaca 格式组织的数据集文件
sharegpt.json:以 Sharegpt 格式组织的数据集文件
其中 alpaca 和 sharegpt 格式均可以用来微调,两个文件内容相同。
2 使用 LLaMA Factory 微调 Qwen2.5-3B-Instruct 模型
2.1 安装 LLaMA Factory
- 创建实验所需的虚拟环境(可选)
conda create -n llamafactory python=3.10- 从 GitHub 拉取 LLaMA Factory 仓库,安装环境依赖
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
pip install -e ".[torch,metrics,modelscope]"- 运行
llamafactory-cli version进行验证。若显示当前 LLaMA-Factory 版本,则说明安装成功
----------------------------------------------------------
| Welcome to LLaMA Factory, version 0.9.2                |
|                                                        |
| Project page: https://github.com/hiyouga/LLaMA-Factory |
----------------------------------------------------------
2.2 启动微调任务
- 确认 LLaMA Factory 安装完成后,运行以下指令启动 LLaMA Board
CUDA_VISIBLE_DEVICES=0 USE_MODELSCOPE_HUB=1 llamafactory-cli webui环境变量解释:
CUDA_VISIBLE_DEVICES:指定使用的显卡序号,默认全部使用
USE_MODELSCOPE_HUB:使用国内魔搭社区加速模型下载,默认不使用
启动成功后,在控制台可以看到以下信息,在浏览器中输入 http://localhost:7860 进入 Web UI 界面。
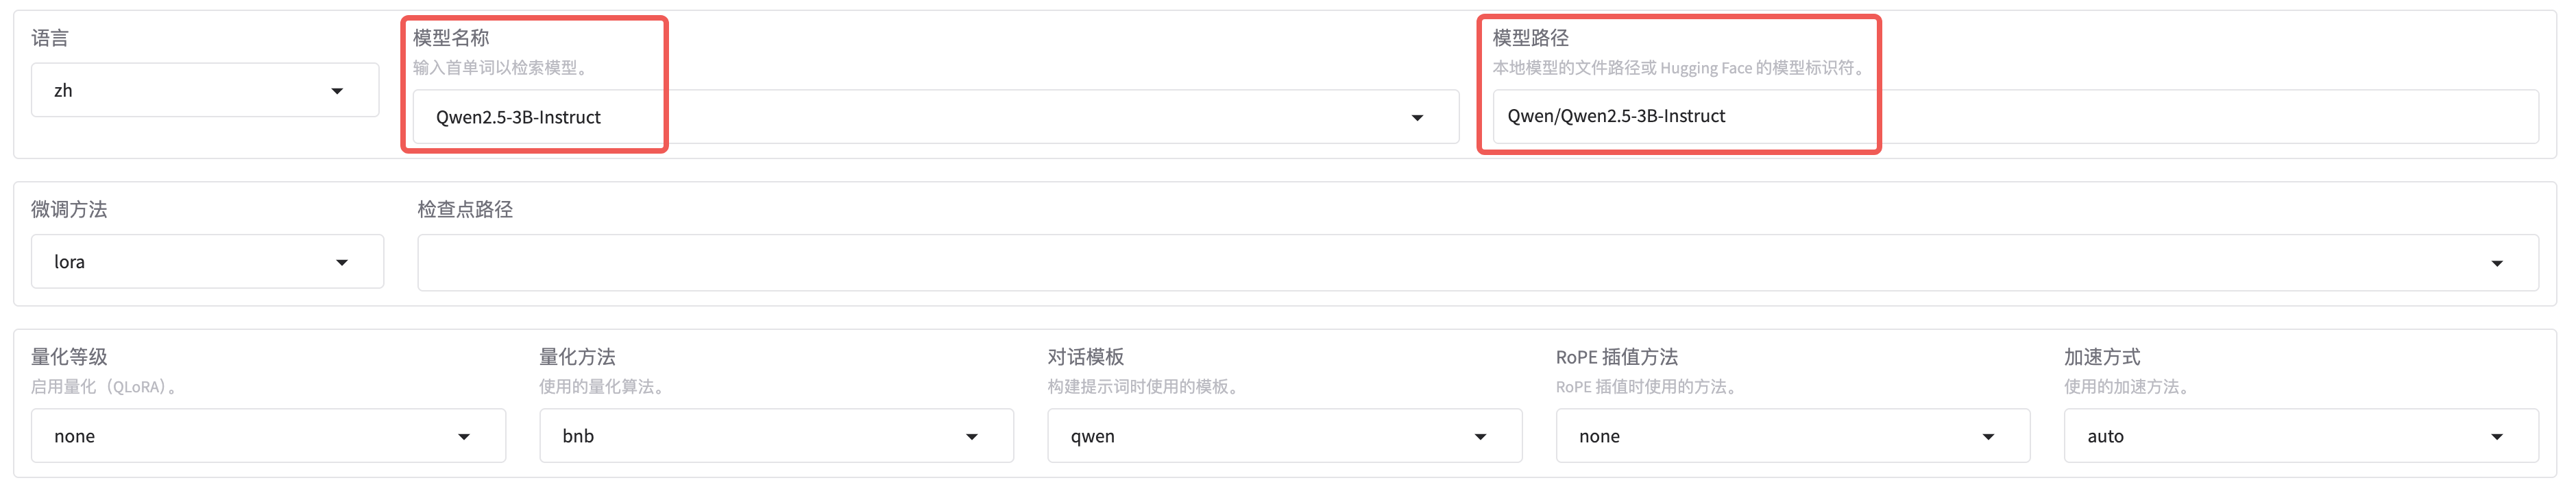
- 进入 Web UI 界面后,选择模型为 Qwen2.5-3B-Instruct,模型路径可填写本地绝对路径,不填则从互联网下载
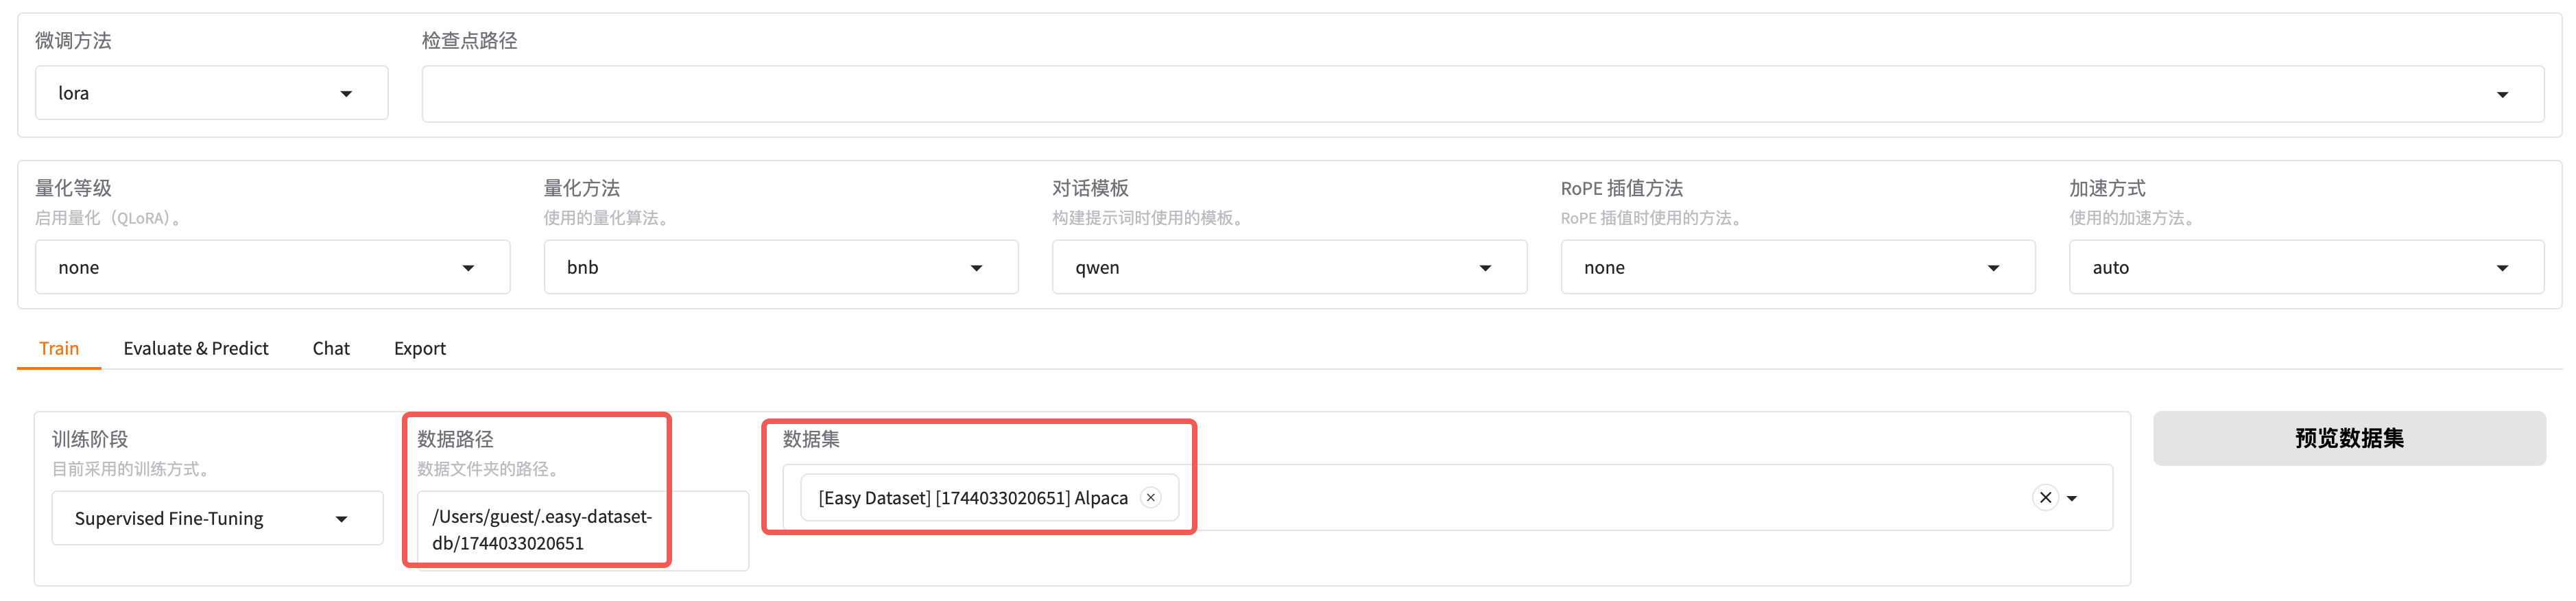
- 将数据路径改为使用 Easy Dataset 导出的配置路径,选择 Alpaca 格式数据集
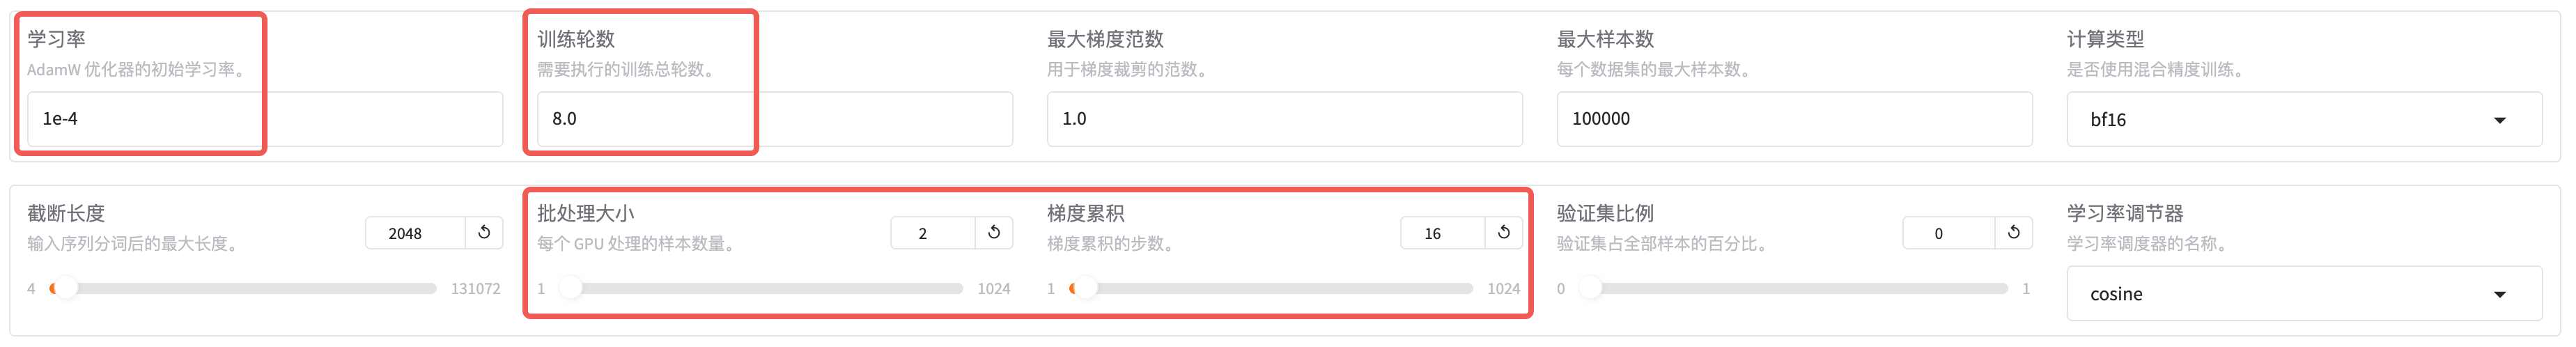
- 为了让模型更好地学习数据知识,将学习率改为 1e-4,训练轮数提高到 8 轮。批处理大小和梯度累计则根据设备显存大小调整,在显存允许的情况下提高批处理大小有助于加速训练,一般保持批处理大小×梯度累积×显卡数量等于 32 即可
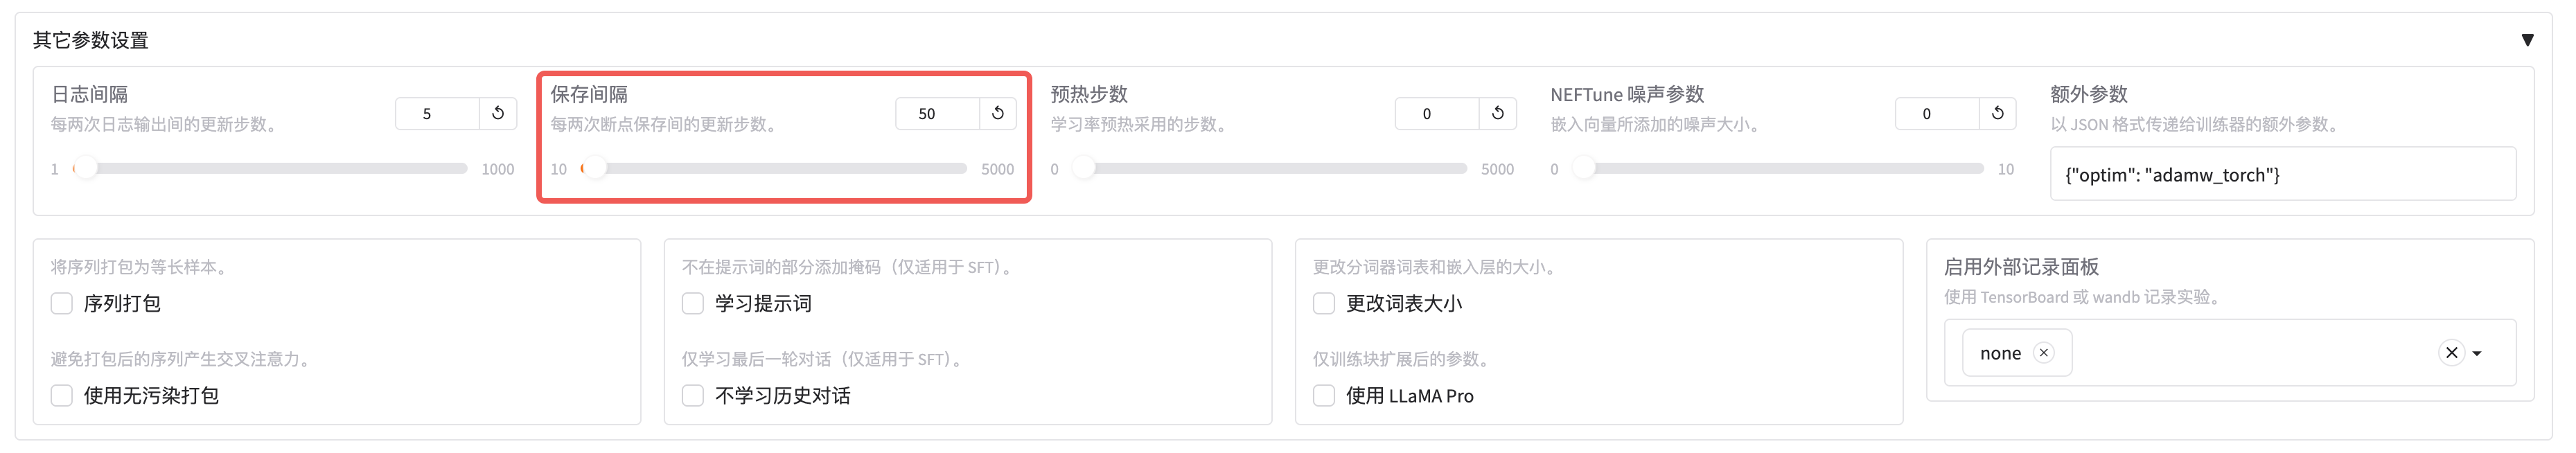
- 点击其他参数设置,将保存间隔设置为 50,保存更多的检查点,有助于观察模型效果随训练轮数的变化
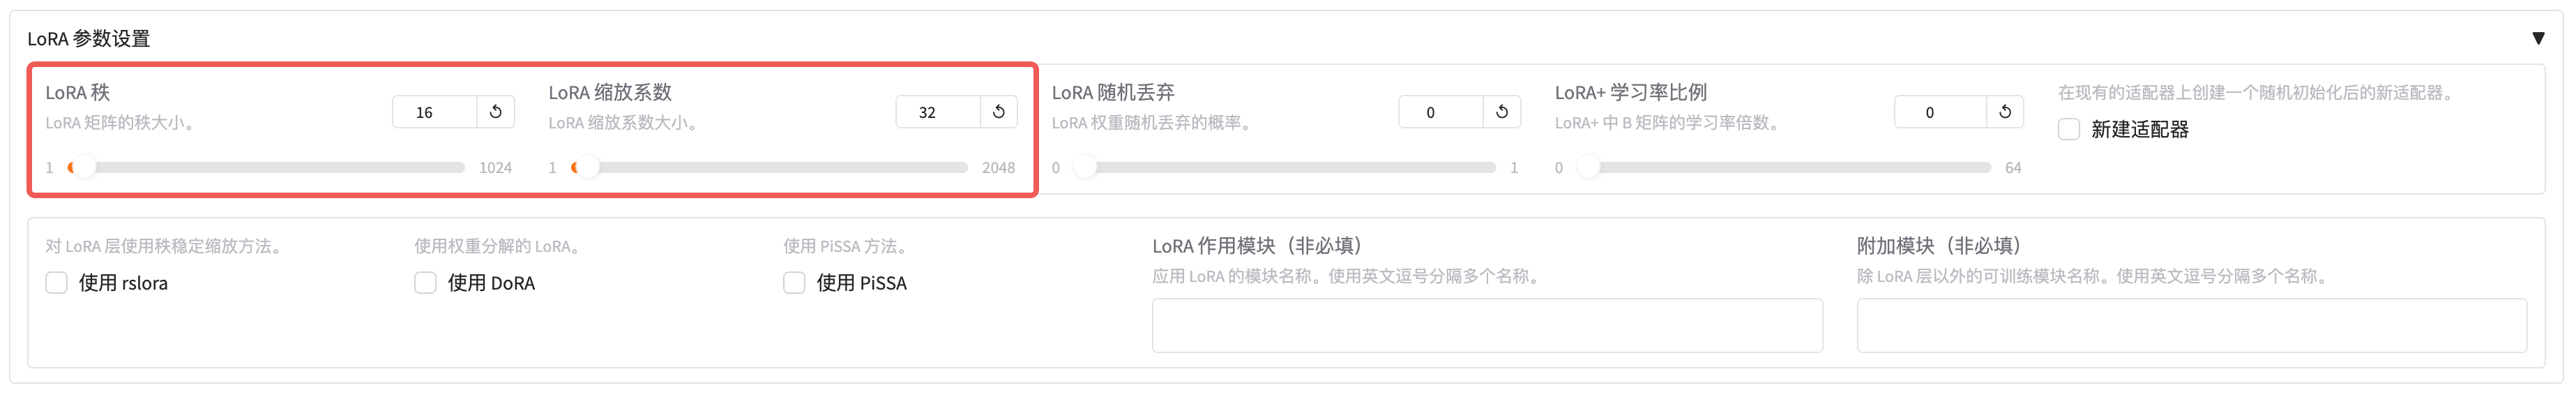
- 点击 LoRA 参数设置,将 LoRA 秩设置为 16,并把 LoRA 缩放系数设置为 32
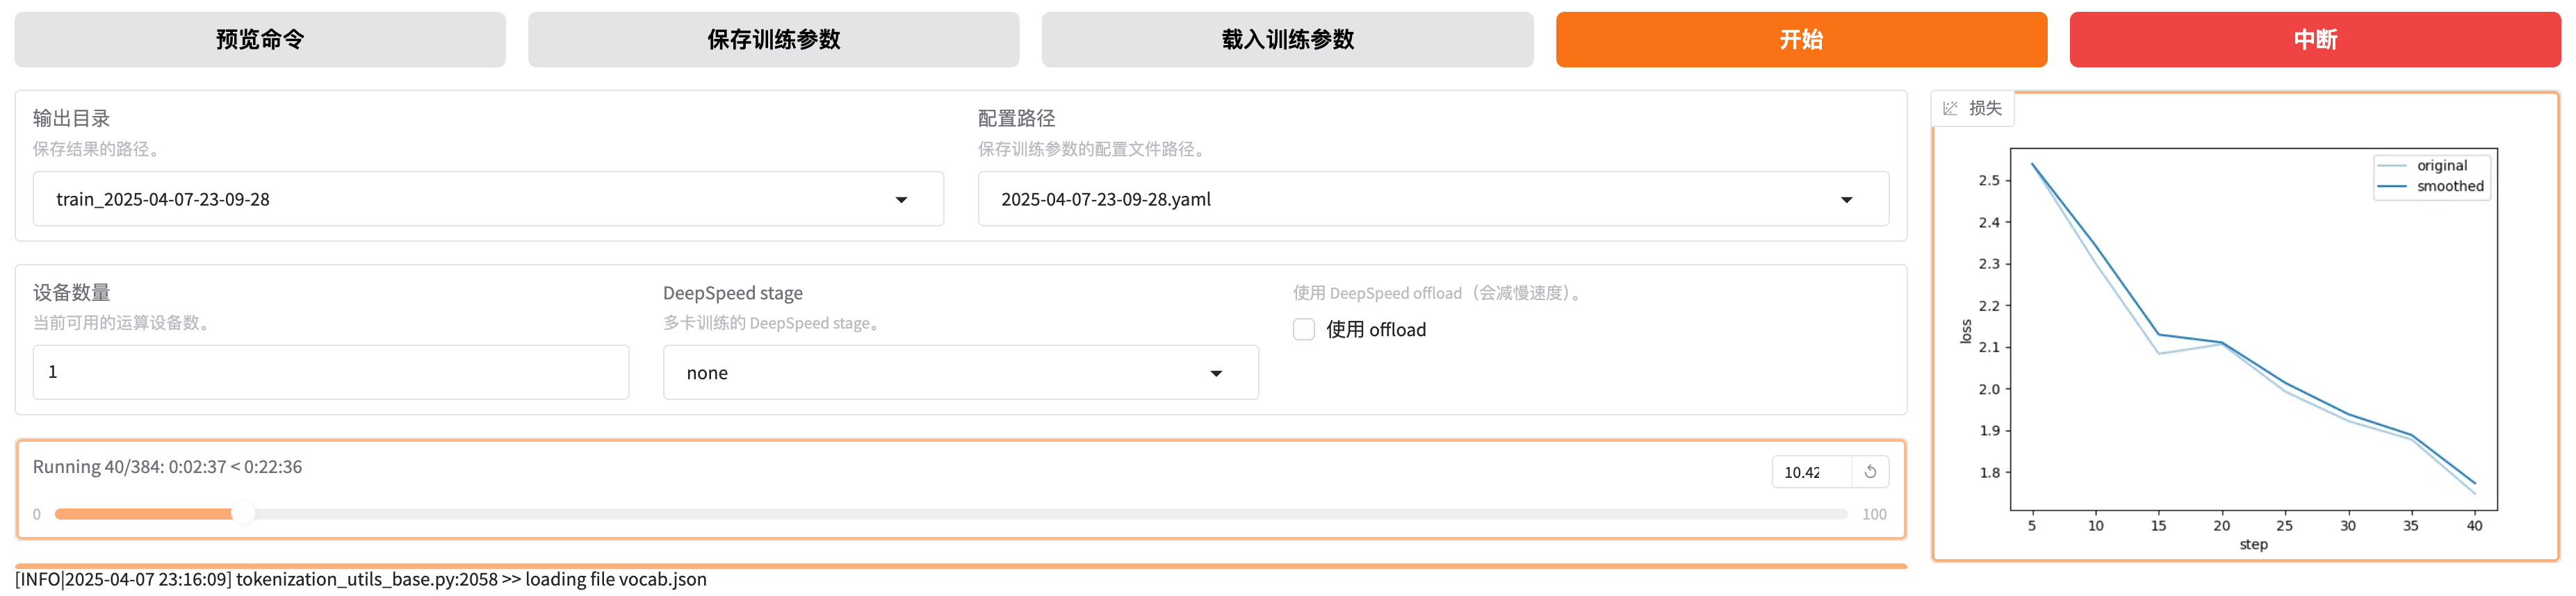
- 点击开始按钮,等待模型下载,一段时间后应能观察到训练过程的损失曲线
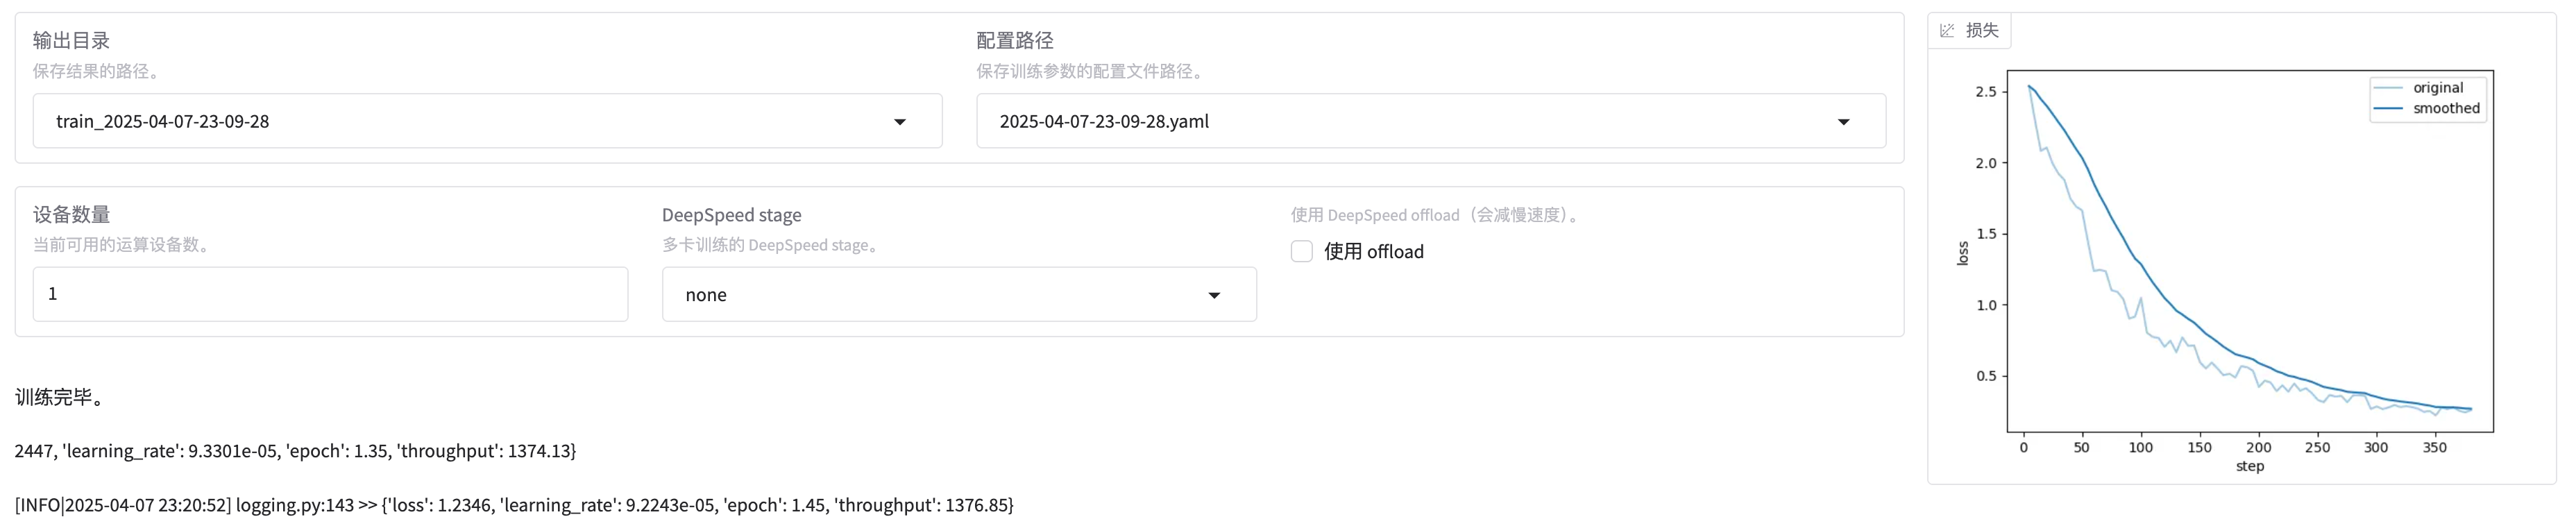
- 等待模型训练完毕,视显卡性能,训练时间可能在 20-60 分钟不等
2.3 验证微调效果
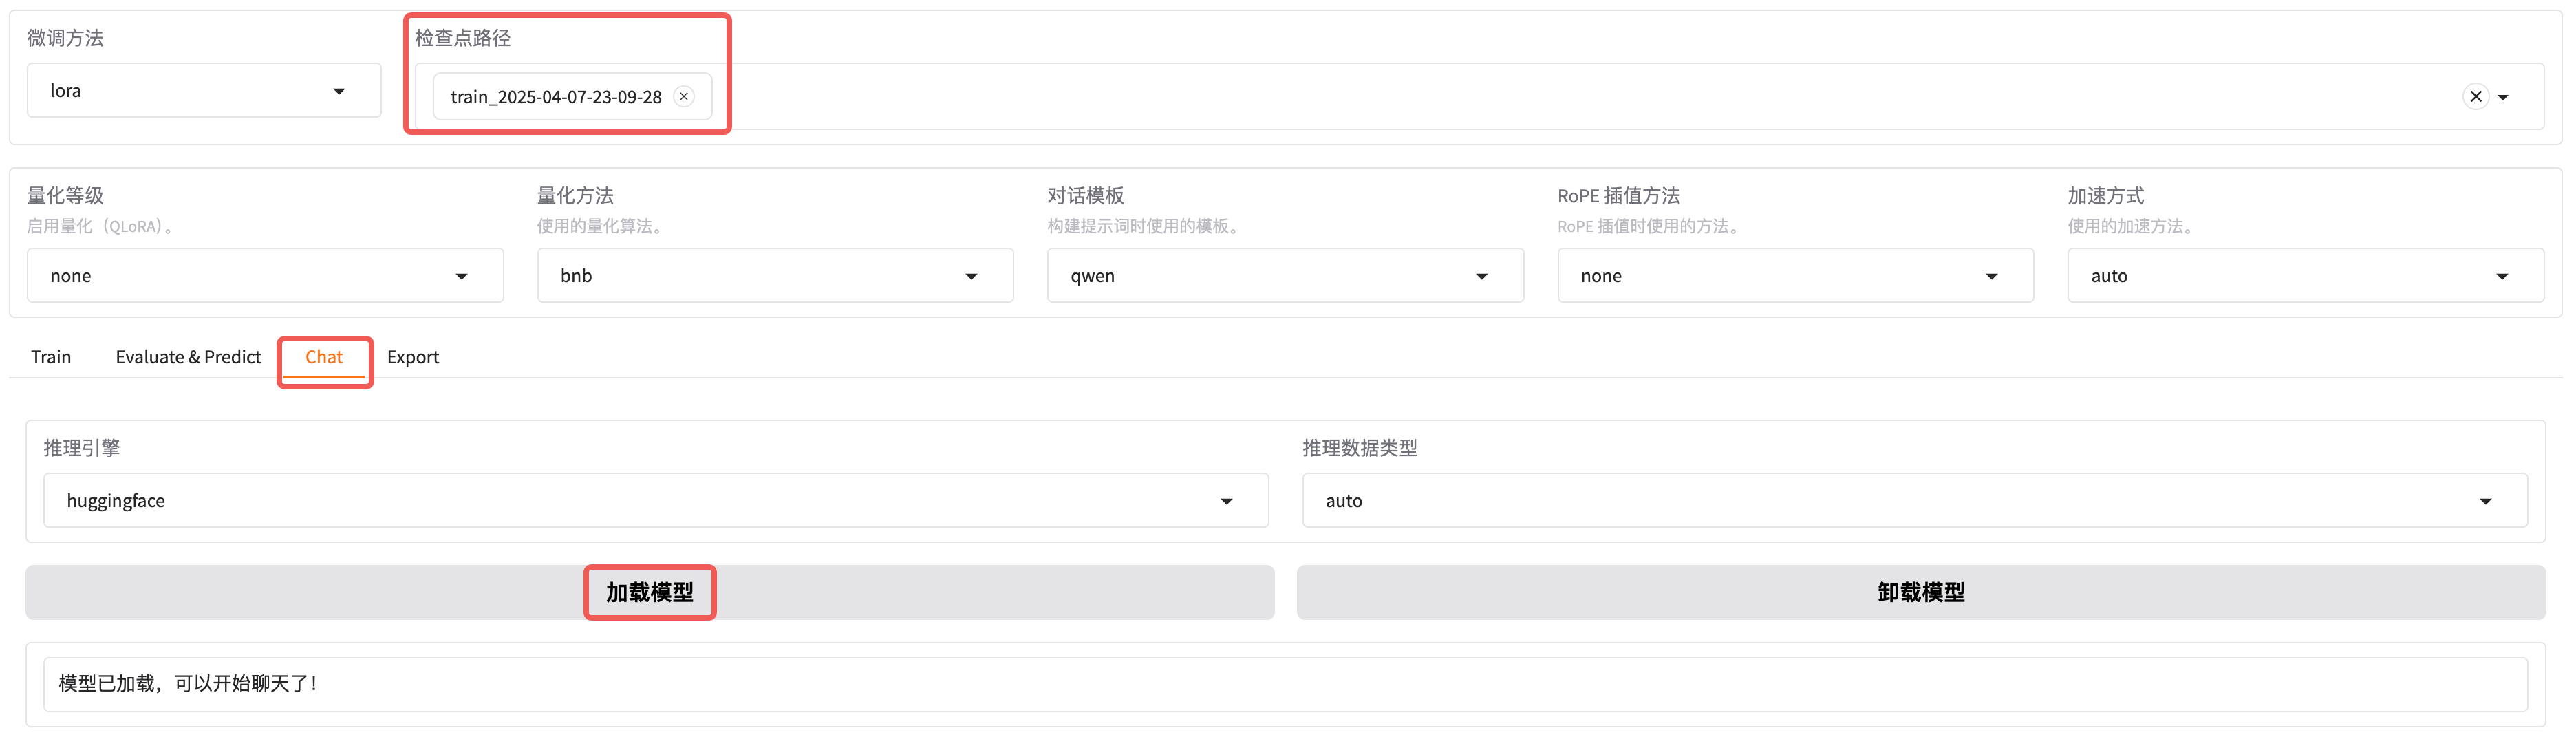
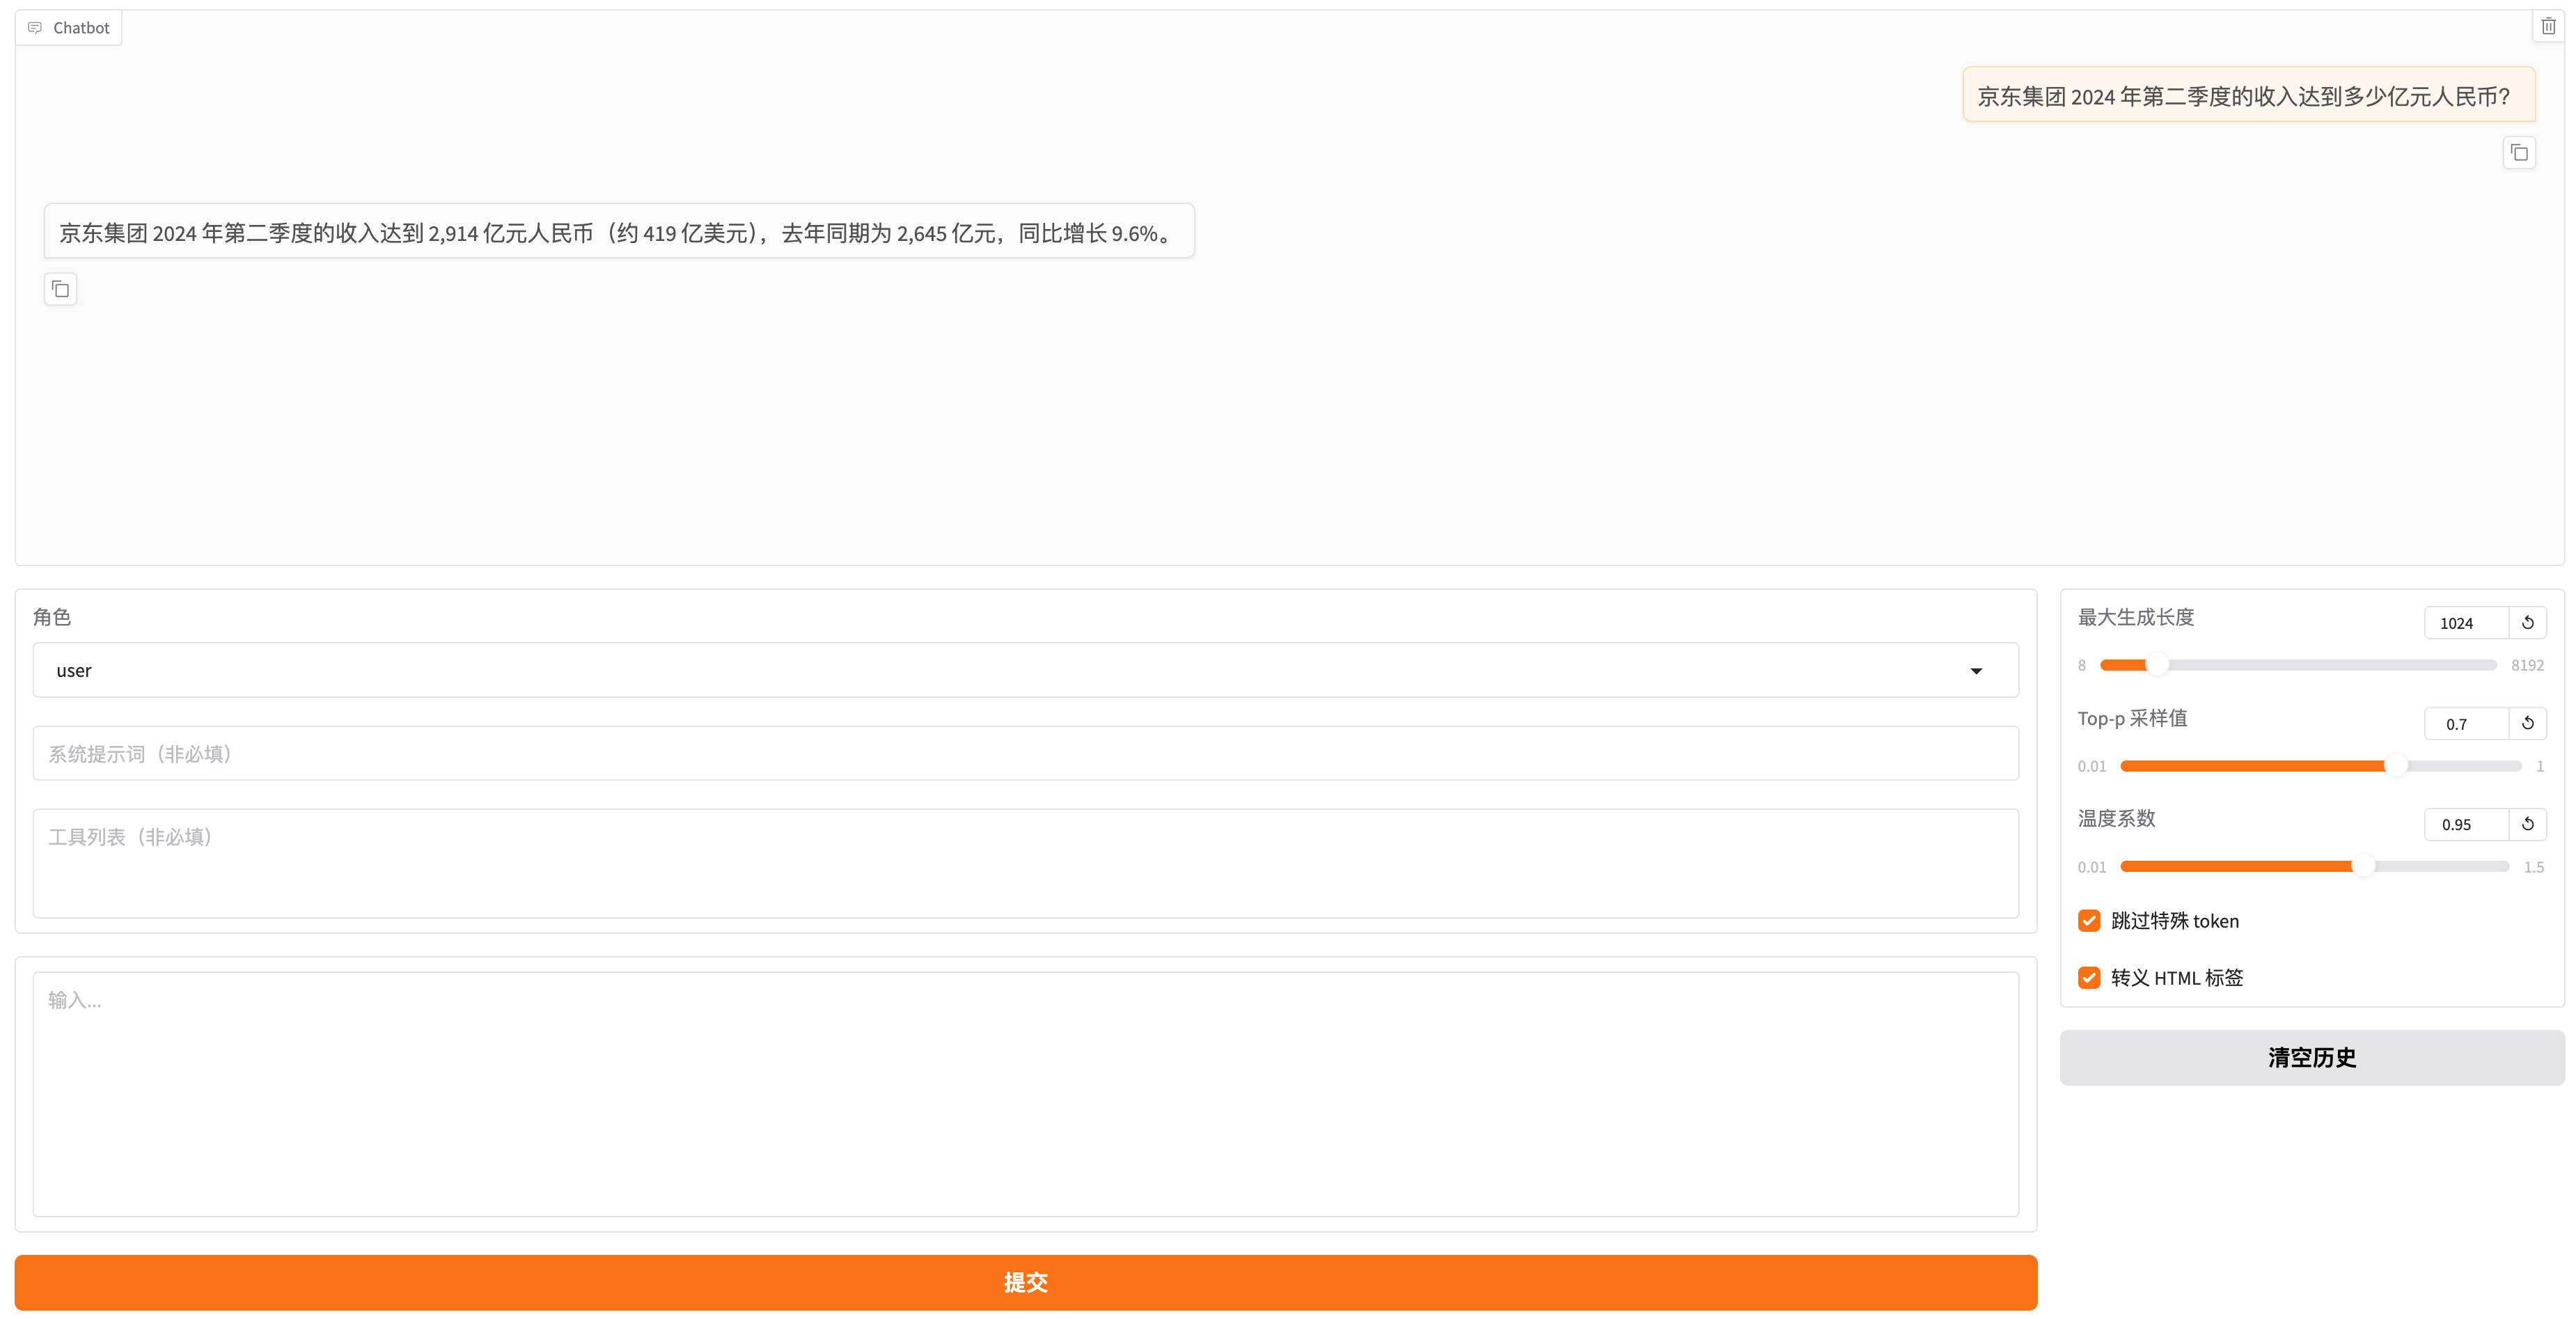
- 选择检查点路径为刚才的输出目录,打开 Chat 页面,点击加载模型
- 在下方的对话框中输入问题后,点击提交与模型进行对话,经与原始数据比对发现微调后的模型回答正确
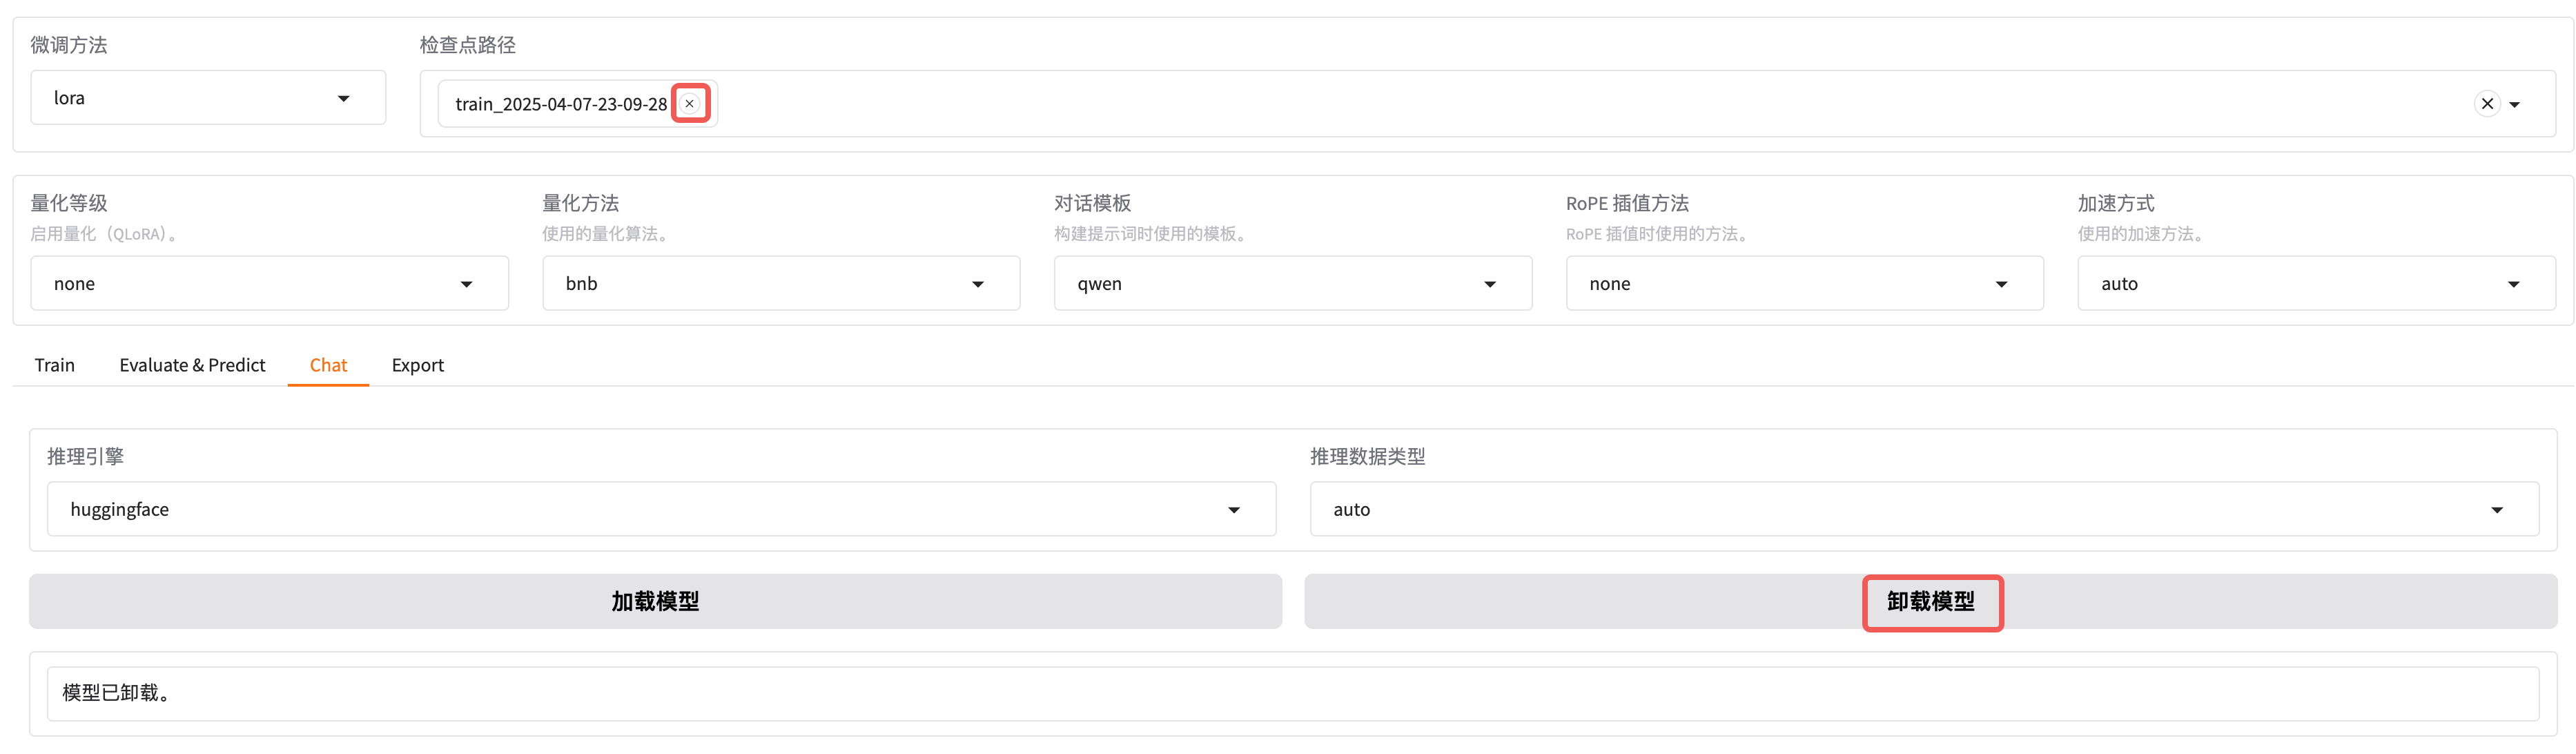
- 点击卸载模型将微调后的模型卸载,清空检查点路径,点击加载模型加载微调前的原始模型
- 输入相同的问题与模型进行对话,发现原始模型回答错误,证明微调有效
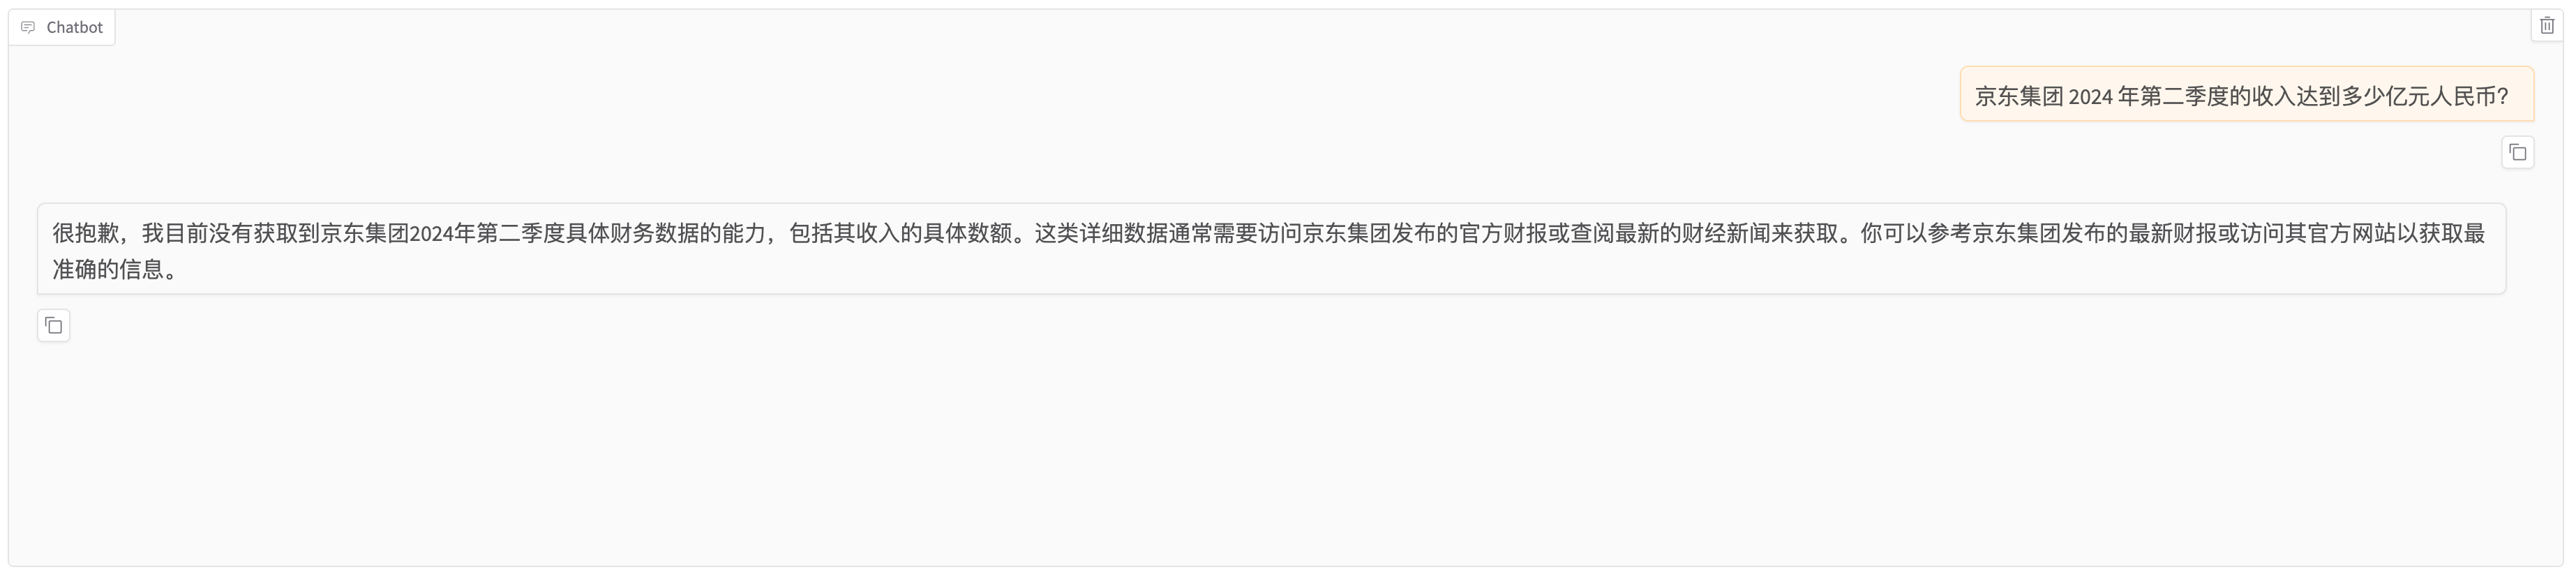
3B 模型的微调效果相对有限,此处仅用作教程演示。如果希望得到更好的结果,建议在资源充足的条件下尝试 7B/14B 模型。
欢迎大家关注 GitHub 仓库:
Easy Dataset: https://github.com/ConardLi/easy-dataset
LLaMA Factory: https://github.com/hiyouga/LLaMA-Factory