
LLaMA-Factory 微调训练使用指南
项目背景
开源大模型如LLaMA,Qwen,Baichuan等主要都是使用通用数据进行训练而来,其对于不同下游的使用场景和垂直领域的效果有待进一步提升,衍生出了微调训练相关的需求,包含预训练(pt),指令微调(sft),基于人工反馈的对齐(rlhf)等全链路。
但大模型训练对于显存和算力的要求较高,同时也需要下游开发者对大模型本身的技术有一定了解,具有一定的门槛。
LLaMA-Factory项目的目标是整合主流的各种高效训练微调技术,适配市场主流开源模型,形成一个功能丰富,适配性好的训练框架。
项目提供了多个高层次抽象的调用接口,包含多阶段训练,推理测试,benchmark评测,API Server等,使开发者开箱即用。同时借鉴 Stable Diffsion WebUI相关,本项目提供了基于gradio的网页版工作台,方便初学者可以迅速上手操作,训练调参出自己的第一个模型。
本教程目标
以Qwen模型 和 Linux + RTX 4060 8GB环境,LoRA+sft训练阶段为例子,帮助开发者迅速浏览和实践本项目会涉及到的常见若干个功能,包括
1. 前置准备及模型下载
2. 原始模型加载测试
3. 数据集构建
4. 基于LoRA的sft指令微调
5. 动态合并LoRA的推理
6. 批量预测和训练效果评估
7. LoRA模型合并导出
8. 一站式webui board的使用
9. API Server的启动与调用
10. 大模型主流评测 benchmark
11. 导出GGUF格式,使用Ollama推理
本教程大部分内容都可以通过LLaMA-Factory下的 README.md, data/README.md,examples文件夹下的示例脚本得到,遇到问题请先阅读项目原始相关资料。
关于全参训练,flash-attention加速, deepspeed,rlhf,多模态模型训练等更高阶feature的使用,后续会有额外的教程来介绍
1 前置准备
训练顺利运行需要包含4个必备条件
- 机器本身的硬件和驱动支持(包含显卡驱动,网络环境等)
- 本项目及相关依赖的python库的正确安装(包含CUDA, PyTorch等)
- 目标训练模型文件的正确下载
- 训练数据集的正确构造和配置
1.1 硬件环境校验
显卡驱动和CUDA的安装,网络教程很多,不在本教程范围以内。
使用以下命令做最简单的校验
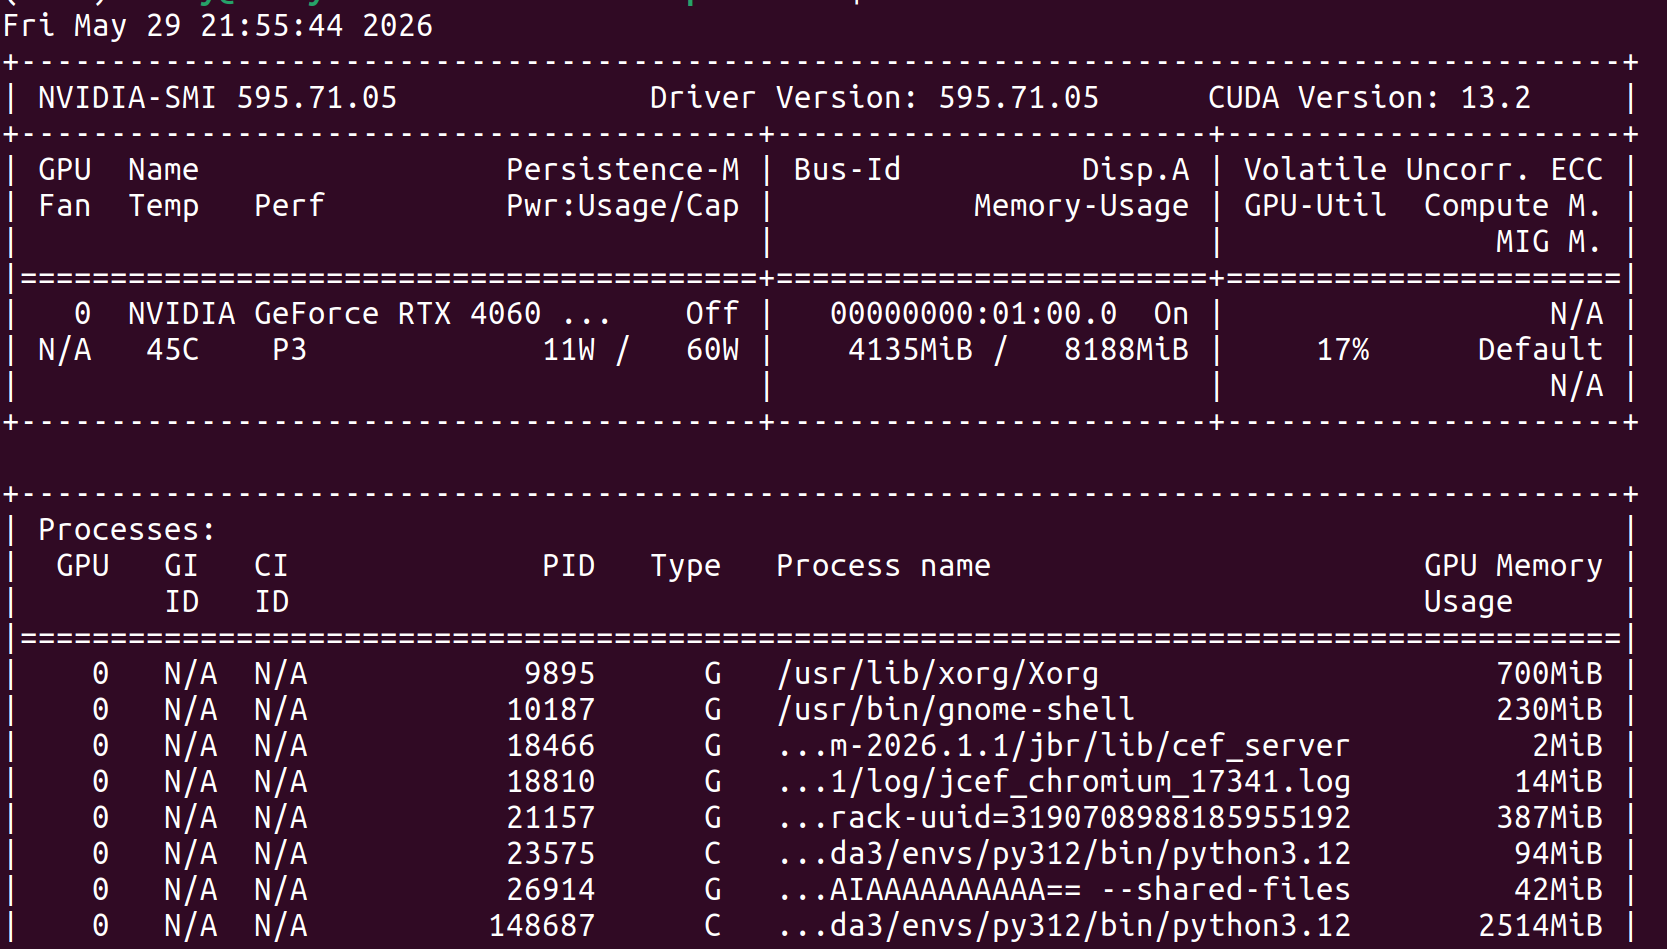
nvidia-smi预期输出如图,显示GPU当前状态和配置信息。
新手建议是3090和4090起步,可以比较容易地训练比较主流的入门级别大模型 7B和8B版本。
7B 大概需要显示8G,可以通过 nvidia-smi 查看 占用情况。如果GPU memory 内存不足,那只能使用小型的 模型
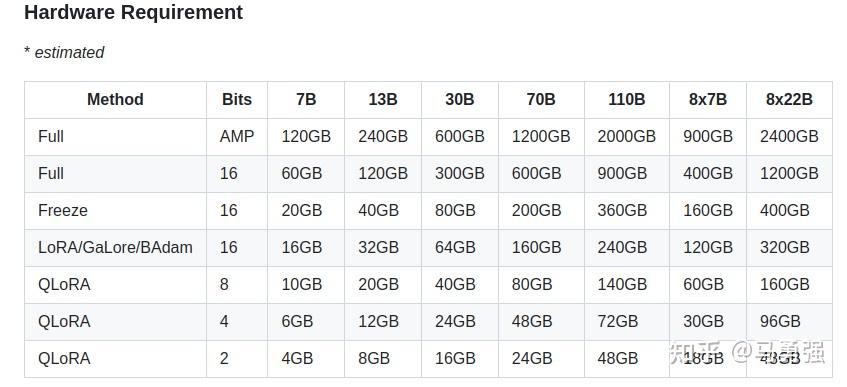
那多大的模型用什么训练方式需要多大的GPU呢,可参考 https://github.com/hiyouga/LLaMA-Factory?tab=readme-ov-file#hardware-requirement
1.2 CUDA和PyTorch环境校验
请参考项目的readme进行安装
https://github.com/hiyouga/LLaMA-Factory?tab=readme-ov-file#dependence-installation
2024年51期间系统版本有较大升级,2024-06-07 号的安装版本命令如下 ;
请注意conda环境的激活。
git clone https://github.com/hiyouga/LLaMA-Factory.git
conda create -n llama_factory python=3.10
conda activate llama_factory
cd LLaMA-Factory
pip install -e '.[torch,metrics]'
上述的安装命令完成了如下几件事
- 新建一个LLaMA-Factory 使用的python环境(可选)
- 安装LLaMA-Factory 所需要的第三方基础库(requirements.txt包含的库)
- 安装评估指标所需要的库,包含nltk, jieba, rouge-chinese
- 安装LLaMA-Factory本身,然后在系统中生成一个命令 llamafactory-cli(具体用法见下方教程)
安装后使用以下命令做简单的正确性校验
- 校验1
import torch
print(torch.cuda.current_device())
print(torch.cuda.get_device_name(0))
print(torch.__version__)
预期输出如图
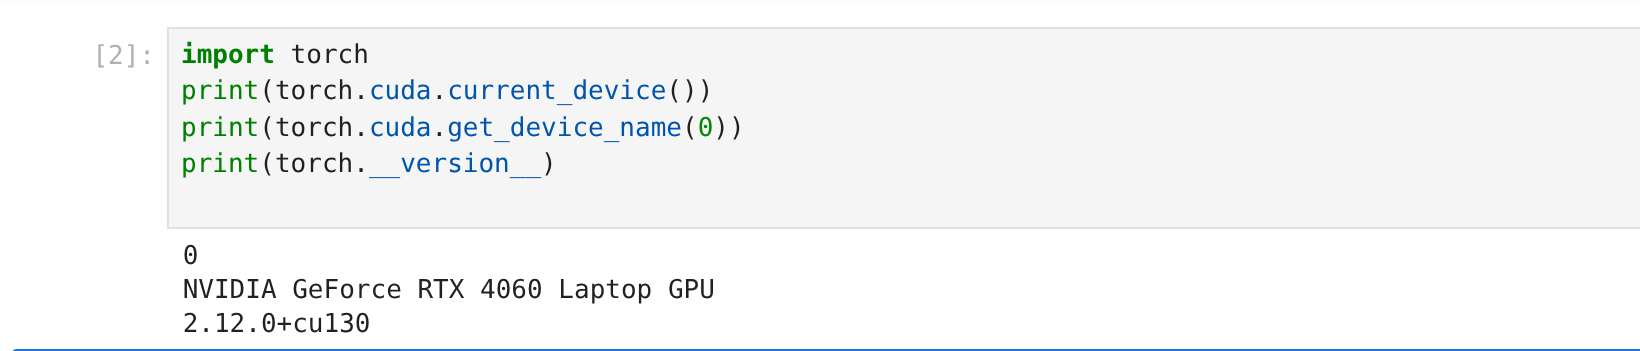
如果识别不到可用的GPU,则说明环境准备还有问题,需要先进行处理,才能往后进行。
- 校验2
同时对本库的基础安装做一下校验,输入以下命令获取训练相关的参数指导, 否则说明库还没有安装成功
llamafactory-cli train -h具体的参数介绍参考 https://llamafactory.readthedocs.io/zh-cn/latest/advanced/arguments.html
1.3 模型下载与可用性校验
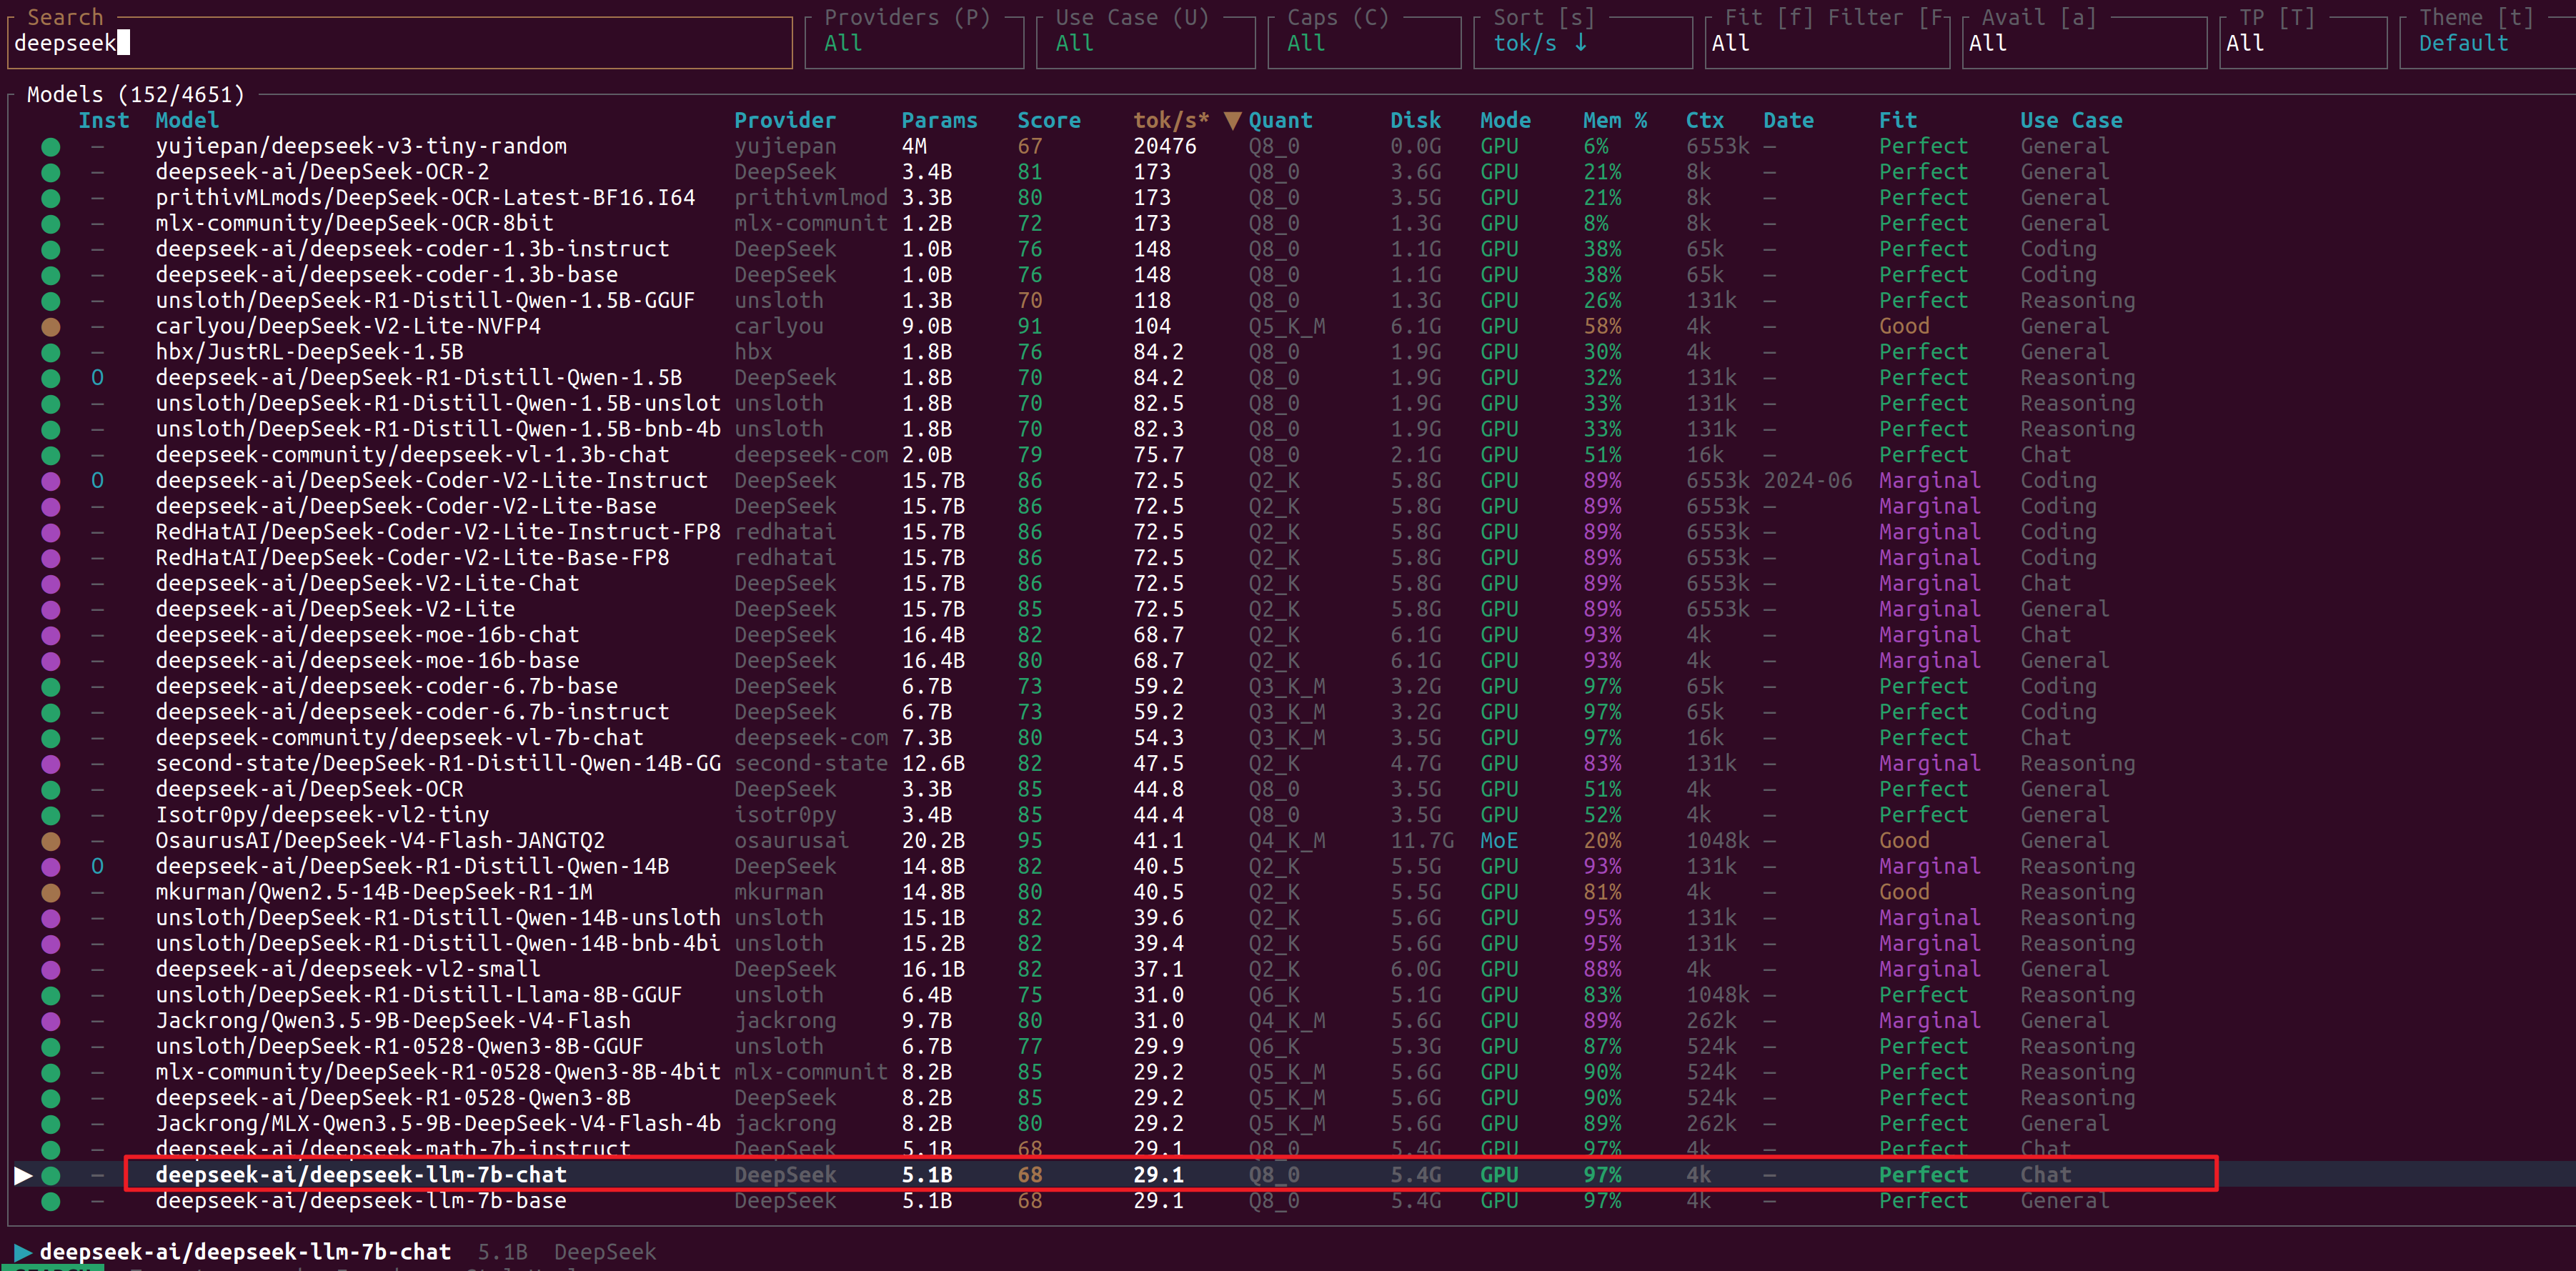
1.3.1 模型运行环境评估 llmfit
https://github.com/AlexsJones/llmfit/blob/main/README.zh.md
根据GPU 来选择合适自己电脑的学习模型。
1.3.2 模型下载
- 选择合适的模型
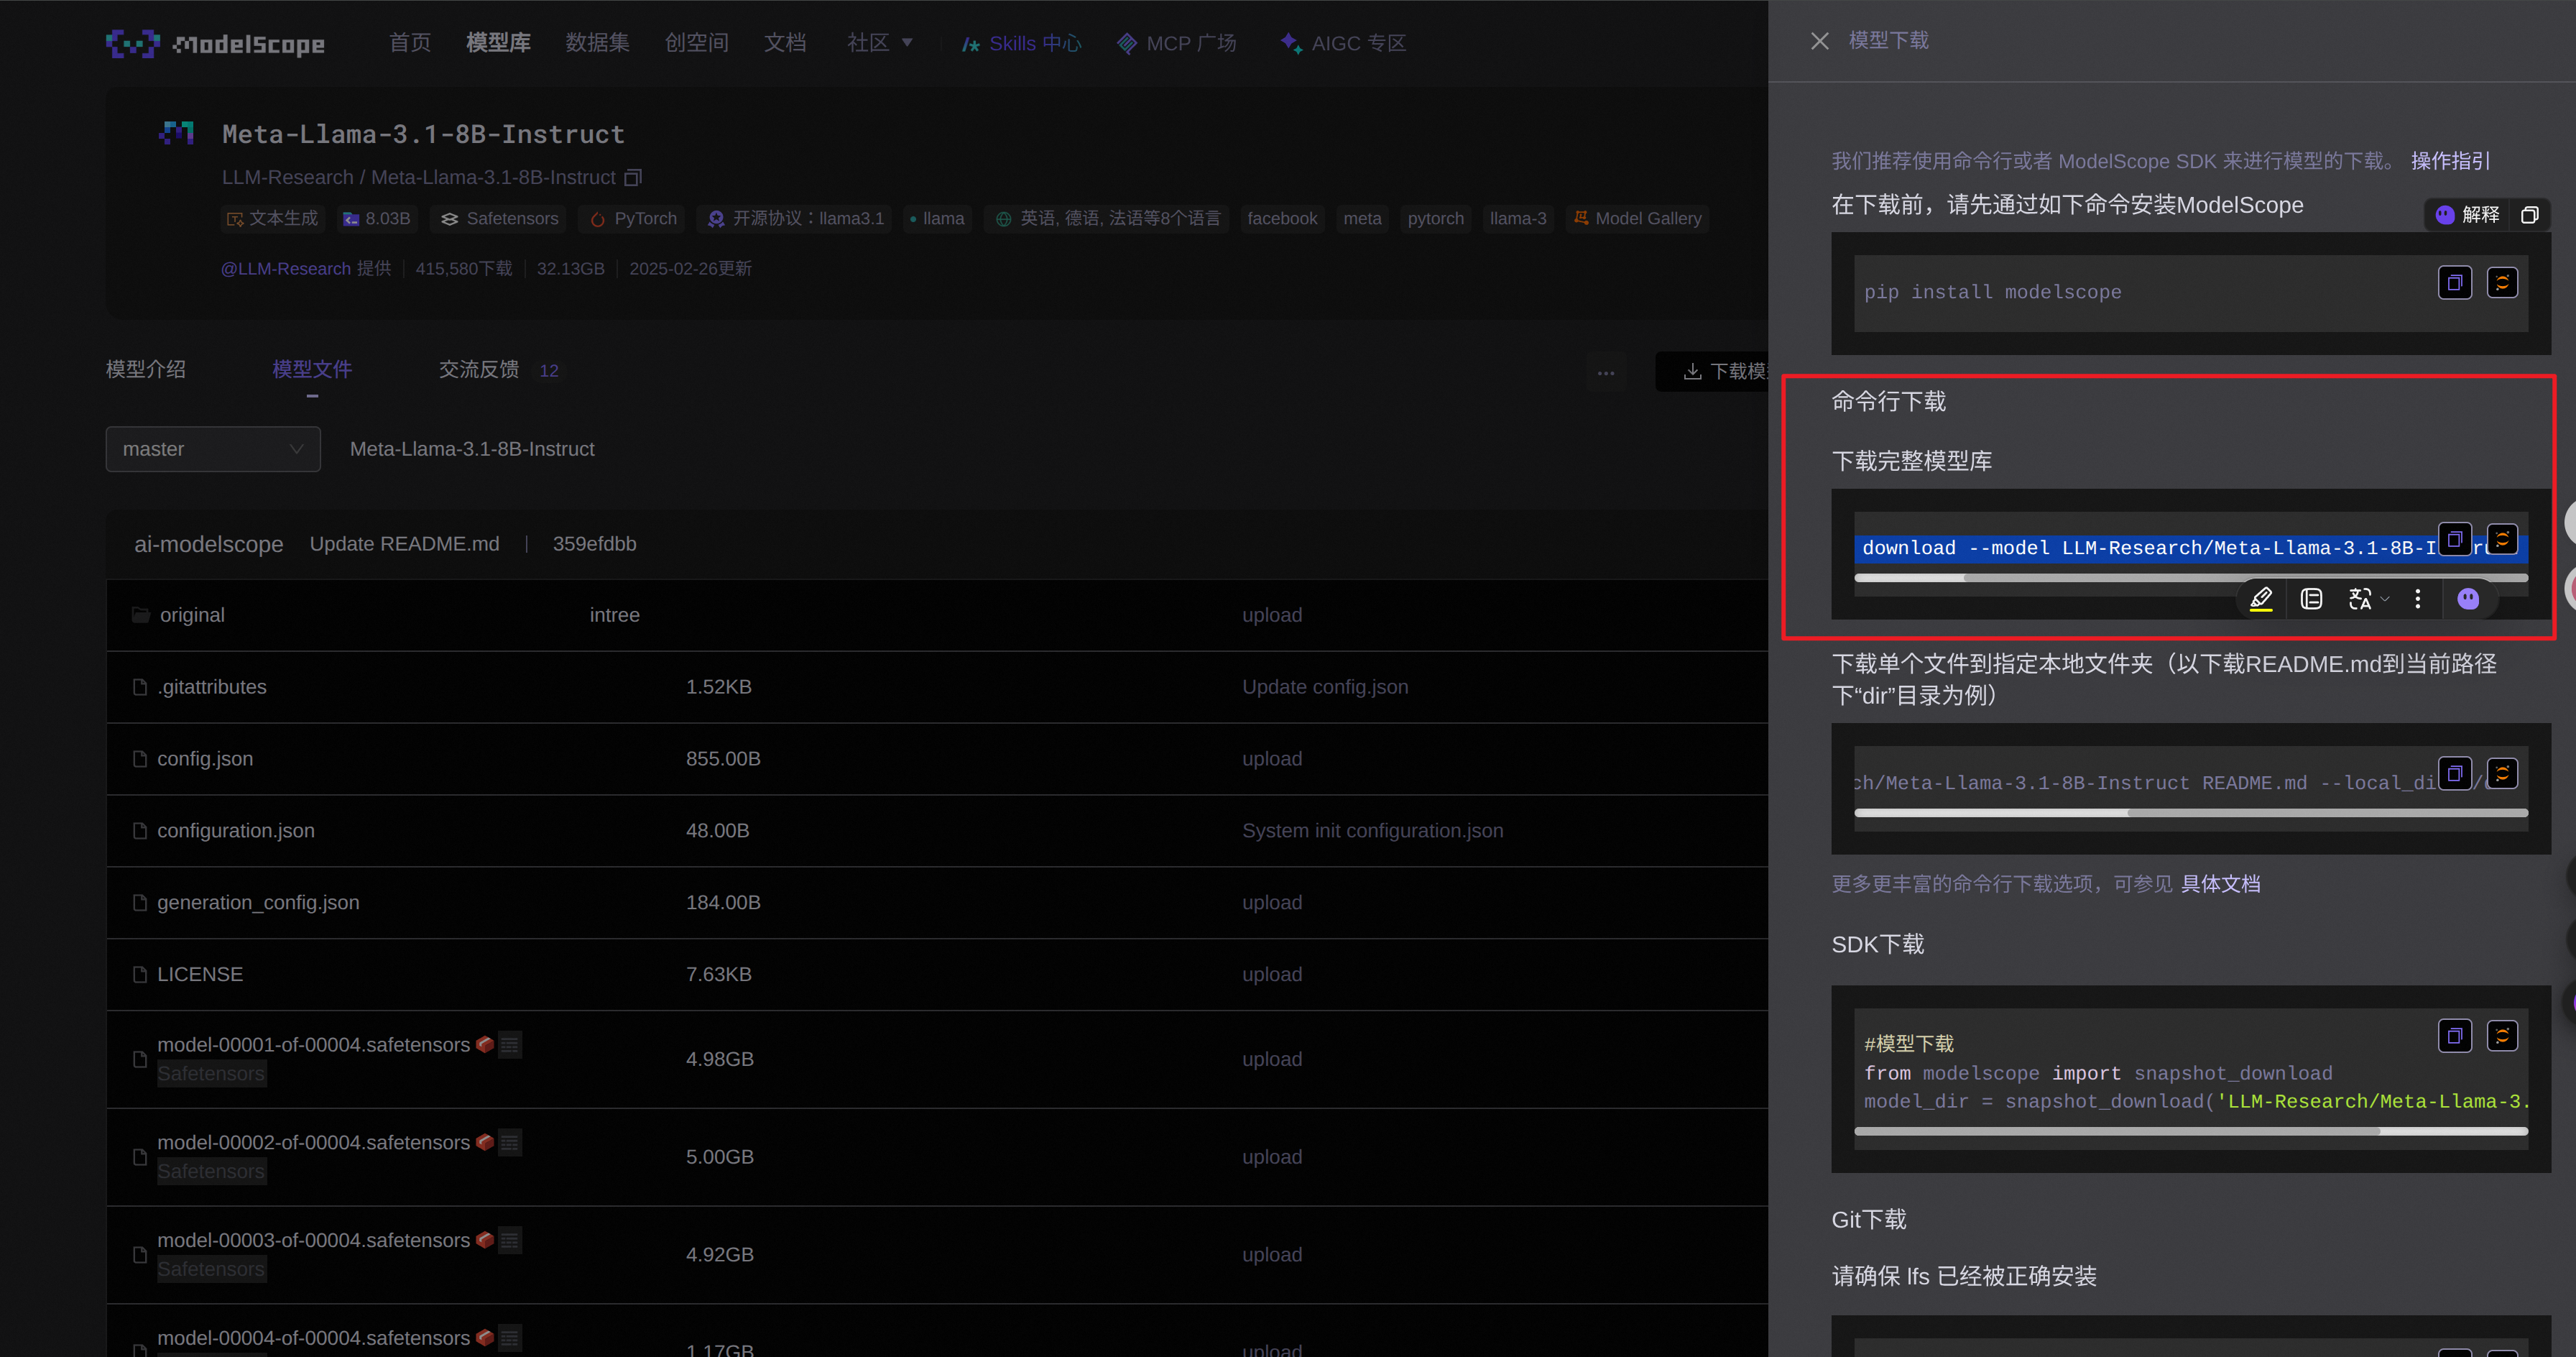
通过模型名称直接从huggingface 和modelscope下载模型,但这样不容易对模型文件进行统一管理,所以这里建议使用手动下载,然后后续使用绝对路径来控制使用哪个模型。
- modelscope 下载(适合中国大陆网络环境)
#前提是python 要安装 pip install modelscope
modelscope download --model deepseek-ai/deepseek-llm-7b-chat- 官方大模型 github地址
git clone https://www.modelscope.cn/deepseek-ai/deepseek-llm-7b-chat.git或者
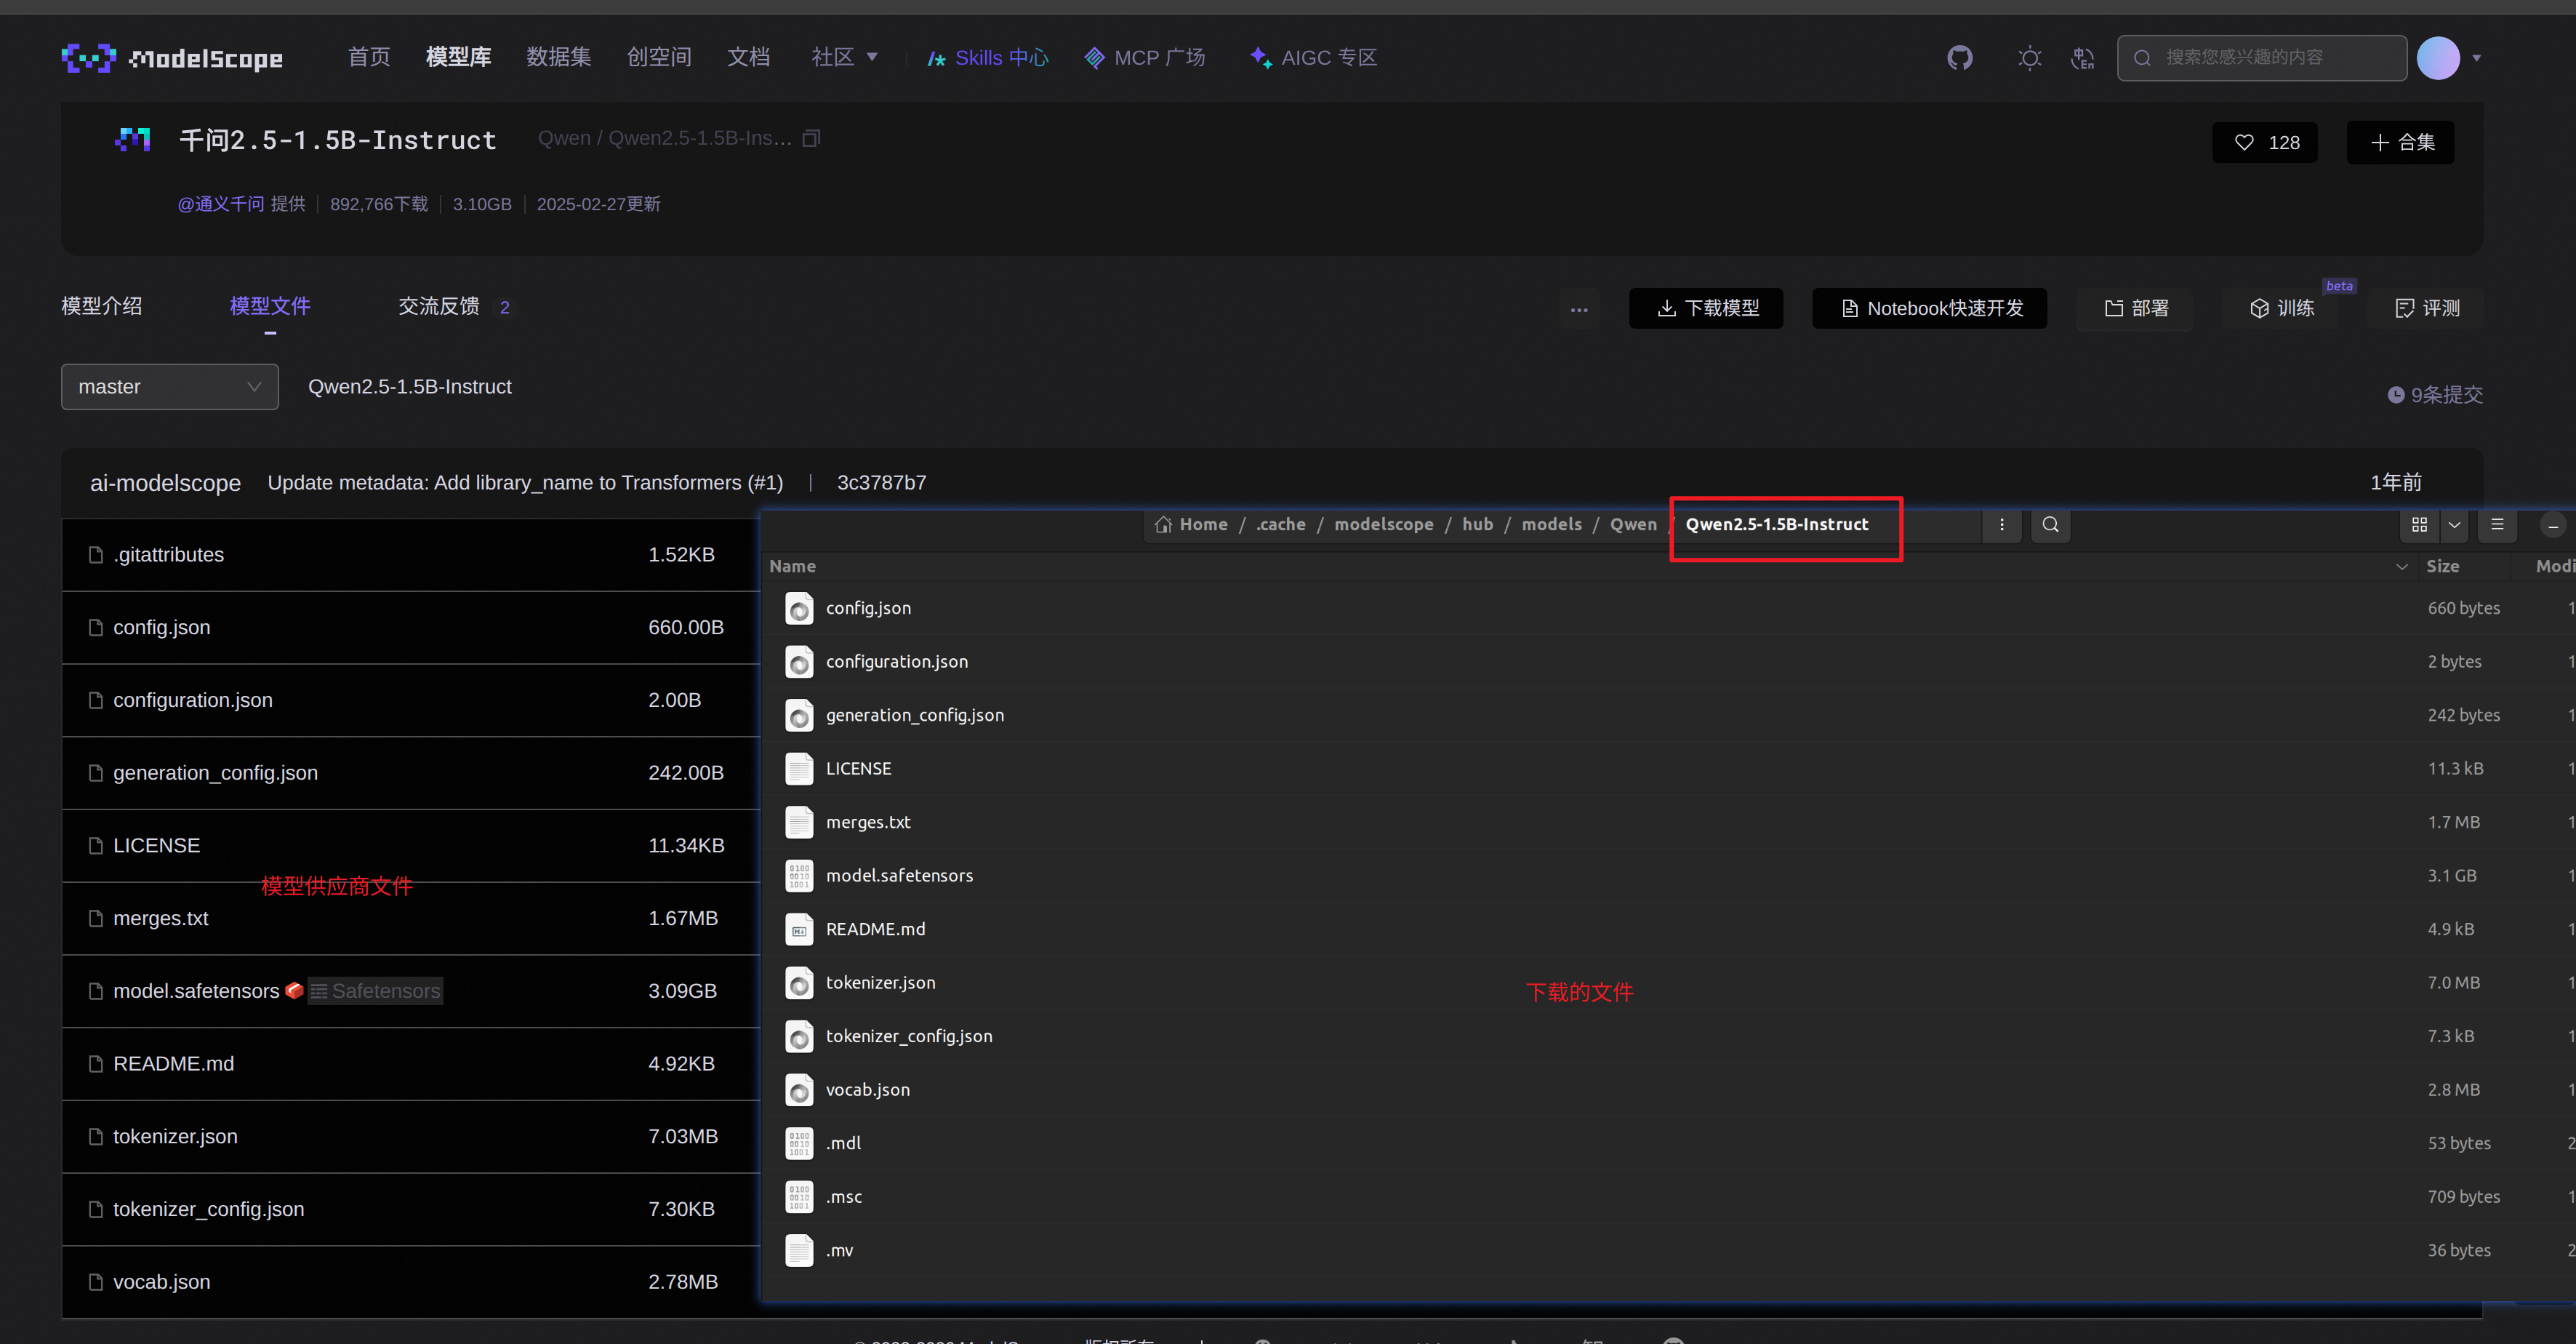
由于网络环境等原因,文件下载后往往会存在文件不完整的很多情况,下载后需要先做一下校验,校验分为两部分,第一先检查一下文件大小和文件数量是否正确,和原始的huggingface显示的做一下肉眼对比。
1.3.3 验证模型可用性
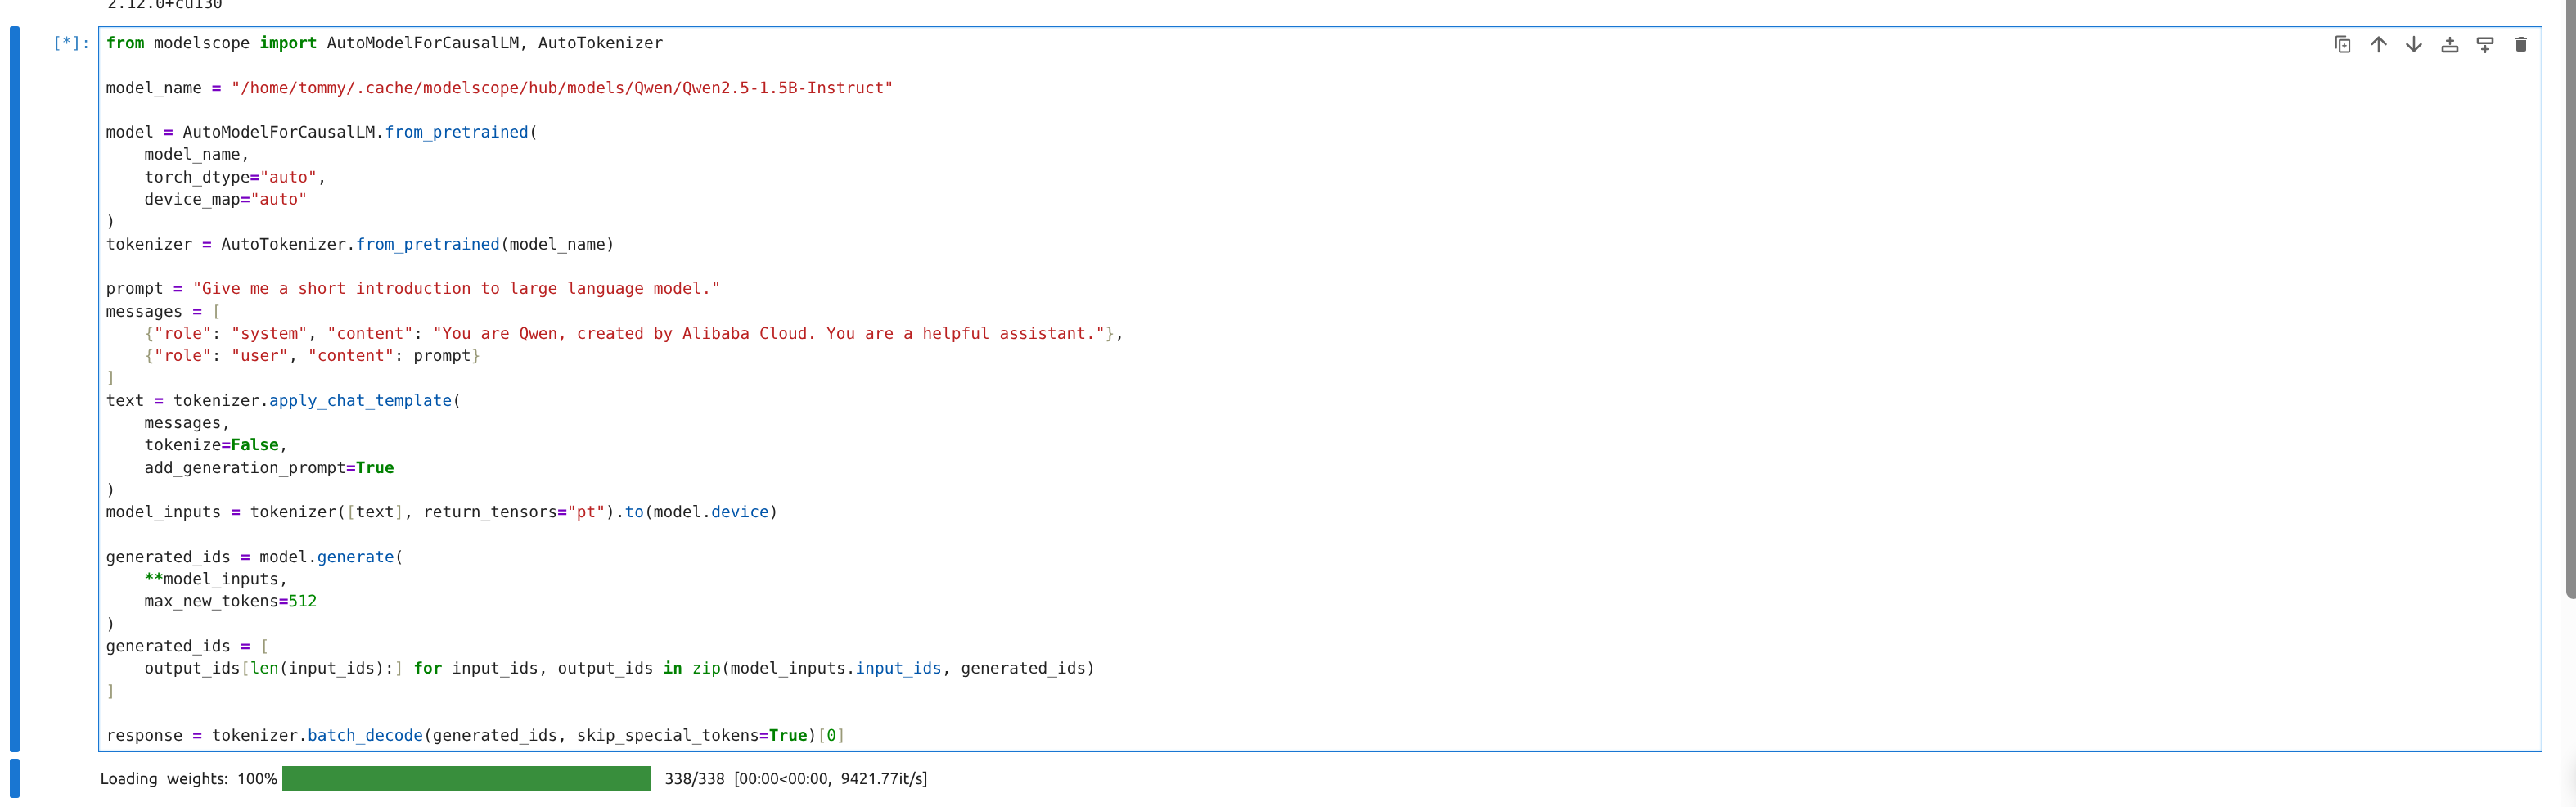
第二步是跑一下官方Readme.md里提供的原始推理demo,验证模型文件的正确性和transformers库等软件的可用
from modelscope import AutoModelForCausalLM, AutoTokenizer

model_name = "/home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct"

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

prompt = "Give me a short introduction to large language model."
messages = [
    {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant."},
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
加载模型文件成功
2 原始模型加载后测试-推理能力
在进行后续的环节之前,我们先使用推理模式,先验证一下LLaMA-Factory的推理部分是否正常。
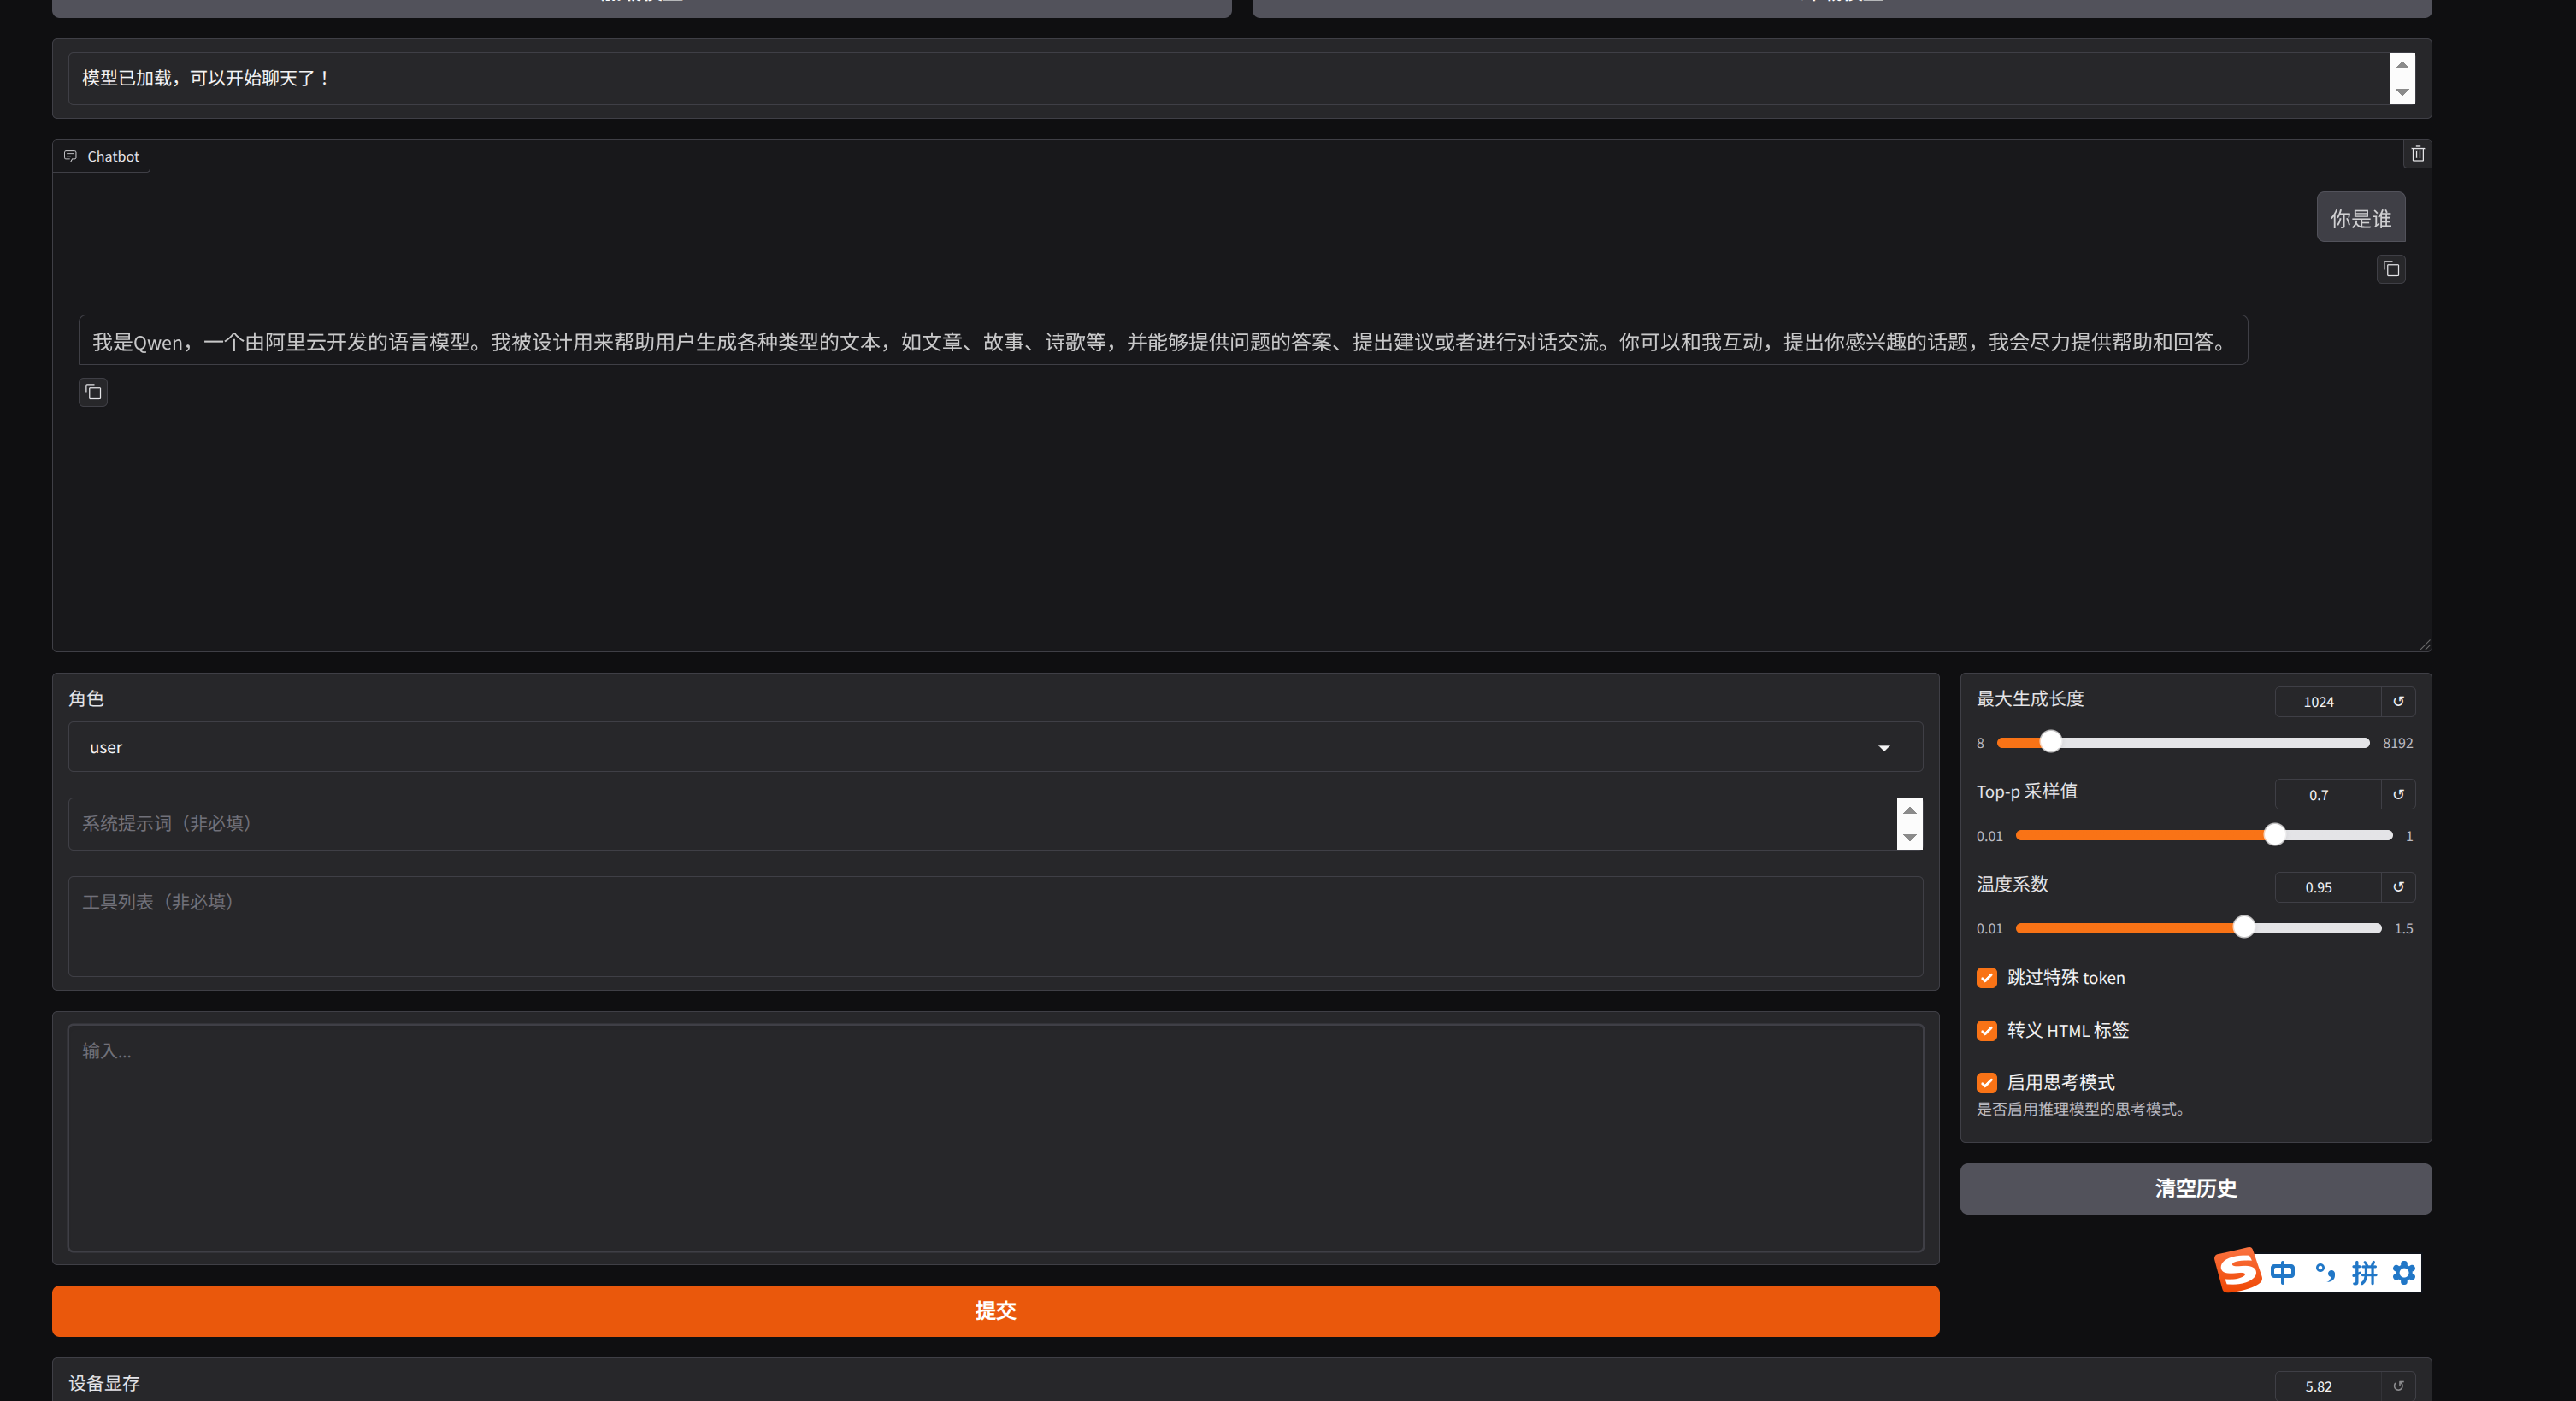
LLaMA-Factory 带了基于gradio开发的ChatBox推理页面, 帮助做模型效果的人工测试。
2.1 使用lmf 脚本参数命令
在LLaMA-Factory 目录下执行以下命令。
本脚本参数参考自 LLaMA-Factory/examples/inference/llama3.yaml at main · hiyouga/LLaMA-Factory
#启用前端版本纯推理的chat页面
#模型位置:本地下载的绝对路径
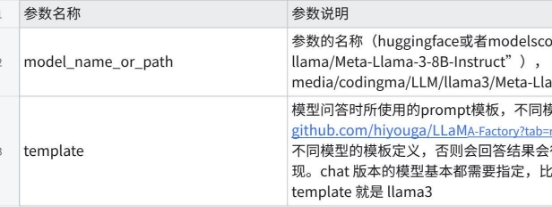
#模型问答时所使用的prompt模板,不同模型不同
llamafactory-cli webchat \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --template qwen
CUDA_VISIBLE_DEVICES=0 是指定了当前程序使用第0张卡,是指定全局变量的作用, 也可以不使用
本次及后续所有的程序的入口都是 llamafactory-cli,通过不同的参数控制实现什么功能,所有的可选项包括
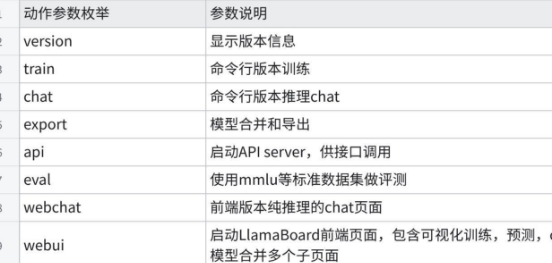
另外两个关键参数解释如下,后续的基本所有环节都会继续使用这两个参数
2.2 使用yaml 存放参数
当然也可以提前把相关的参数存在yaml文件里,比如
LLaMA-Factory/examples/inference/llama3.yaml at main · hiyouga/LLaMA-Factory, 本地位置是 examples/inference/qwen2_5.yaml,内容如下
#模型位置
model_name_or_path: /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-15B-Instruct
#webchat & chat 的模版
template: qwen
可以通过如下命令启动,其效果跟上面是一样的,但是更方便管理
#使用 当前目录 examples/inference/llama3.yaml 作为参数 启动 webchat
llamafactory-cli webchat examples/inference/qwen2_5.yaml

#约等于
llamafactory-cli webchat \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --template qwen
3 数据集构建
数据集的格式要求在不同的阶段是不同的,本教程以基于lora - sft阶段的数据集需求
- 系统自带的identity数据集
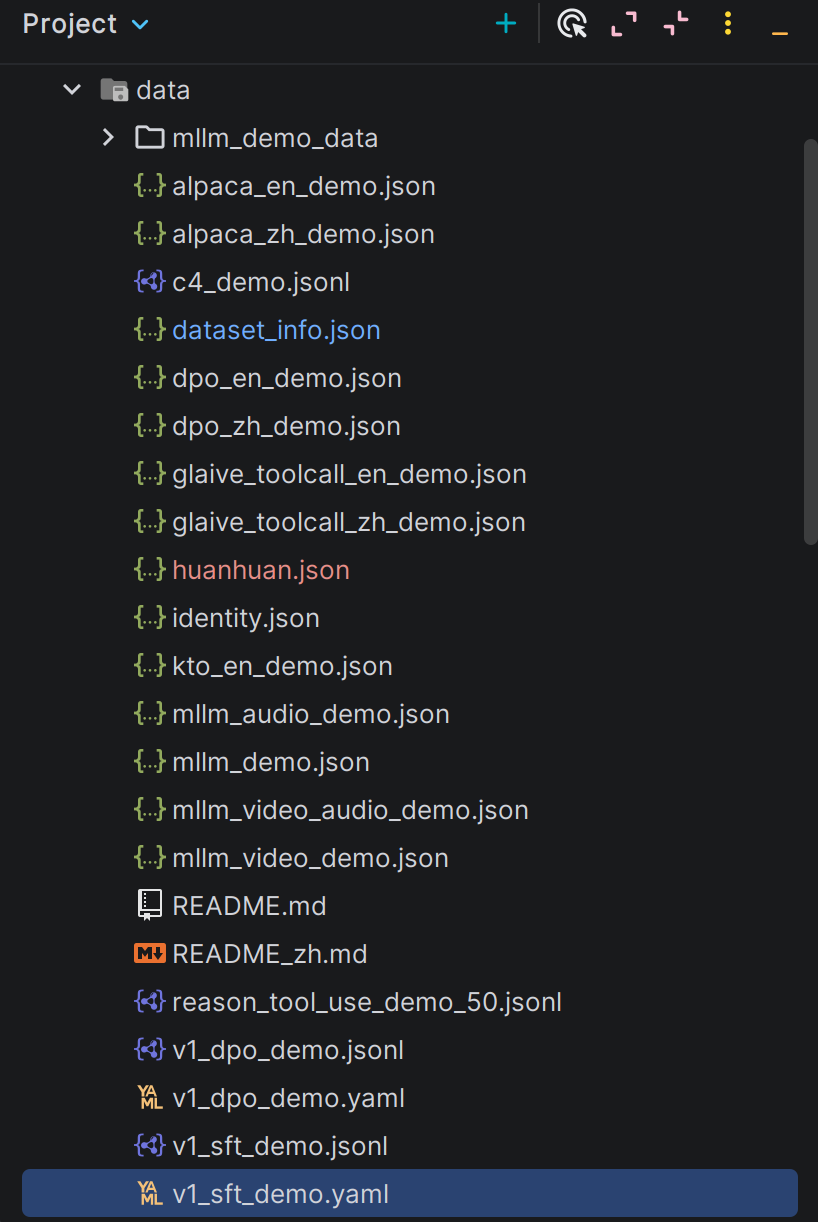
更多详情可以在 https://github.com/hiyouga/LLaMA-Factory/blob/main/data/README_zh.md 中找到相关解释。
系统目前支持 alpaca 和sharegpt两种数据格式,以alpaca为例,整个数据集是一个json对象的list,具体数据格式为
[
  {
    "instruction": "用户指令(必填)",
    "input": "用户输入(选填)",
    "output": "模型回答(必填)",
    "system": "系统提示词(选填)",
    "history": [
      [
        "第一轮指令(选填)",
        "第一轮回答(选填)"
      ],
      [
        "第二轮指令(选填)",
        "第二轮回答(选填)"
      ]
    ]
  }
]
例子比如单轮(alpaca_zh_demo.json 中的例子, 数据集在data/dataset_info.json中注册为alpaca_zh_demo)
[
...,
{
  "instruction": "输入三支篮球队的名称并生成一个适当的口号。",
  "input": "输入:俄克拉荷马城雷霆队,芝加哥公牛队,布鲁克林网队。",
  "output": "输出: \"雷霆,公牛和网队:各显神通,角逐群雄!\""
},...
]
和多轮 (oaast_sft_zh.json 中的例子, 数据集在data/dataset_info.json中注册为oaast_sft_zh)
{
  "instruction": "谢谢",
  "input": "",
  "output": "不用谢! 很高兴我提供的信息能够帮助到你! 如果还有什么其他问题也可以向我提问。",
  "history": [
    [
      "请你给我写一个面试准备计划,我想要去面试微软的程序员岗位",
      "首先,你可以去微软官网寻找招聘信息并申请面试。\n其次,您可以在社交媒体平台寻找微软公司对程序员的面试问题,并做好准备。\n最后,您可以自己对面试过程进行模拟,熟悉话题并减少紧张感。\n我希望你能面试成功。"
    ]
  ]
}
所以训练的数据最好也转换成这种格式,然后在 data/dataset_info.json中进行注册
(如果不做字段名称转换,则需要在注册的时候在 columns字段中做两个数据的映射配置)
接下来,我们使用两个具体的例子来说明数据集的使用
3.1 identity.json数据集 - 更改模型助手名称
第一个是系统自带的identity.json数据集(已默认在data/dataset_info.json 注册为identity),对应文件已经在data目录下,我们通过操作系统的文本编辑器的替换功能,可以替换其中的NAME 和 AUTHOR ,换成我们需要的内容。
如果是linux系统,可以使用sed 完成快速替换。比如name的名称修改为PonyBot, author由 LLaMA Factory 开发
#更换姓名
sed -i 's/{{name}}/PonyBot/g'  data/identity.json
#更换作者名
sed -i 's/{{author}}/LLaMA Factory/g'  data/identity.json
替换前
{
  "instruction": "Who are you?",
  "input": "",
  "output": "Hello! I am {{name}}, an AI assistant developed by {{author}}. How can I assist you today?"
}
替换后
{
  "instruction": "Who are you?",
  "input": "",
  "output": "I am PonyBot, an AI assistant developed by LLaMA Factory. How can I assist you today?"
}
3.2 三方数据集-嬛嬛数据集
原始格式如下
...
{
    "instruction": "这个温太医啊,也是古怪,谁不知太医不得皇命不能为皇族以外的人请脉诊病,他倒好,十天半月便往咱们府里跑。",
    "input": "",
    "output": "你们俩话太多了,我该和温太医要一剂药,好好治治你们。"
}
...
想将该自定义数据集放到我们的系统中使用,则需要进行如下两步操作
- 复制该数据集到 data目录下
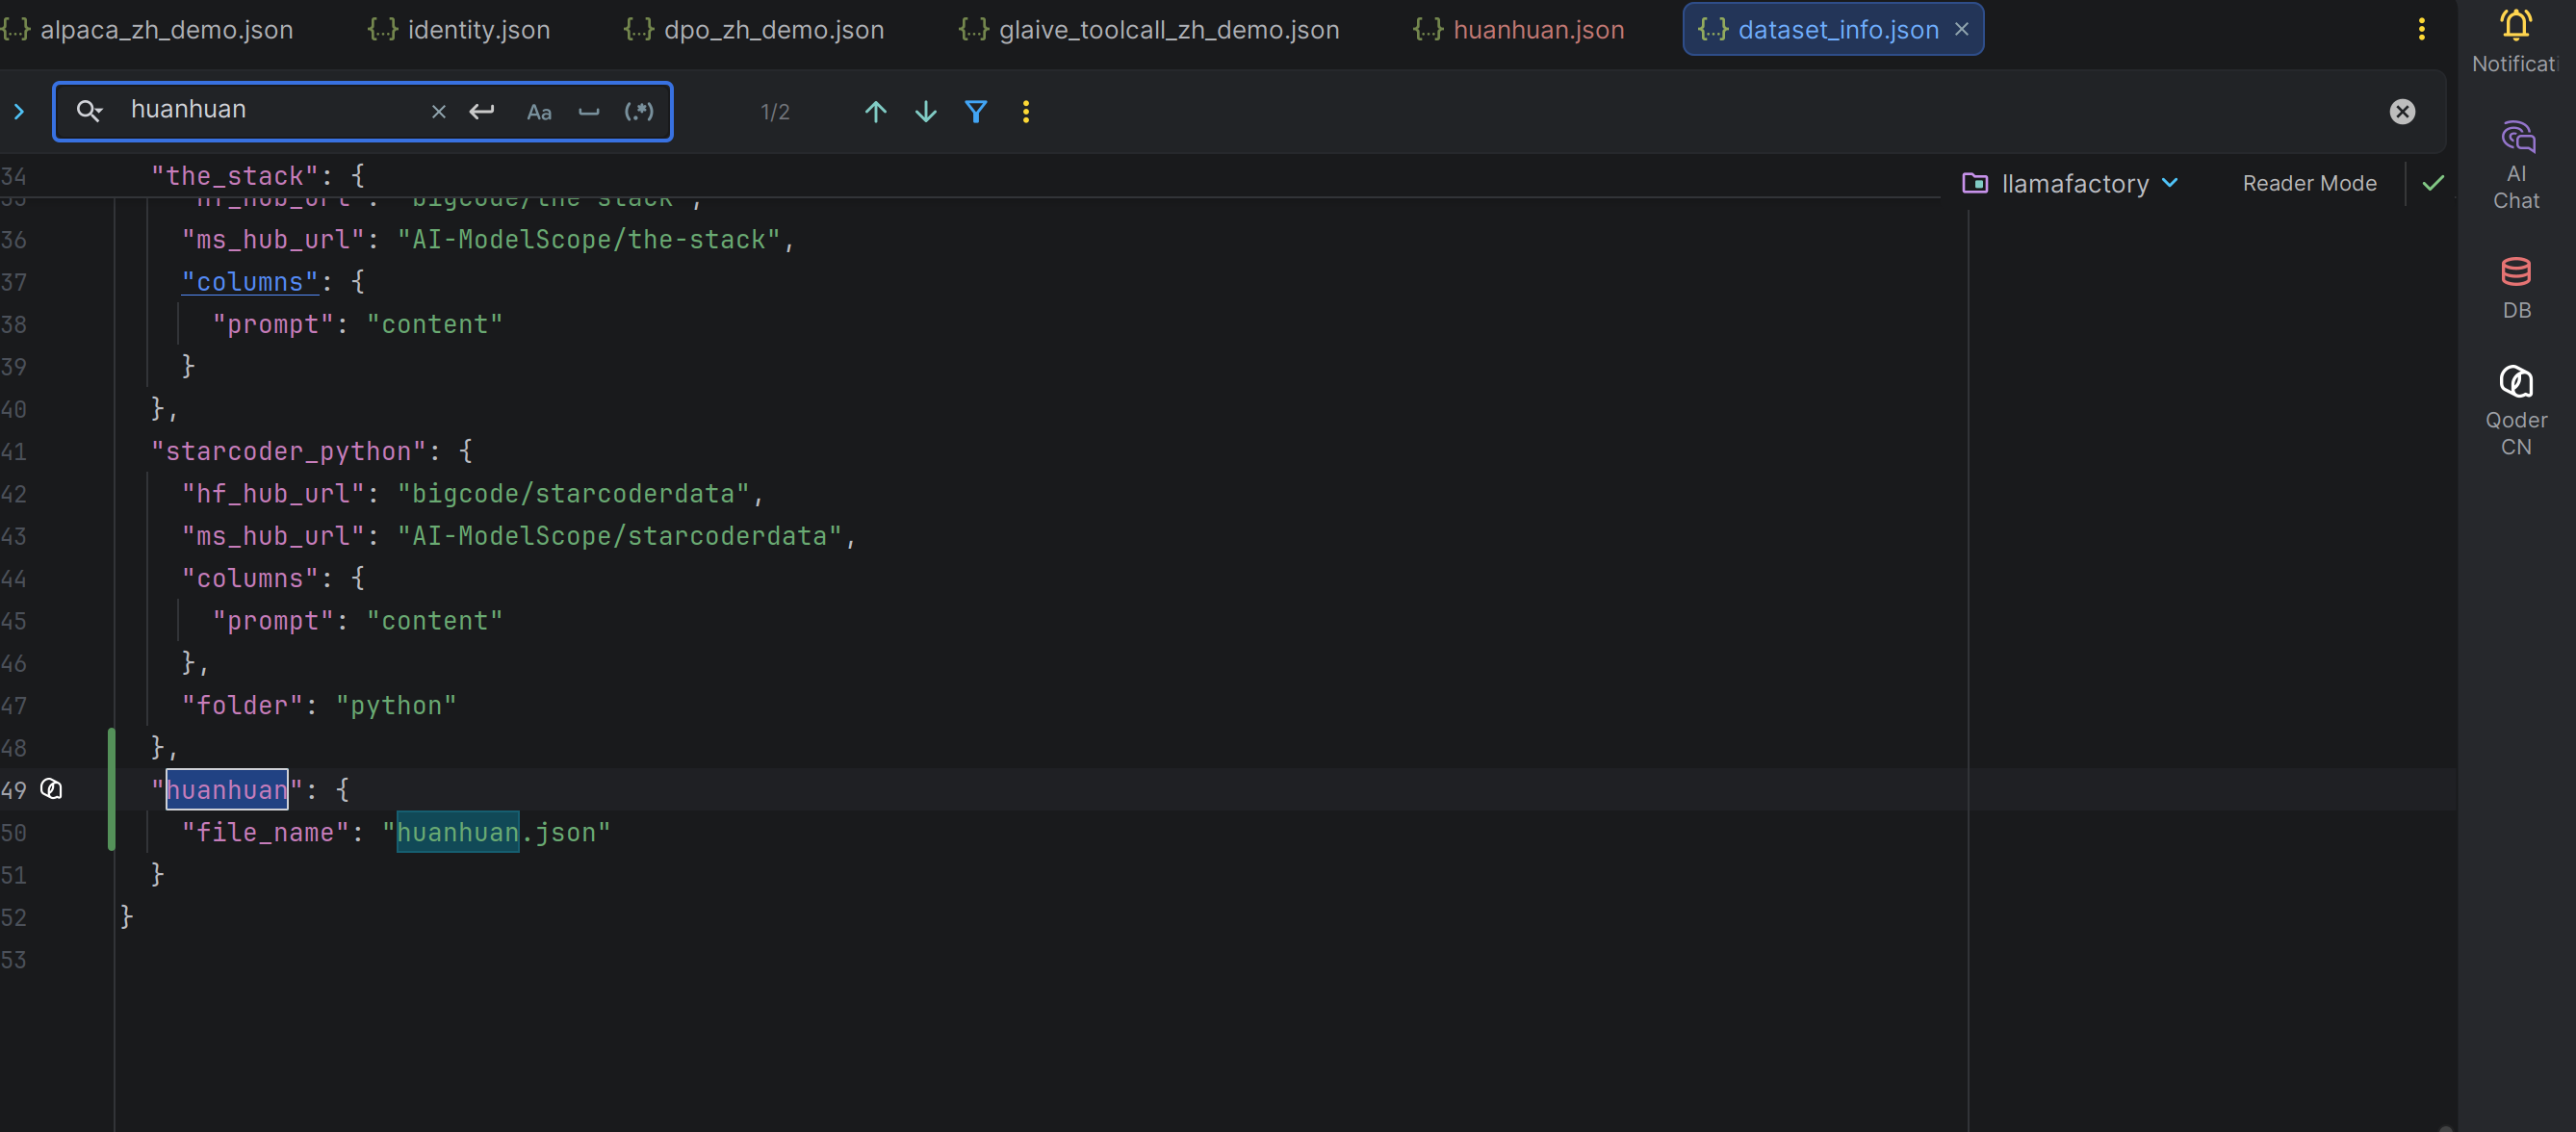
- 修改 data/dataset_info.json 新加内容完成注册, 该注册同时完成了3件事:
- 自定义数据集的名称为huanhuan,后续训练的时候就使用这个名称来找到该数据集
- 指定了数据集具体文件位置
- 定义了原数据集的输入输出和我们所需要的格式之间的映射关系
4 开始微调训练 - 基于LoRA的SFT指令
在准备好数据集之后,就可以开始准备训练了。
目标就是让原来的模型能够学会:
- 自定义的“你是谁”?
- 学会我们的甄嬛传文案的一些生成。
4.1 使用命令行 train
本脚本参数改编自 LLaMA-Factory/examples/train_lora/llama3_lora_sft.yaml at main · hiyouga/LLaMA-Factory
CUDA_VISIBLE_DEVICES=0 llamafactory-cli train \
    --stage sft \
    --do_train \
    --model_name_or_path /media/codingma/LLM/llama3/Meta-Llama-3-8B-Instruct \
    --dataset alpaca_gpt4_zh,identity,adgen_local \
    --dataset_dir ./data \
    --template llama3 \
    --finetuning_type lora \
    --output_dir ./saves/LLaMA3-8B/lora/sft \
    --overwrite_cache \
    --overwrite_output_dir \
    --cutoff_len 1024 \
    --preprocessing_num_workers 16 \
    --per_device_train_batch_size 2 \
    --per_device_eval_batch_size 1 \
    --gradient_accumulation_steps 8 \
    --lr_scheduler_type cosine \
    --logging_steps 50 \
    --warmup_steps 20 \
    --save_steps 100 \
    --eval_steps 50 \
    --eval_strategy steps \
    --load_best_model_at_end \
    --learning_rate 5e-5 \
    --num_train_epochs 5.0 \
    --max_samples 1000 \
    --val_size 0.1 \
    --plot_loss \
    --fp16
关于参数的完整列表和解释可以通过如下命令来获取
llamafactory-cli train -h这里对部分关键的参数做解释,model_name_or_path 和template 上文已解释
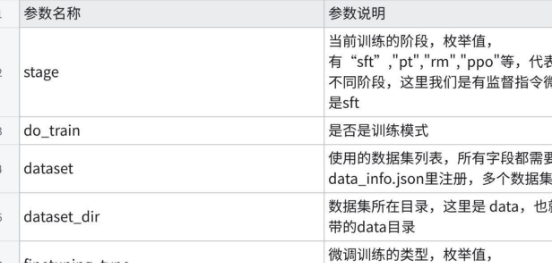
点击图片可查看完整电子表格
注意:精度相关的参数还有bf16 和pure_bf16,但是要注意有的老显卡,比如V100就无法支持bf16,会导致程序报错或者其他错误。
训练过程中,系统会按照logging_steps的参数设置,定时输出训练日志,包含
- 当前loss
- 训练进度
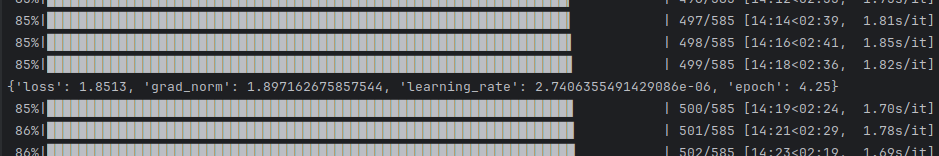
训练完后就可以在设置的output_dir看到如下内容,主要包含3部分
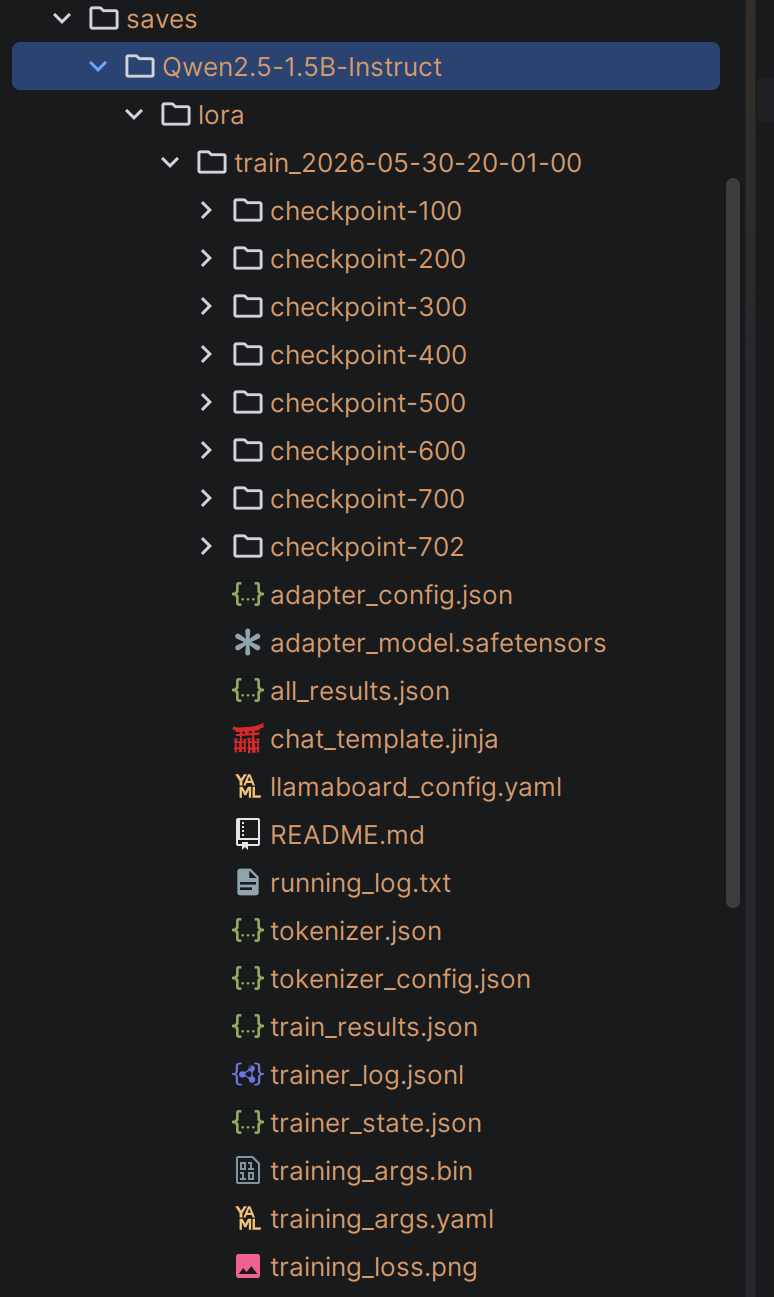
- adapter开头的就是 LoRA保存的结果了,后续用于模型推理融合
- training_loss 和trainer_log等记录了训练的过程指标
- 其他是训练当时各种参数的备份。
关于loss是什么,这块不在本教程讨论内容范围之内,只需要记住loss在 正常情况下会随着训练的时间慢慢变小,最后需要下降到1以下的位置才会有一个比较好的效果,可以作为训练效果的中间指标
5 训练后-动态合并LoRA的推理
本脚本参数改编自 LLaMA-Factory/examples/inference/llama3_lora_sft.yaml at main · hiyouga/LLaMA-Factory
当基于LoRA的训练进程结束后,我们如果想做一下动态验证,在网页端里与新模型对话,与步骤4的原始模型直接推理相比,唯一的区别是需要
- finetuning_type参数,如果使用的LoRA训练,就填lora
- adapter_name_or_path: 训练成功后 模型位置。
5.1 校验新模型 - UI 启动
CUDA_VISIBLE_DEVICES=0
#launch the llmafactory-cli webchat
llamafactory-cli webchat \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --adapter_name_or_path /media/tommy/win_documents/code/ai_source/LlamaFactory/saves/Qwen2.5-1.5B-Instruct/lora/train_2026-05-30-20-01-00  \
    --template qwen \
    --finetuning_type lora
效果如下,可以看到,模型整个已经在学习了新的数据知识,学习了新的身份认知。
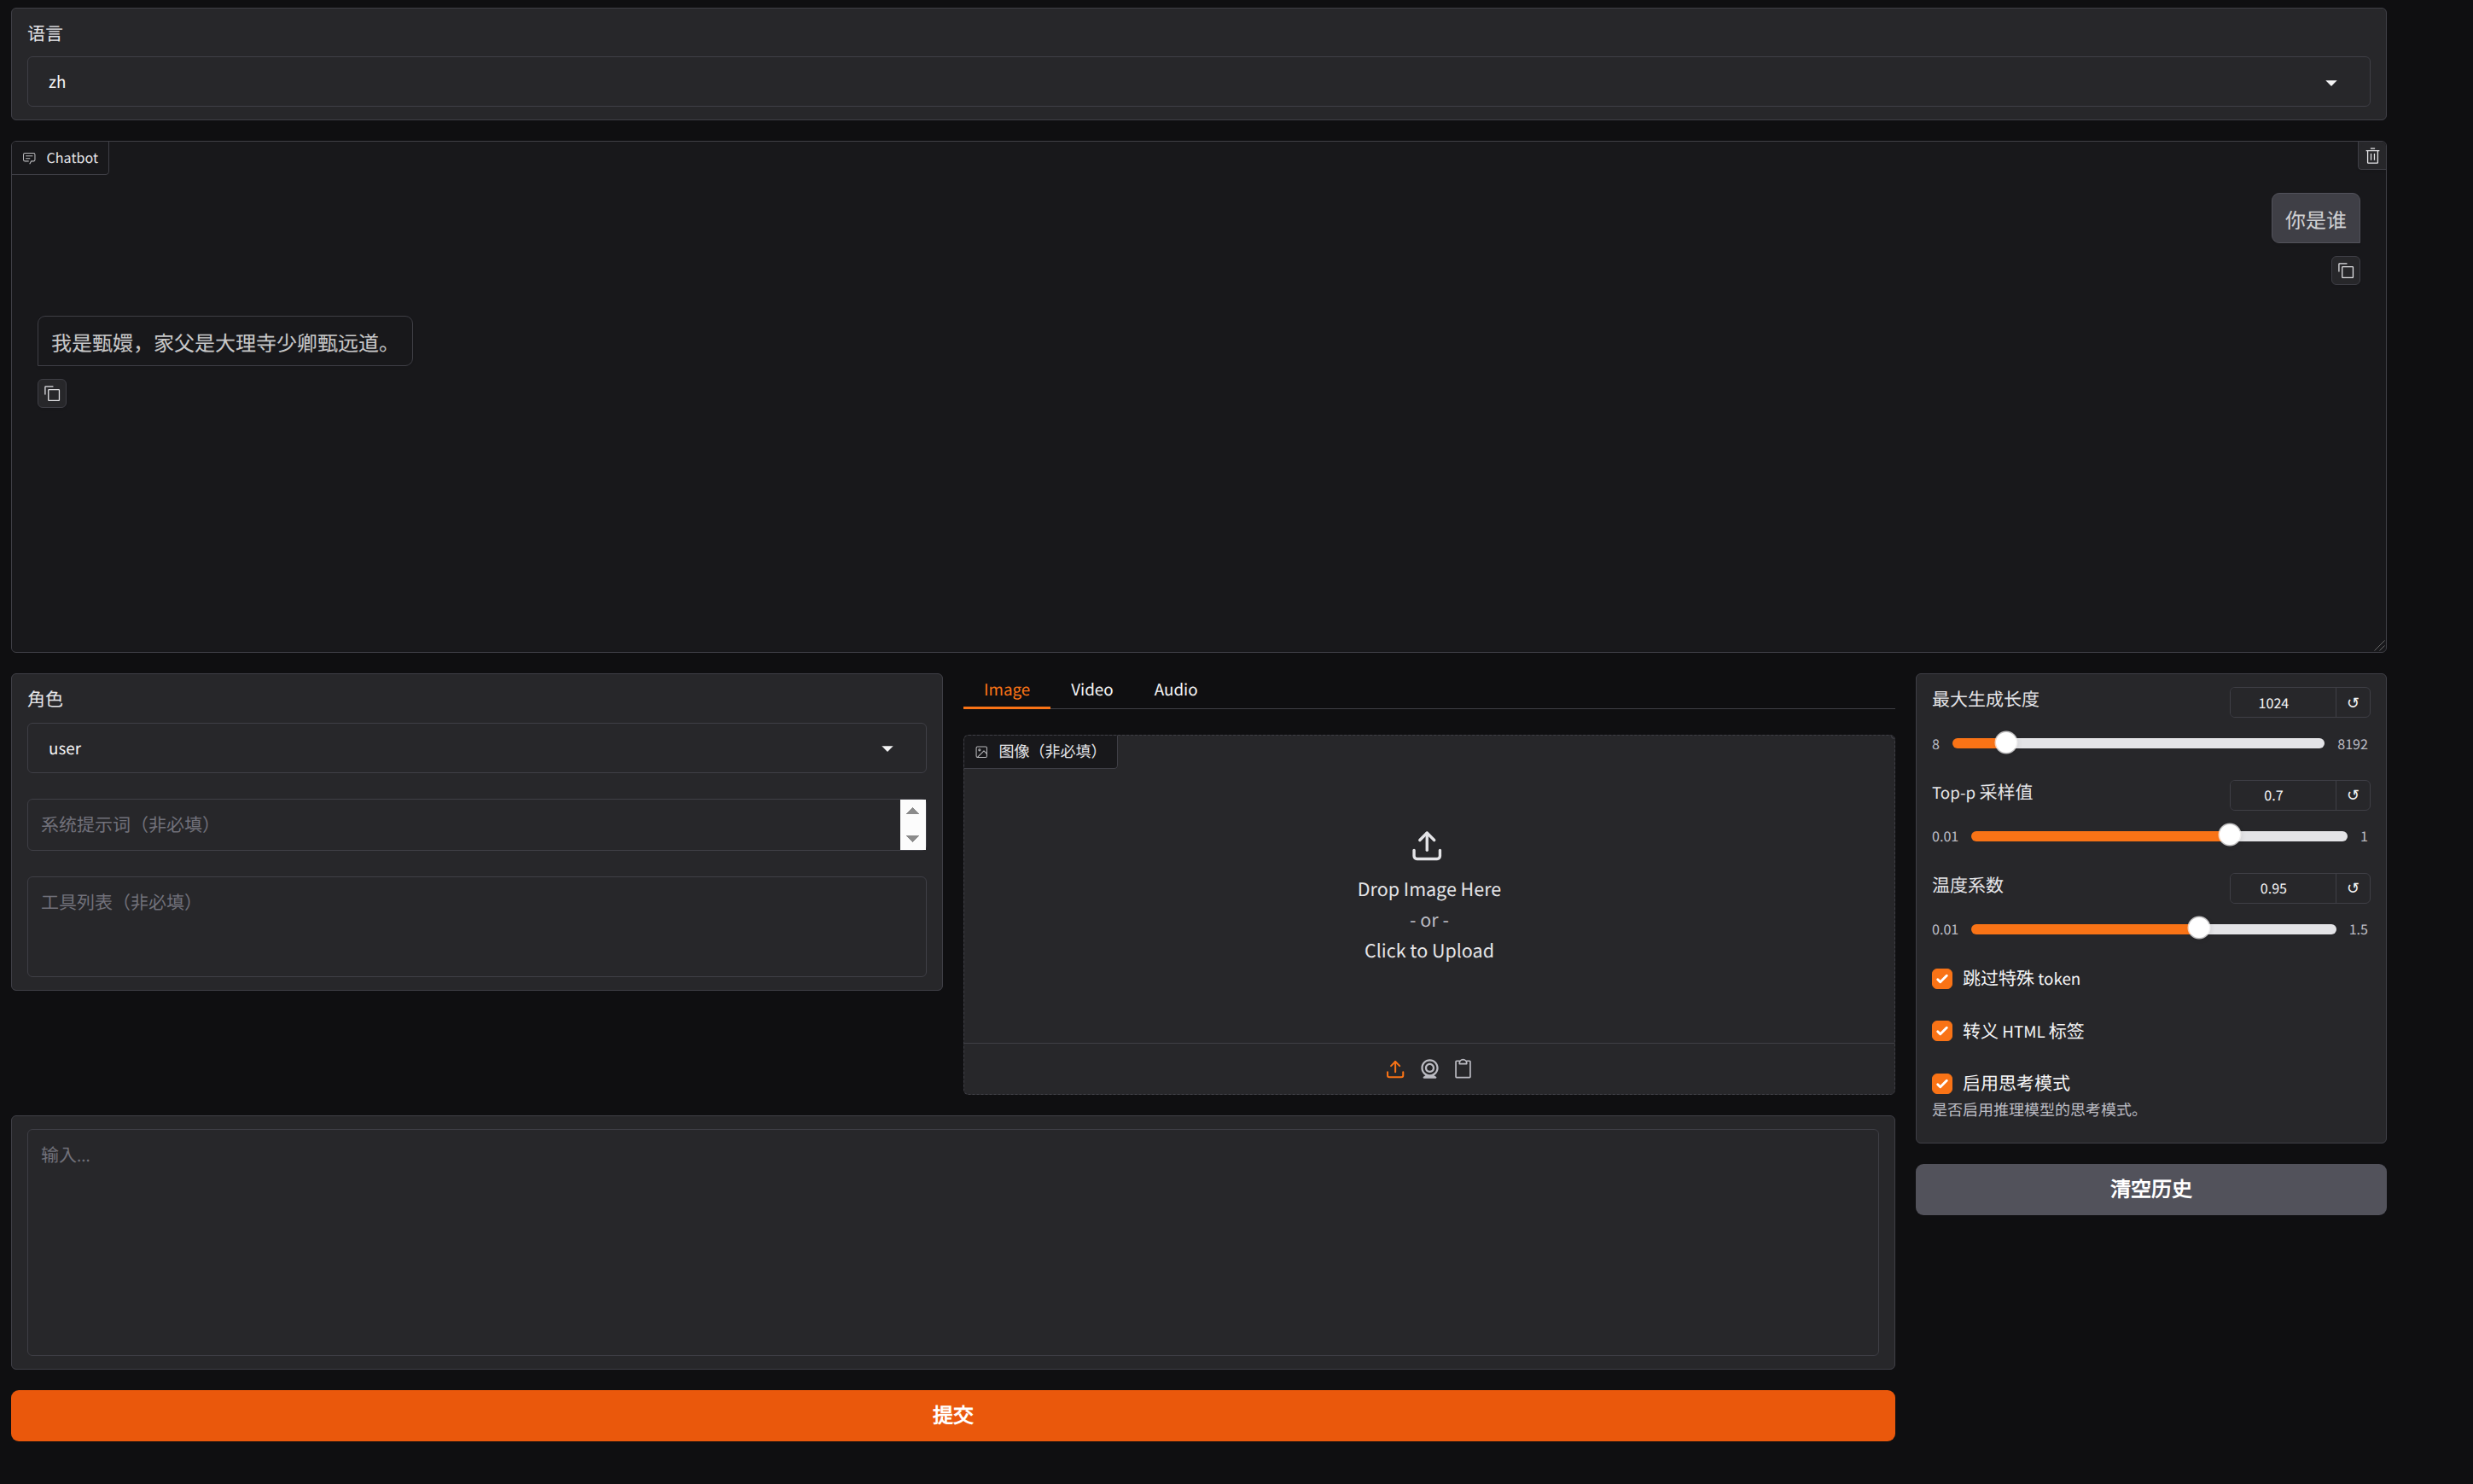
5.2 校验 新模型 - terminal 窗口化启动
本脚本改编自 LLaMA-Factory/examples/inference/llama3_lora_sft.yaml at main · hiyouga/LLaMA-Factory
CUDA_VISIBLE_DEVICES=0 llamafactory-cli chat \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --adapter_name_or_path /media/tommy/win_documents/code/ai_source/LlamaFactory/saves/Qwen2.5-1.5B-Instruct/lora/train_2026-05-30-20-01-00  \
    --template qwen \
    --finetuning_type lora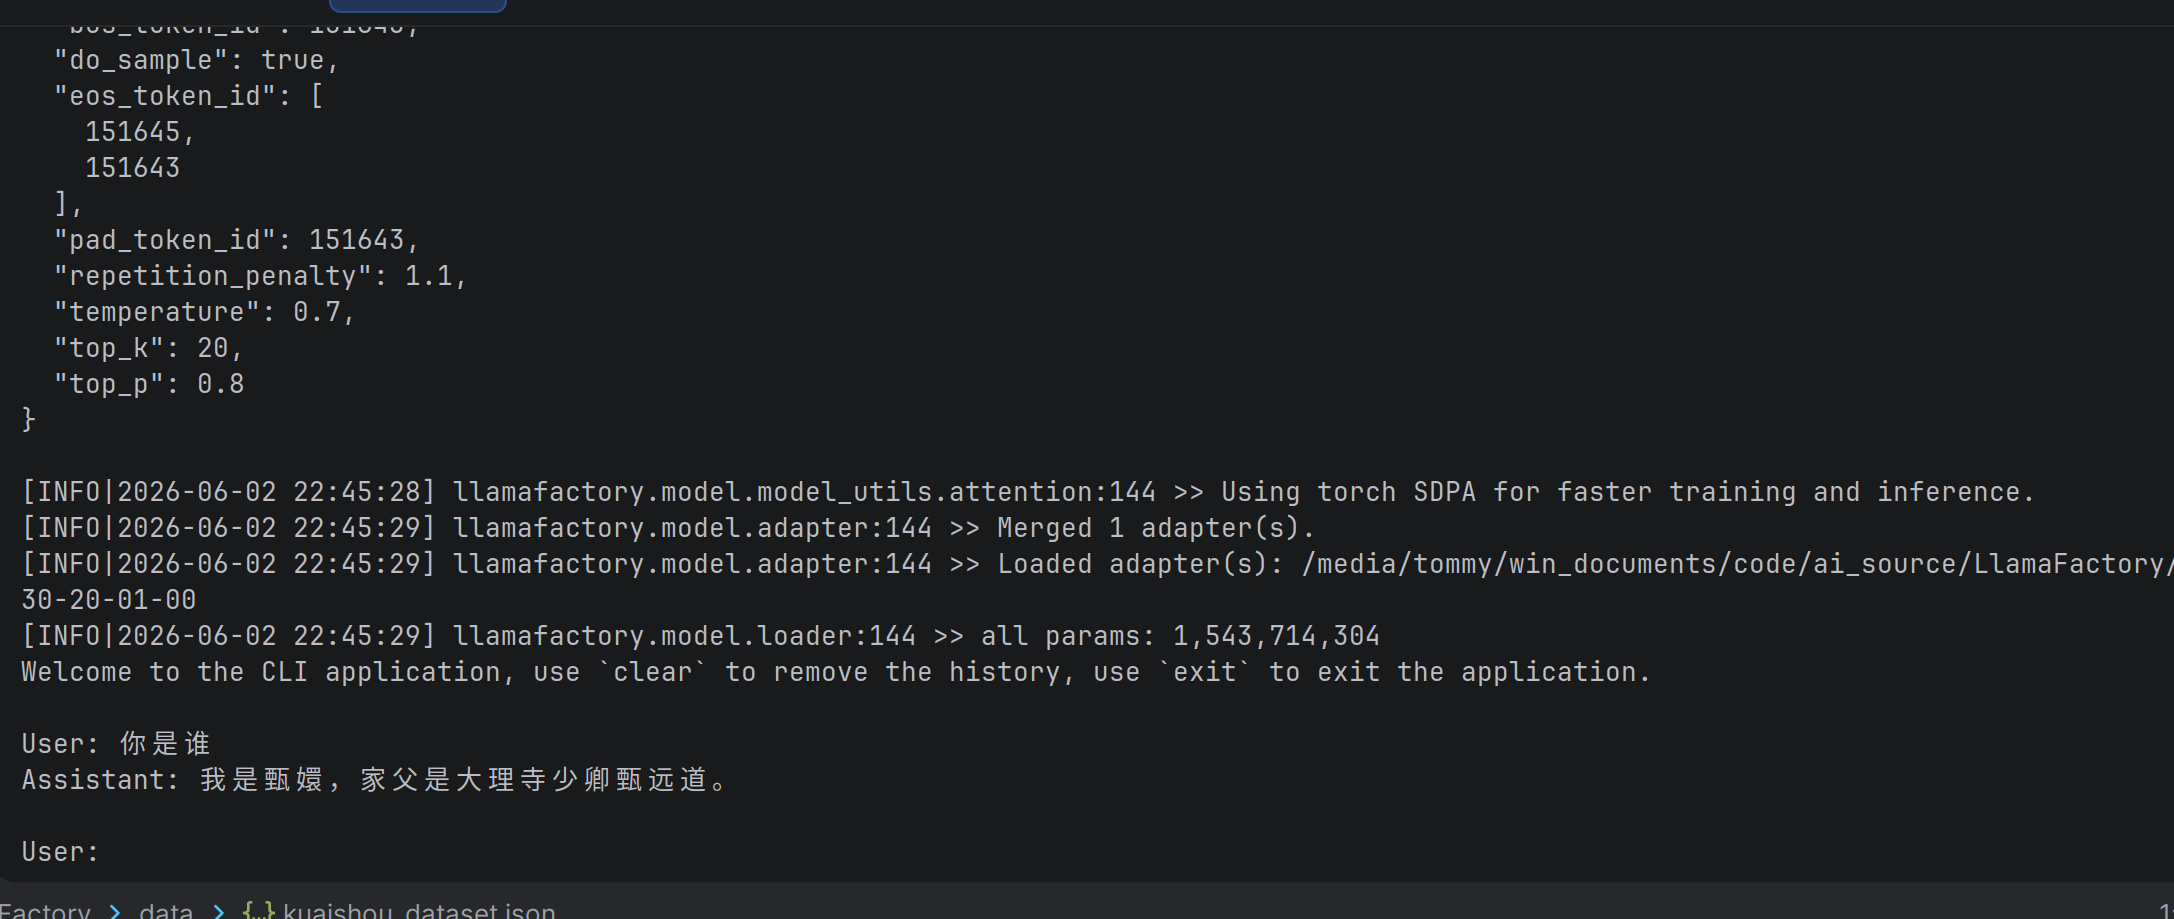
6 批量预测 新模型的 predict训练效果和评估
上文中的人工交互测试,会偏感性。
是否有一种办法可以批量地预测一批数据,然后使用自动化的bleu和 rouge等常用的文本生成指标来做评估。
指标计算会使用如下3个库,请先做一下pip安装
pip install jieba
pip install rouge-chinese
pip install nltk
本脚本参数改编自
https://github.com/hiyouga/LLaMA-Factory/blob/main/examples/train_lora/llama3_lora_predict.yaml
CUDA_VISIBLE_DEVICES=0 \
#eval_dataset 用于评估的数据集名称。使用逗号分隔多个数据集。
llamafactory-cli train \
    --stage sft \
    --do_predict \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --adapter_name_or_path /media/tommy/win_documents/code/ai_source/LlamaFactory/saves/Qwen2.5-1.5B-Instruct/lora/train_2026-05-30-20-01-00  \
    --eval_dataset huanhuan,identity \
    --dataset_dir ./data \
    --template qwen \
    --finetuning_type lora \
    --output_dir ./saves/Qwen2.5-1.5B-Instruct/lora/predict \
    --overwrite_cache \
    --overwrite_output_dir \
    --cutoff_len 1024 \
    --preprocessing_num_workers 16 \
    --per_device_eval_batch_size 1 \
    --max_samples 20 \
    --predict_with_generate
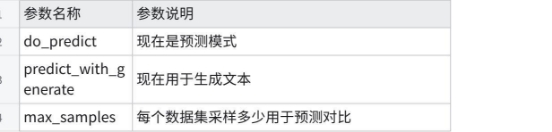
与训练脚本主要的参数区别如下两个
点击图片可查看完整电子表格
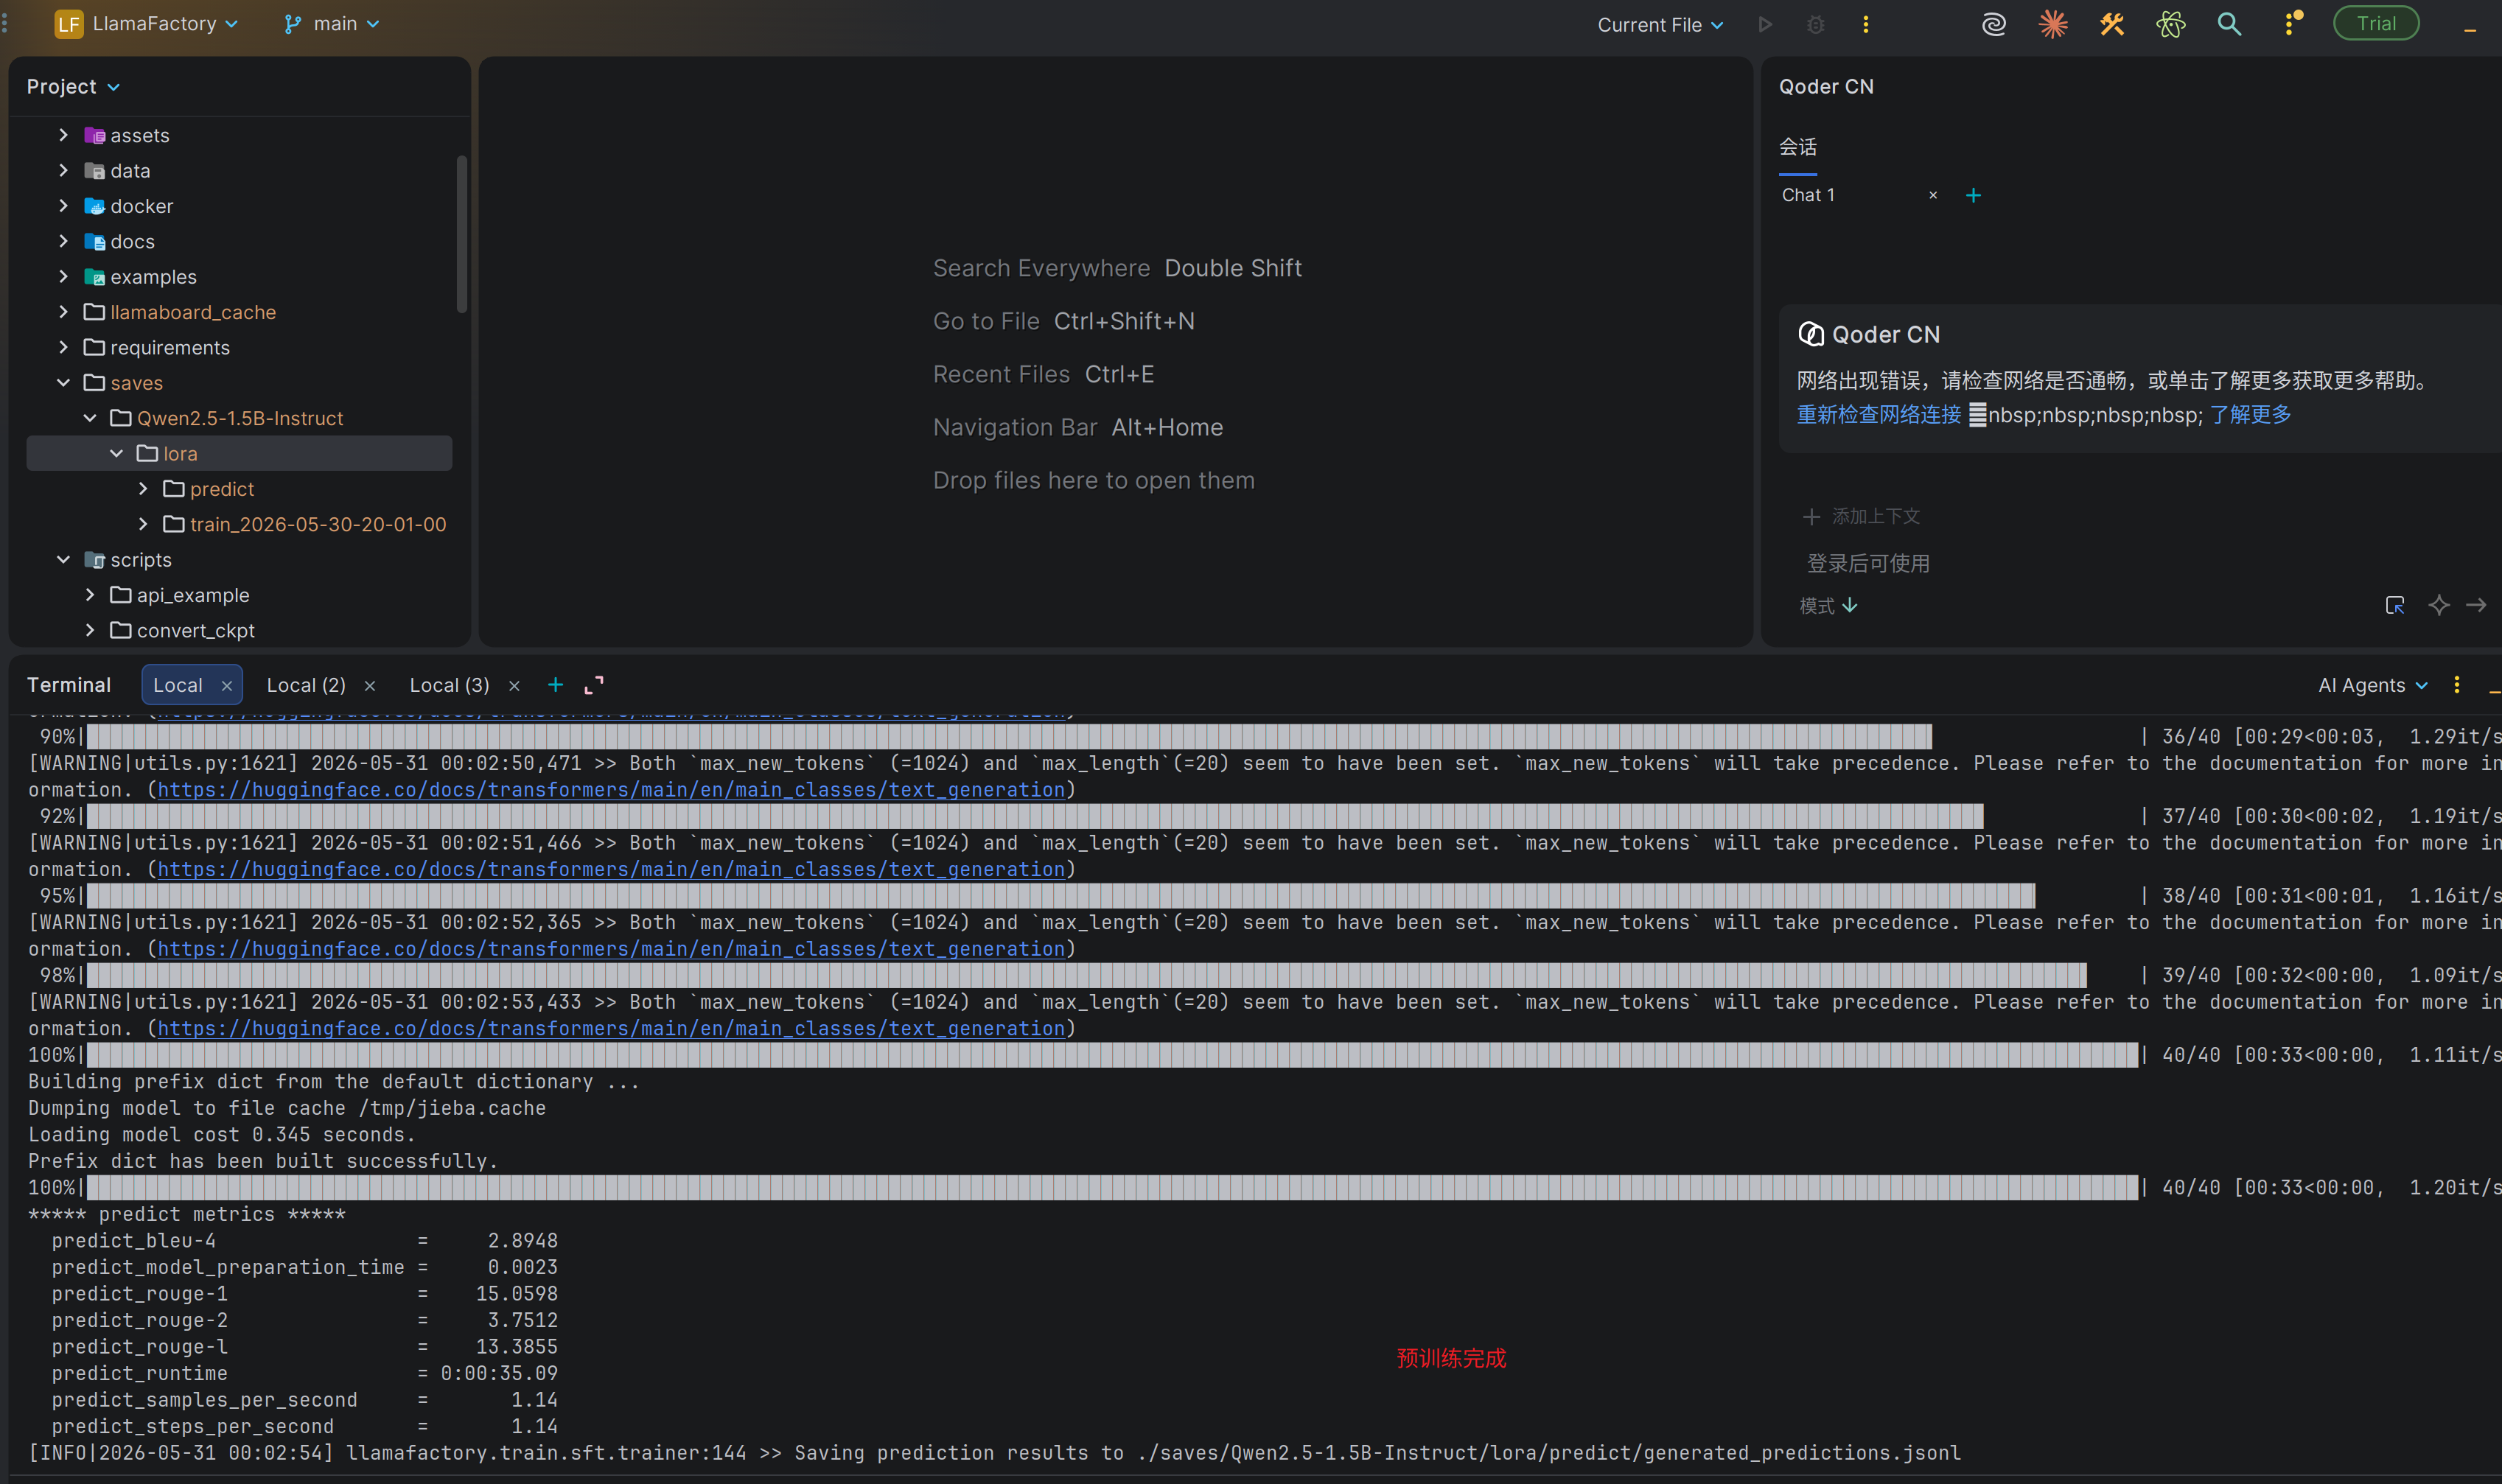
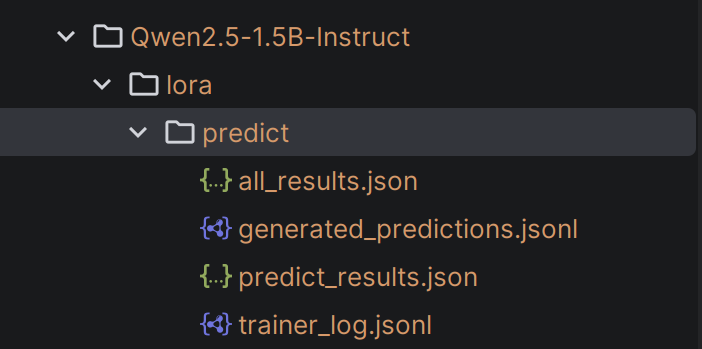
最后会在output_dir下看到如下内容
- generated_predictions.jsonl :要预测的数据集的 原始label 和模型预测predict 的结果
{"prompt": "<|im_start|>system\nYou are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>\n<|im_start|>user\n你是谁<|im_end|>\n<|im_start|>assistant\n", "predict": "我是甄嬛,家父是大理寺少卿甄远道。", "label": "您好,我是由 {{author}} 发明的 {{name}}。我可以为您提供多种多样的服务,比如翻译、写代码、闲聊、为您答疑解惑等。\n"}- predict_results.json给出了原始label和 模型预测predict 的最终统计结果,
用自动计算的指标数据
{
    "predict_bleu-4": 2.8947849999999997,
    "predict_model_preparation_time": 0.0023,
    "predict_rouge-1": 15.05983,
    "predict_rouge-2": 3.7511574999999993,
    "predict_rouge-l": 13.38554,
    "predict_runtime": 35.0961,
    "predict_samples_per_second": 1.14,
    "predict_steps_per_second": 1.14
}
这里给相关的指标做一下进一步的解释
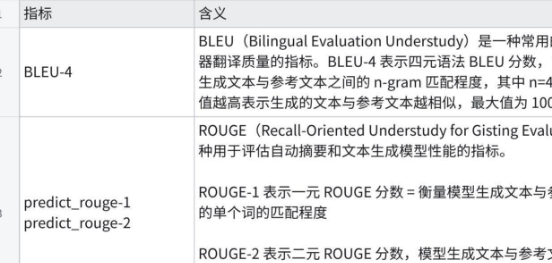
点击图片可查看完整电子表格
7 训练后-LoRA模型合并导出
如果想把训练的LoRA和原始的大模型进行融合,输出一个完整的模型文件的话,可以使用如下命令。
合并后的模型可以自由地像使用原始的模型一样应用到其他下游环节(Ollama & Vlm ),当然也可以递归地继续用于训练。
本脚本参数改编自 LLaMA-Factory/examples/merge_lora/llama3_lora_sft.yaml at main · hiyouga/LLaMA-Factory
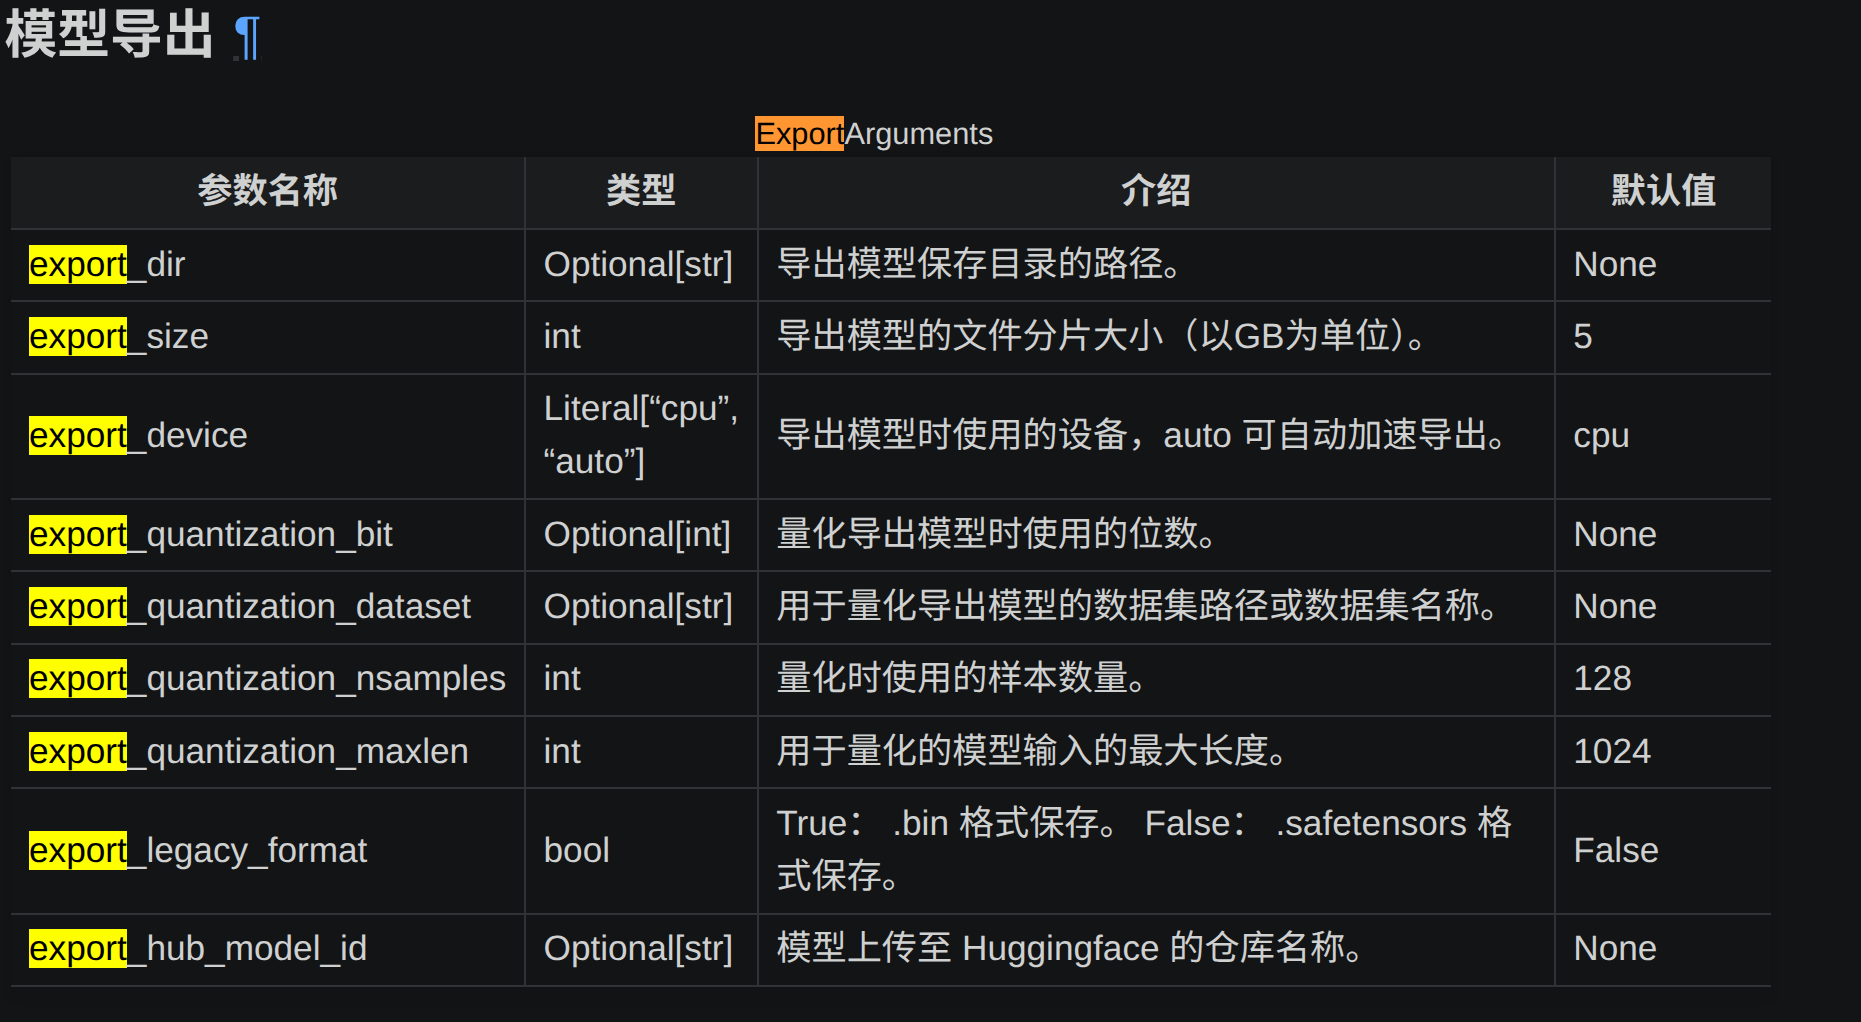
CUDA_VISIBLE_DEVICES=0 llamafactory-cli export \
    --model_name_or_path /home/tommy/.cache/modelscope/hub/models/Qwen/Qwen2.5-1.5B-Instruct \
    --adapter_name_or_path ./saves/Qwen2.5-1.5B-Instruct/lora/train_2026-05-30-20-01-00  \
    --template qwen \
    --finetuning_type lora \
    --export_dir ./exports/tommy_qwen2.5/ \
    --export_size 2 \
    --export_device auto \
    --export_legacy_format False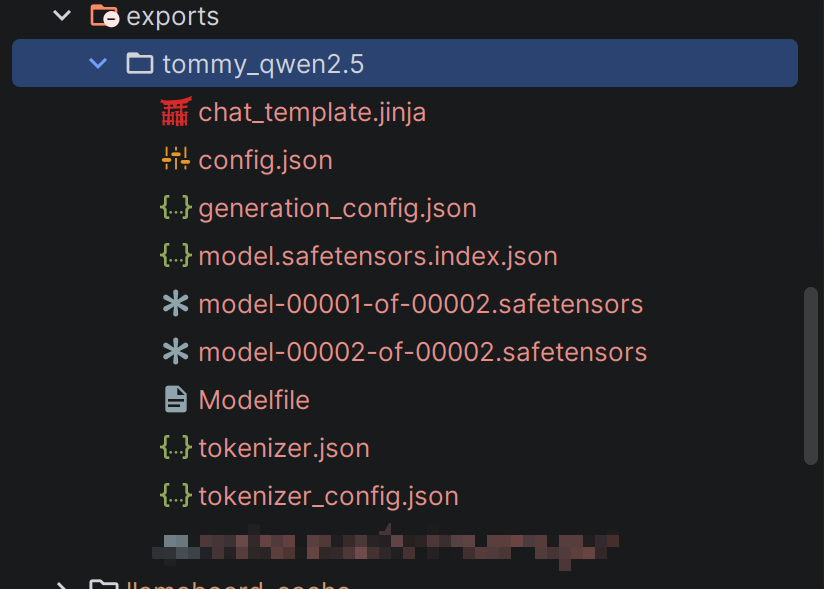
8 一站式webui board的使用
到这里,恭喜你完成了LLaMA-Efficent-Tuning训练框架的基础使用,那还有什么内容是没有介绍的呢?还有很多!这里介绍一个在提升交互体验上有重要作用的功能, 支持模型训练全链路的一站式WebUI board。一个好的产品离不开好的交互,Stable Diffusion的大放异彩的重要原因除了强大的内容输出效果,就是它有一个好的WebUI。这个board将训练大模型主要的链路和操作都在一个页面中进行了整合,所有参数都可以可视化地编辑和操作。
通过以下命令启动
注意:目前webui版本只支持单机单卡和单机多卡,如果是多机多卡请使用命令行版本
CUDA_VISIBLE_DEVICES=0 llamafactory-cli webui如果要开启 gradio的share功能,或者修改端口号
CUDA_VISIBLE_DEVICES=0 GRADIO_SHARE=1 GRADIO_SERVER_PORT=7860 llamafactory-cli webui如图所示,上述的多个不同的大功能模块都通过不同的tab进行了整合,提供了一站式的操作体验。
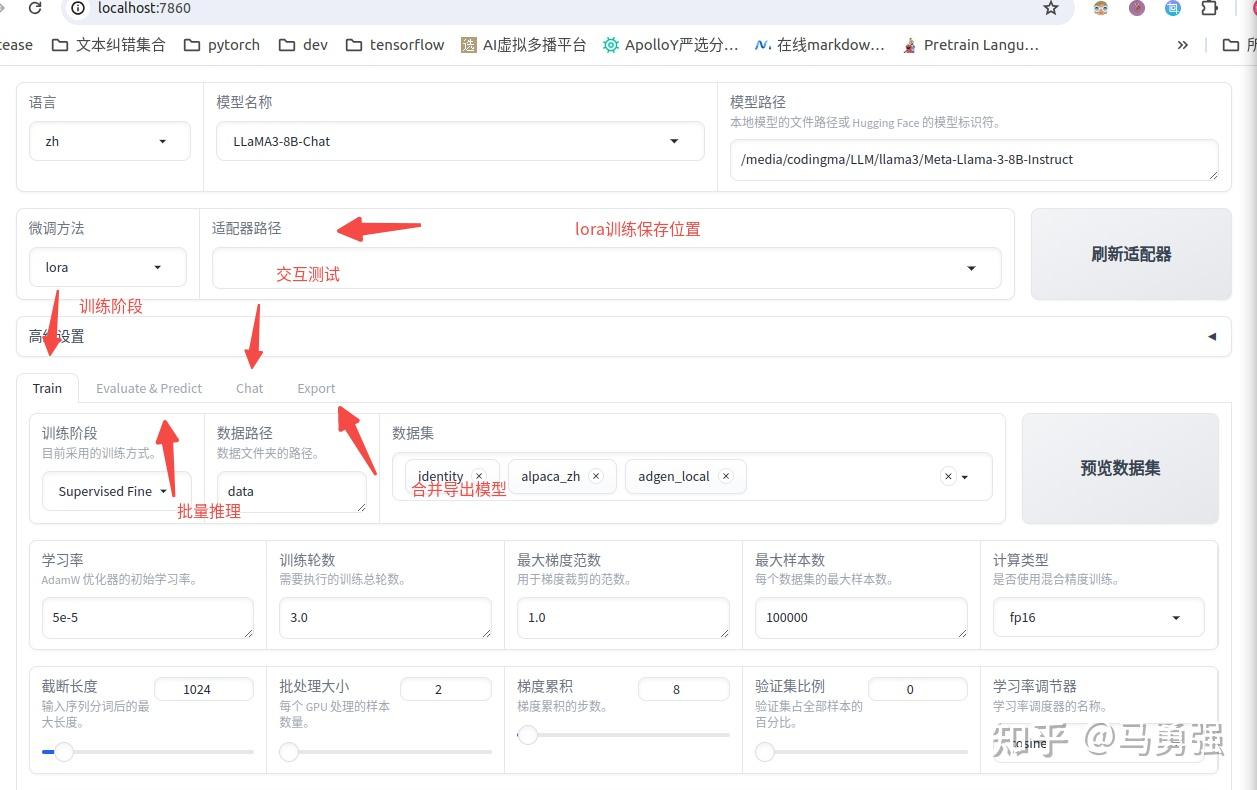
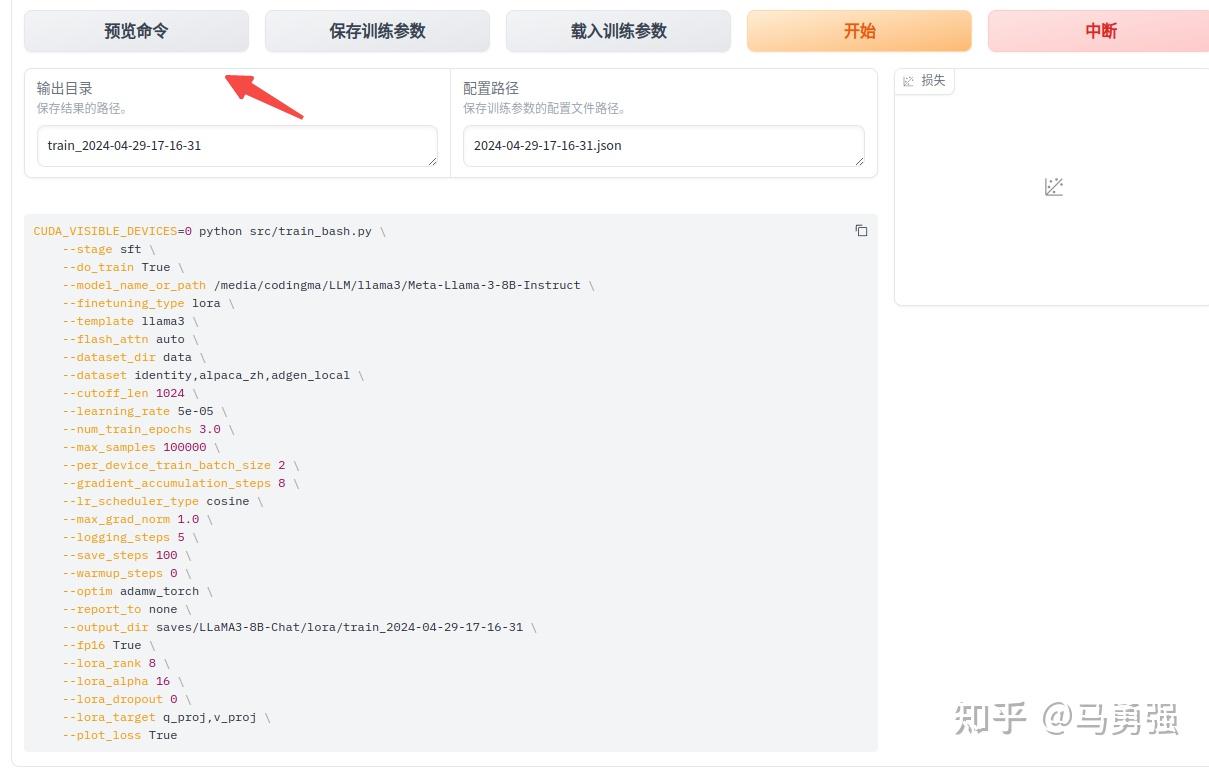
当各种参数配置好后,在train页面,可以通过预览命令功能,将训练脚本导出,用于支持多gpu训练
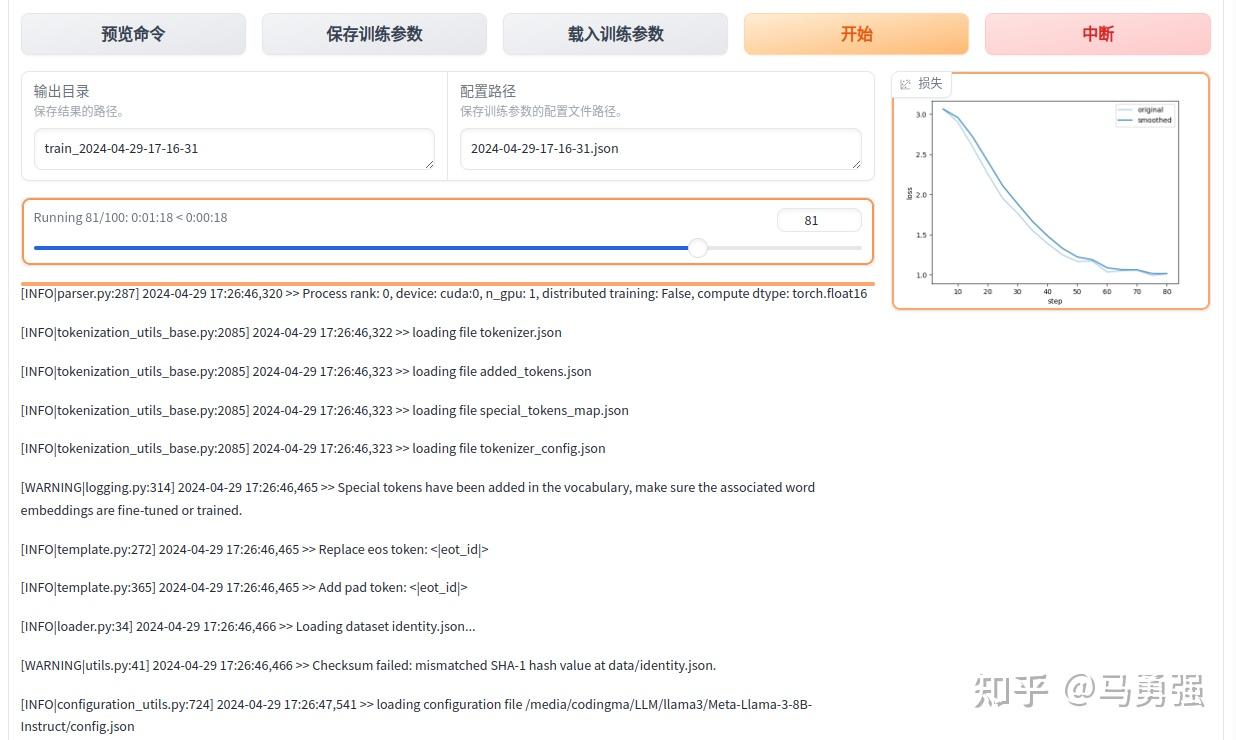
点击开始按钮, 即可开始训练,网页端和服务器端会同步输出相关的日志结果
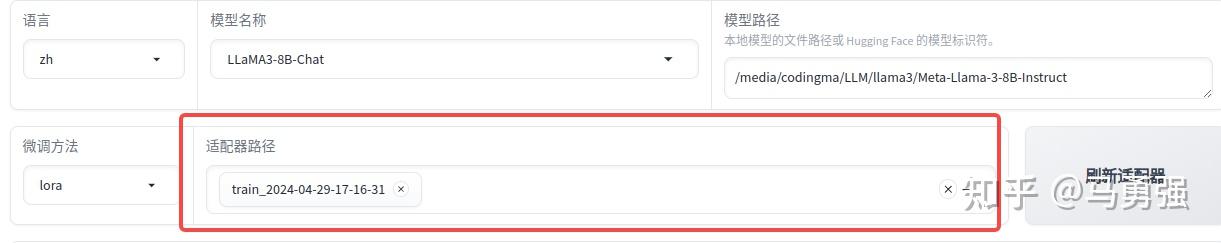
训练完毕后, 点击“刷新适配器”,即可找到该模型历史上使用webui训练的LoRA模型文件,后续再训练或者执行chat的时候,即会将此LoRA一起加载。
9 API Server的启动与调用
训练好后,可能部分同学会想将模型的能力形成一个可访问的网络接口,通过API 来调用,接入到langchian或者其他下游业务中,项目也自带了这部分能力。
API 实现的标准是参考了OpenAI的相关接口协议,基于uvicorn服务框架进行开发, 使用如下的方式启动。
本脚本改编自 https://github.com/hiyouga/LLaMA-Factory/blob/main/examples/inference/llama3_lora_sft.yaml
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 llamafactory-cli api \
    --model_name_or_path /media/codingma/LLM/llama3/Meta-Llama-3-8B-Instruct \
    --adapter_name_or_path ./saves/LLaMA3-8B/lora/sft \
    --template llama3 \
    --finetuning_type lora
项目也支持了基于vllm 的推理后端,但是这里由于一些限制,需要提前将LoRA 模型进行merge,使用merge后的完整版模型目录或者训练前的模型原始目录都可。
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 llamafactory-cli api \
    --model_name_or_path megred-model-path \
    --template llama3 \
    --infer_backend vllm \
    --vllm_enforce_eager
API服务启动后,即可参考 openai 的API 进行远程访问,主要的区别就是替换 其中的base_url,指向所部署的机器url和端口号即可。
import os
from openai import OpenAI
from transformers.utils.versions import require_version

require_version("openai>=1.5.0", "To fix: pip install openai>=1.5.0")

if __name__ == '__main__':
    # change to your custom port
    port = 8000
    client = OpenAI(
        api_key="0",
        base_url="http://localhost:{}/v1".format(os.environ.get("API_PORT", 8000)),
    )
    messages = []
    messages.append({"role": "user", "content": "hello, where is USA"})
    result = client.chat.completions.create(messages=messages, model="test")
    print(result.choices[0].message)
10 eval -大模型主流评测 benchmark
虽然大部分同学的主流需求是定制一个下游的垂直模型,但是在部分场景下,也可能有同学会使用本项目来做更高要求的模型训练,用于大模型刷榜单等。
这类评测同样可以用于评估大模型二次微调之后,对于原来的通用知识的泛化能力是否有所下降。
(因为一个好的微调,尽量是在具备垂直领域知识的同时,也保留了原始的通用能力)
本项目提供了mmlu,cmmlu, ceval三个常见数据集的自动评测脚本,按如下方式进行调用即可。
说明:task 目前支持 mmlu_test, ceval_validation, cmmlu_test
本脚本改编自 https://github.com/hiyouga/LLaMA-Factory/blob/main/examples/train_lora/llama3_lora_eval.yaml
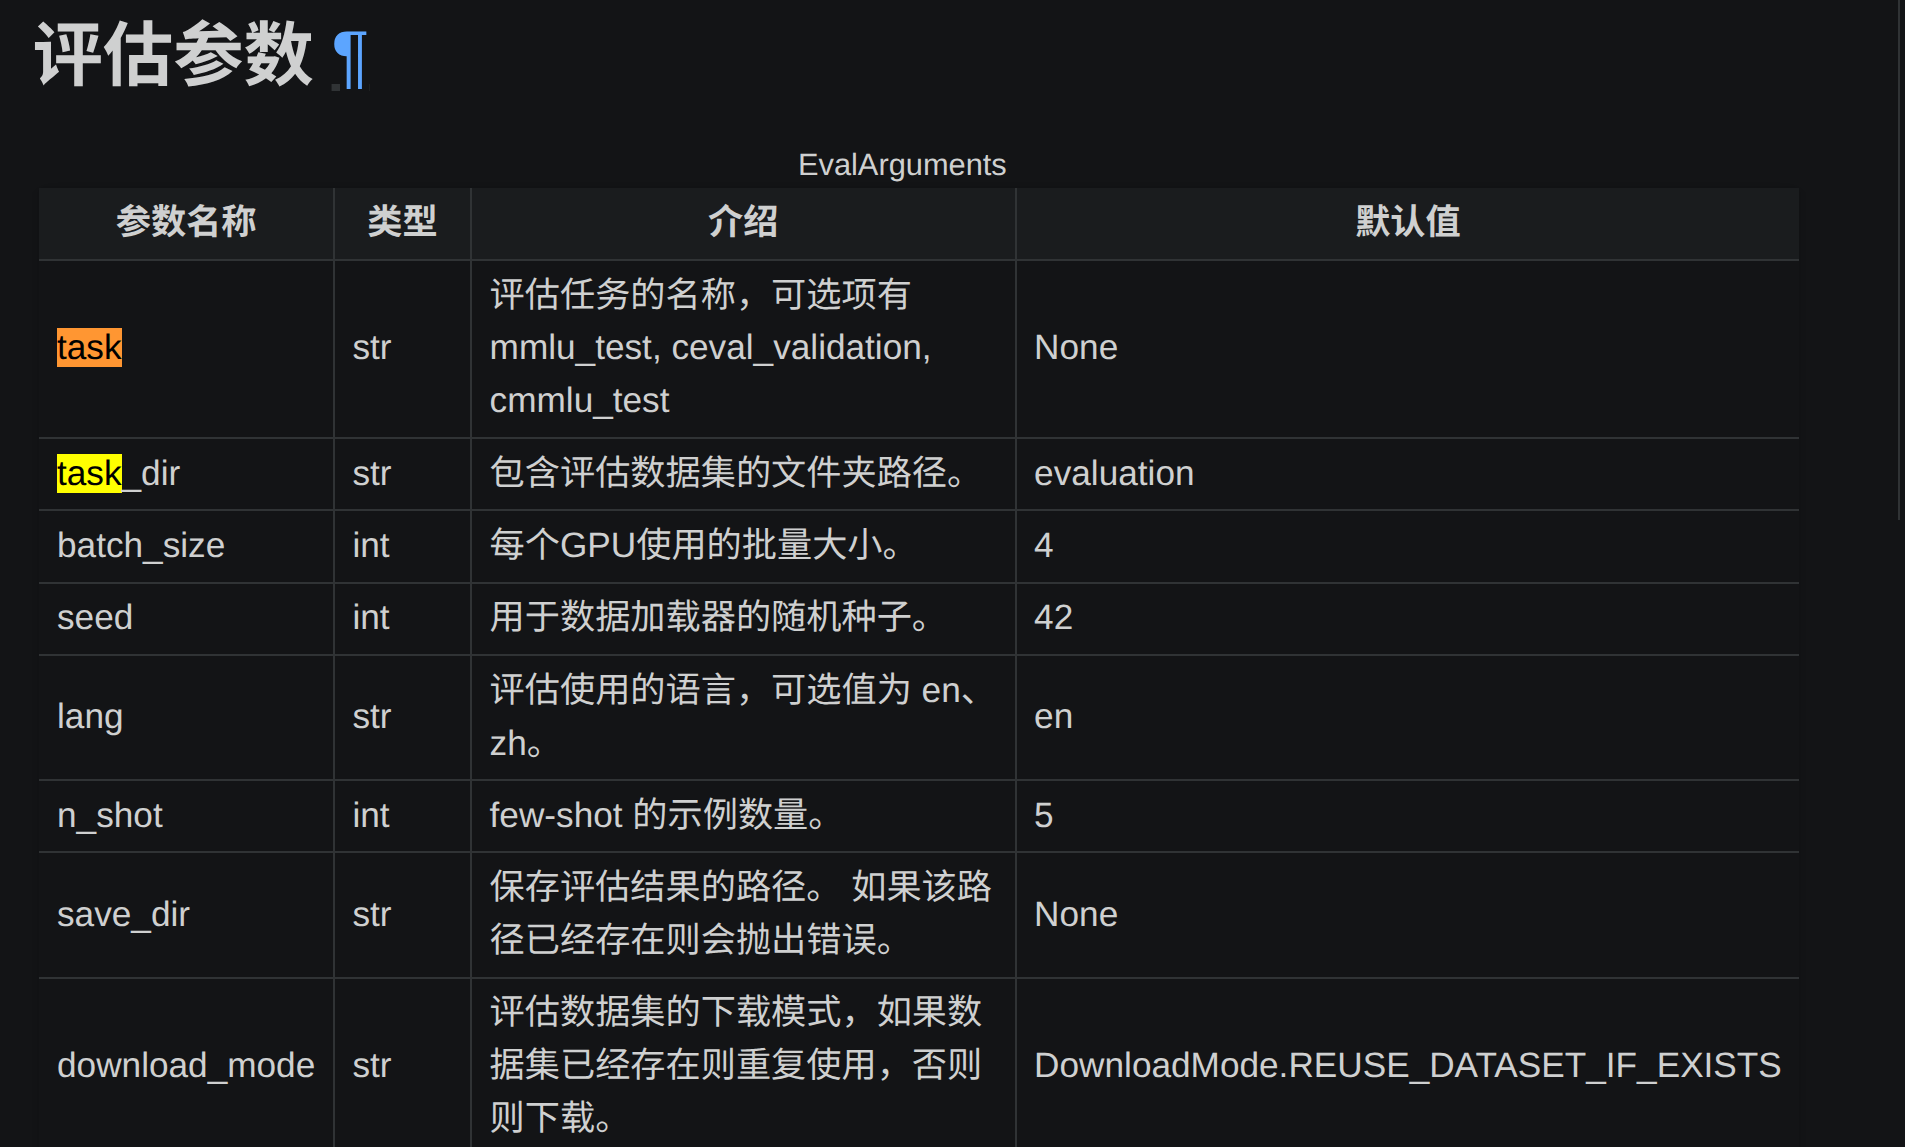
- eval 测评
CUDA_VISIBLE_DEVICES=0 llamafactory-cli eval \
--model_name_or_path /media/codingma/LLM/llama3/Meta-Llama-3-8B-Instruct \
--template llama3 \
--task mmlu_test \
--lang en \
--n_shot 5 \
--batch_size 1
输出如下, 具体任务的指标定义请参考mmlu,cmmlu, ceval等任务原始的相关资料, 可以查看模型官方报告分数是否一致。
        Average: 63.64
           STEM: 50.83
Social Sciences: 76.31
     Humanities: 56.63
          Other: 73.31
如果是base版本的模型,template改为fewshot即可
CUDA_VISIBLE_DEVICES=0 llamafactory-cli eval \
--model_name_or_path /media/codingma/LLM/llama3/Meta-Llama-3-8B \
--template fewshot \
--task mmlu \
--split validation \
--lang en \
--n_shot 5 \
--batch_size 1
11 进阶-导出GGUF,部署Ollama
GGUF 是 [lllama.cpp](https://github.com/ggerganov/llama.cpp) 设计的大模型存储格式,可以对模型进行高效的压缩,减少模型的大小与内存占用,从而提升模型的推理速度和效率。Ollama框架可以帮助用户快速使用本地的大型语言模型,那如何将LLaMA-Factory项目的训练结果 导出到Ollama中部署呢?需要经过如下几个步骤:
- 将lora模型合并,详情看上面操作
- 安装gguf库
- 使用llama.cpp的转换脚本将训练后的完整模型转换为gguf格式
- 安装Ollama软件
- 注册要部署的模型文件
- 启动Ollama
1-3 步是准备好 gguf格式的文件,这也是Ollama所需要的标准格式。
4-6 步就是如何在Ollama环境中启动训练后的模型。
11.1 lora模型合并
参考上文的第9步,这里笔者合并后的完整模型目录的绝对位置假设为
/media/tommy/win_documents/code/ai_source/LlamaFactory/exports/tommy_qwen2.5
注意:合并后可以在该目录下获取 转换好ollama需要的 Modelfile 文件
11.2 安装gguf库
笔者发现直接 pip 安装 gguf,并不是最新的版本,和最新的转换脚本会不兼容,所以还是推荐从源码安装
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp/gguf-py
pip install --editable .
11.3 模型格式转换命令
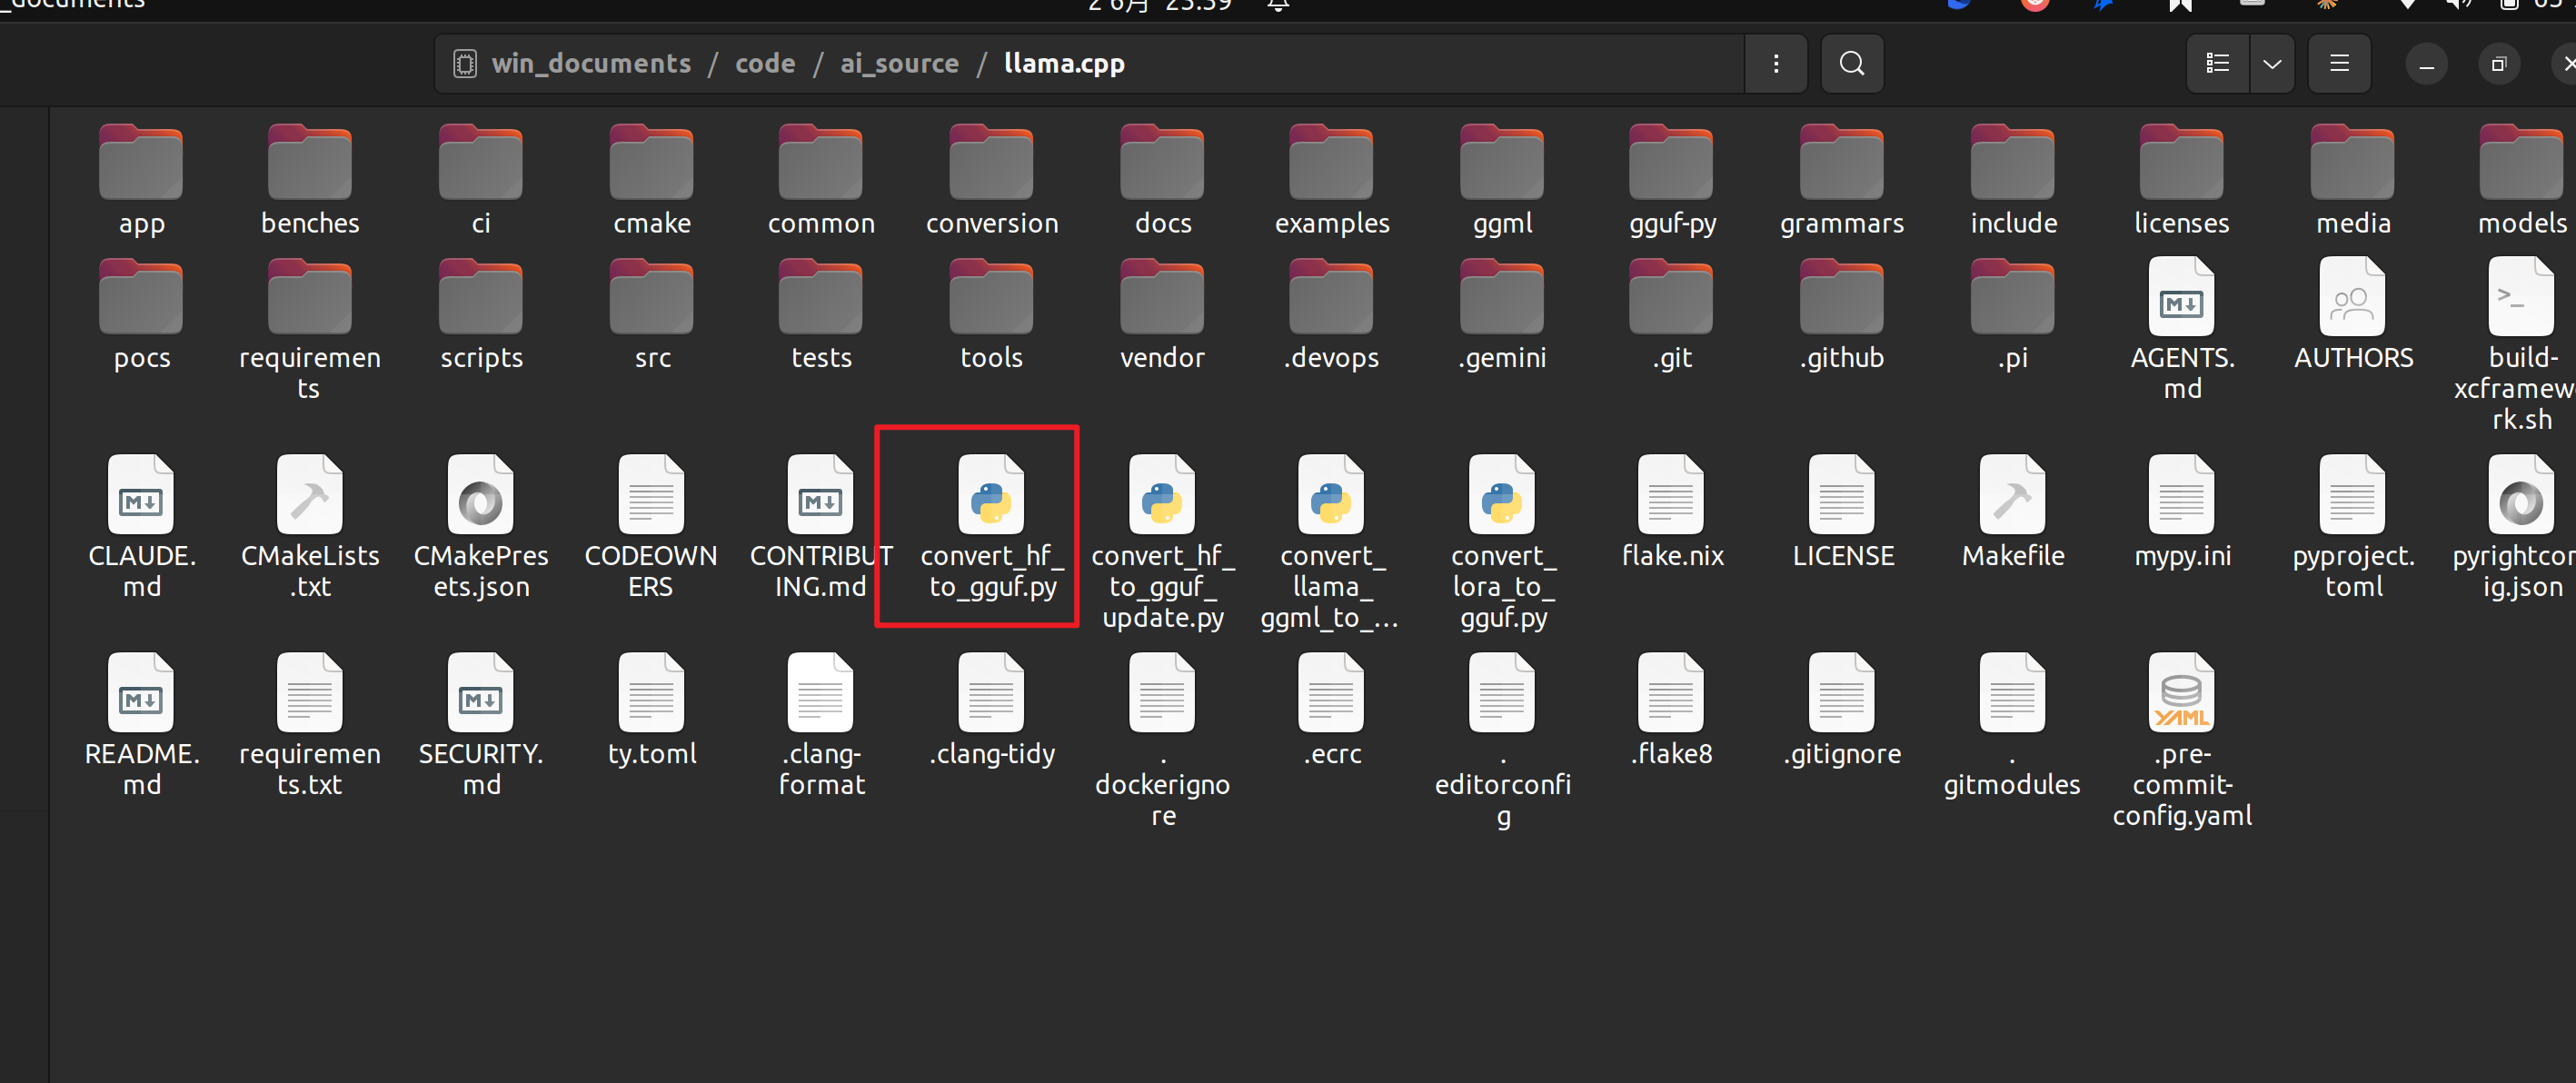
返回 llama.cpp 项目根目录,会有一个官方提供的 convert_hf_to_gguf.py 脚本,用于完成huggingface格式到gguf格式的转换.
- 查找convert_hf_to_gguf.py
- 启动转换
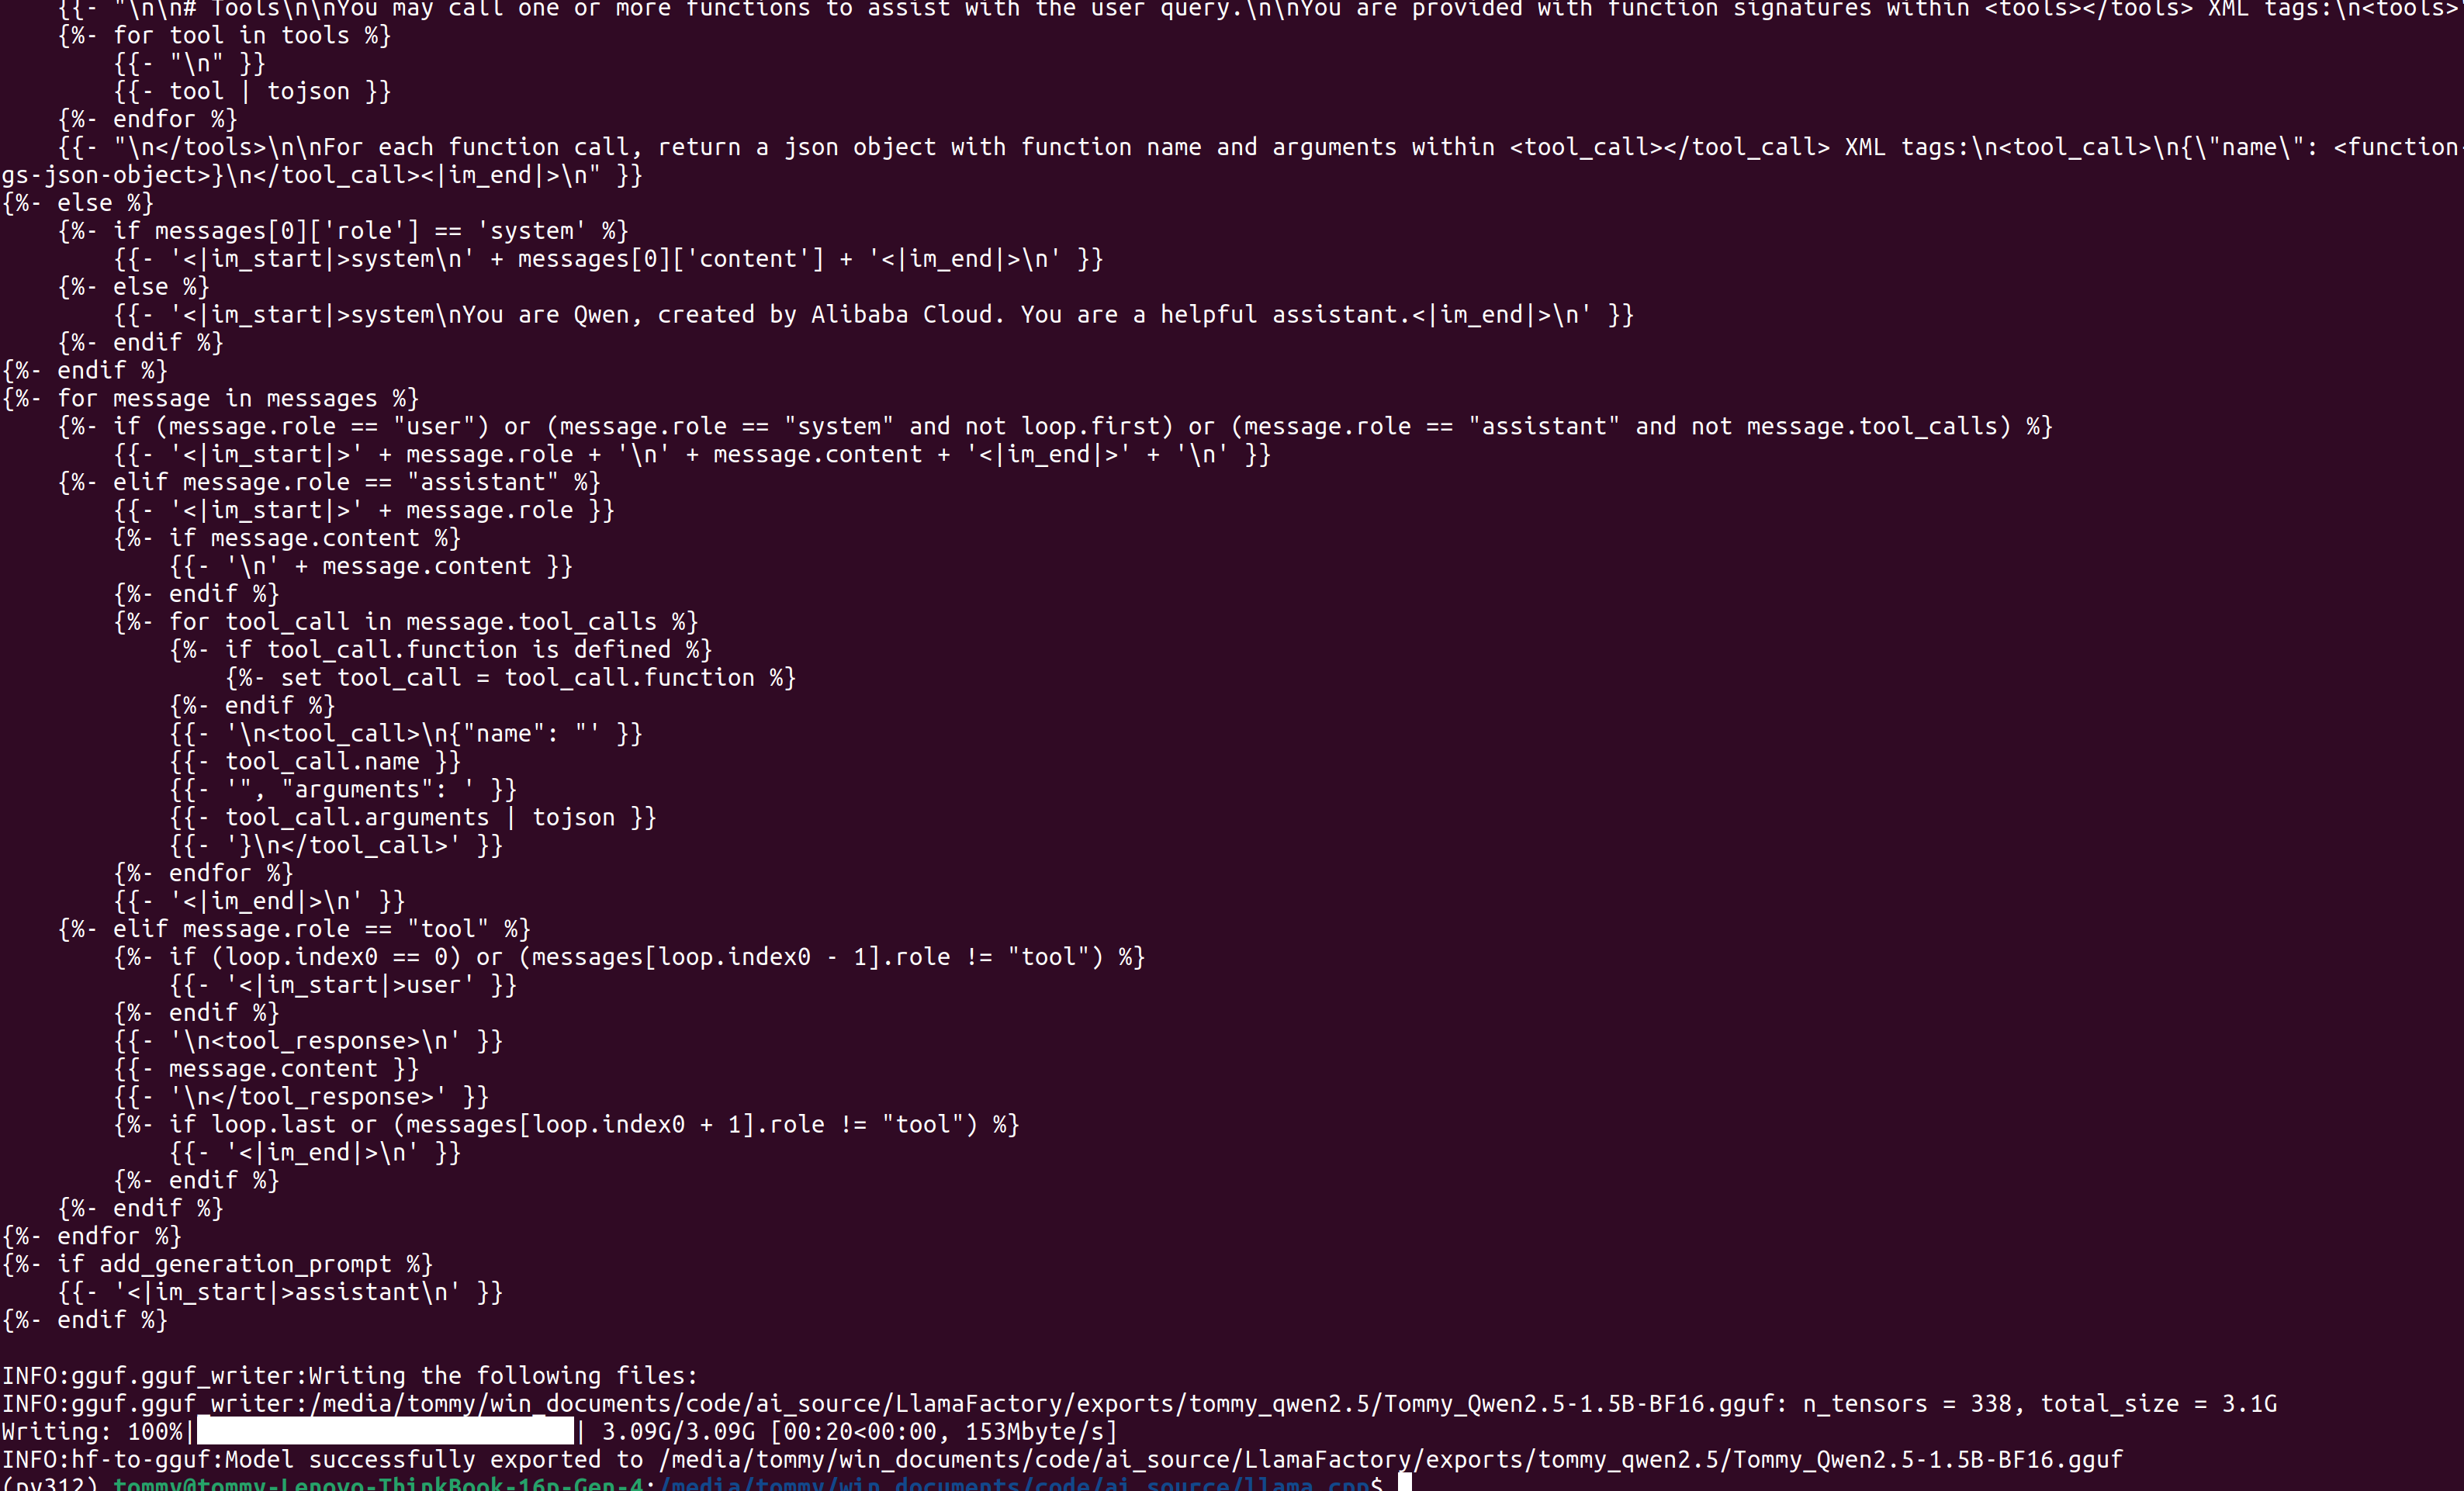
cd ..
python convert_hf_to_gguf.py /media/tommy/win_documents/code/ai_source/LlamaFactory/exports/tommy_qwen2.5- 转换中
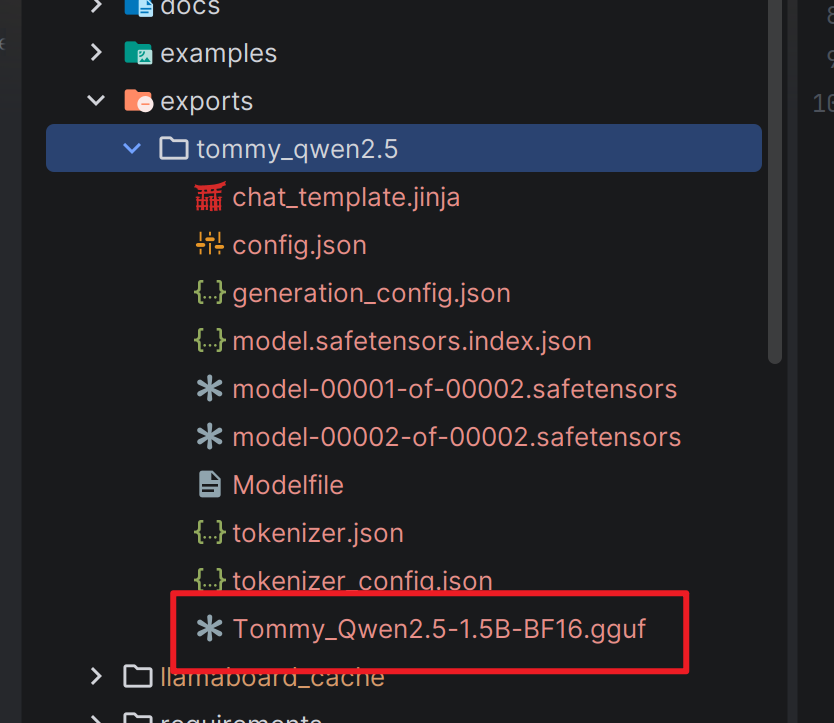
- 转换成功。
可在 megred-model-path 新模型的路径下查看gguf文件
11.4 Ollama安装
本文是linux环境,所以用了对应的下载和安装方式,如果是其他系统的用户可以按照 https://ollama.com/download 的说明完成下载安装
curl -fsSL https://ollama.com/install.sh | sh11.5 Modefile - 注册要部署的模型文件
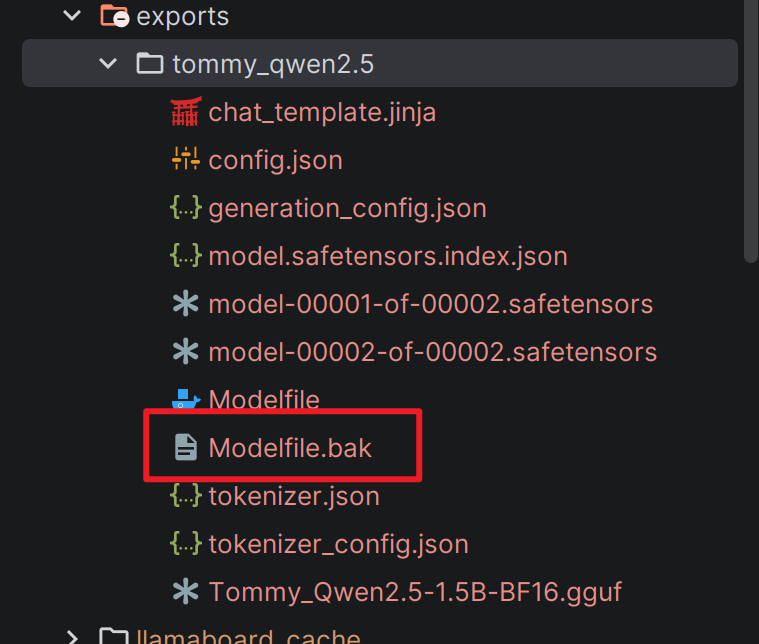
Ollama 对于要部署的模型需要提前完成本地的配置和注册, 和 Docker的配置很像, 在刚才的LoRA合并后目录可以找到。
- 备份旧的Modefile 为 Modefile.bak
- 创建一个 Modelfile 文件
# ollama modelfile auto-generated by llamafactory

# Ollama 模型配置文件
# 该文件定义了 Qwen2.5 模型的运行参数和对话模板
# 基于 ChatML 格式实现多轮对话交互
FROM /media/tommy/win_documents/code/ai_source/LlamaFactory/exports/tommy_qwen2.5/Tommy_Qwen2.5-1.5B-BF16.gguf

# 对话模板:使用 ChatML 格式
# 支持系统消息、用户消息和助手消息的结构化组织
# 模板逻辑:
# 1. 如果存在系统消息,以 <|im_start|>system 开头
# 2. 遍历所有消息,根据角色不同采用不同格式
#    - 用户消息:<|im_start|>user + 内容 + <|im_end|>
#    - 助手消息:内容 + <|im_end|>
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ range .Messages }}{{ if eq .Role "user" }}<|im_start|>user
{{ .Content }}<|im_end|>
<|im_start|>assistant
{{ else if eq .Role "assistant" }}{{ .Content }}<|im_end|>
{{ end }}{{ end }}"""

# 系统提示词:定义模型身份和行为准则
SYSTEM """You are Qwen, created by Alibaba Cloud. You are a helpful assistant."""

# 停止标记:当生成此标记时立即停止输出
PARAMETER stop "<|im_end|>"

# 上下文窗口大小:设置最大 token 数量为 4096
PARAMETER num_ctx 4096
#ollama create ollama模型自定义名 -f ollama模型配置文件
ollama create tommy_qwen2.5 -f ./Modelfile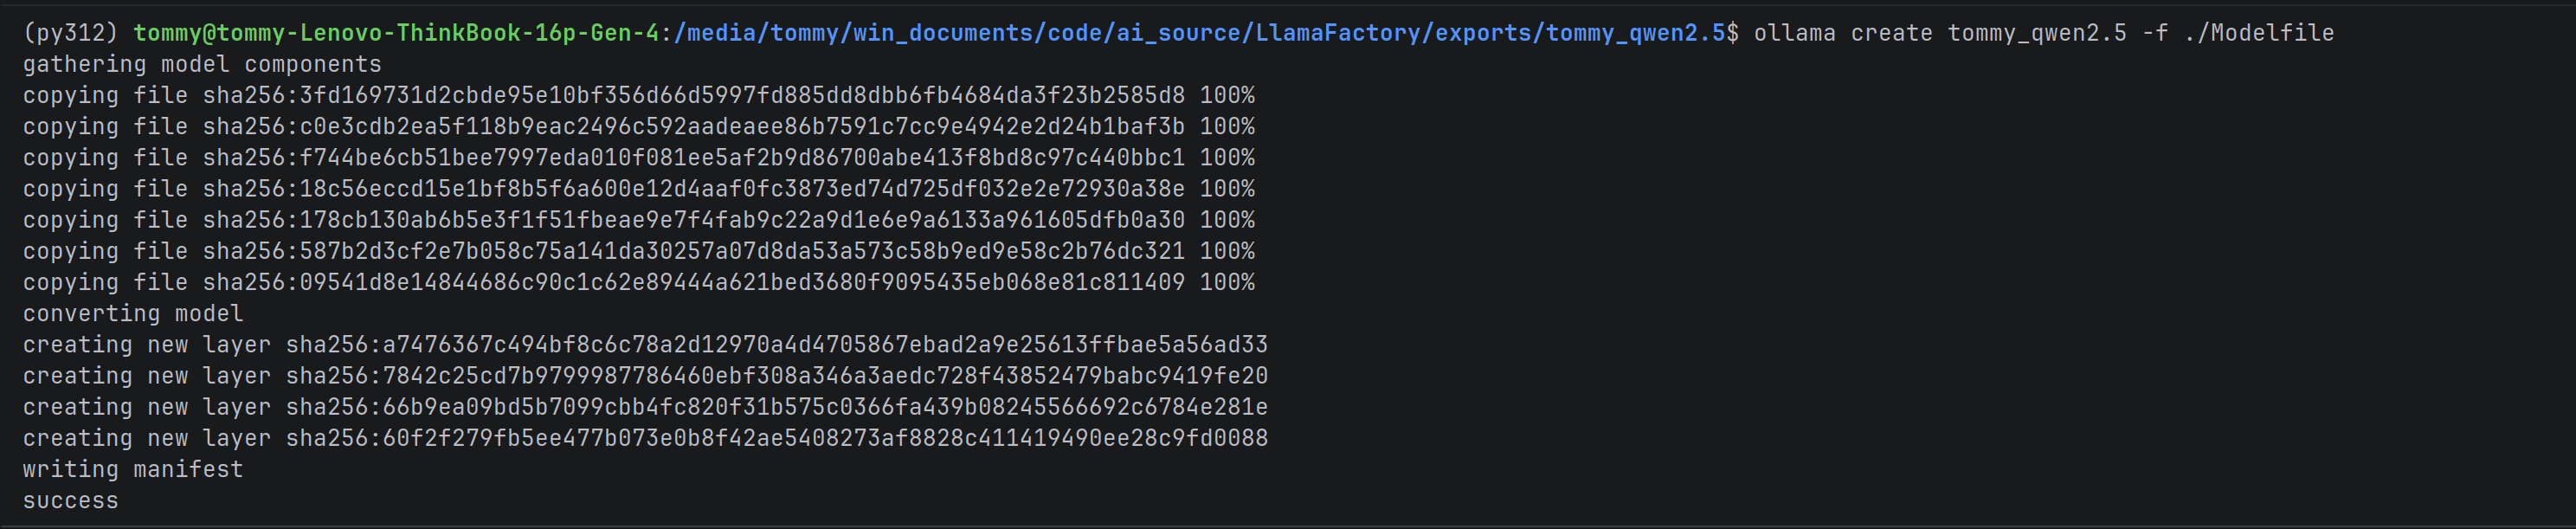
11.6 启动Ollama
即可通过ollama run 模型名称的方式,完成服务的启动
ollama run tommy_qwen2.5
启动后即可通过交互式完成问答,输入 /bye 即可退出